KI für EinsteigerAnleitung
Wie ein KI-Agent funktioniert: die Schleife, ausgeführt ohne API-Key
Ein KI-Agent ist eine Schleife: das Modell fordert ein Tool an, dein Code führt es aus, das Ergebnis geht zurück. Führe eine key-freie Python-Demo aus und richte sie dann auf ein echtes Modell.
Auf dieser Seite
Du bittest einen Coding-Agenten, einen Tippfehler zu beheben, und siehst zu, wie das Log scrollt: eine Datei lesen, suchen, eine weitere Datei lesen, bearbeiten, die Tests ausführen. Eine kleine Anfrage, ein Dutzend Modellaufrufe. Woher kommen sie?
Ein KI-Agent ist eine Schleife. Dein Programm sendet die Konversation an das Modell; das Modell antwortet entweder oder fordert ein Tool an („lies diese Datei“); dein Programm führt das Tool aus, fügt das Ergebnis der Konversation hinzu und ruft das Modell erneut auf. Das wiederholt sich, bis das Modell in Klartext antwortet. Coding-Agenten wie Claude Code, Codex und der Agent-Modus von Cursor sind um dieselbe Schleife herum gebaut, mit mehr Tools und mehr Sorgfalt. Im Folgenden führst du eine 40-Zeilen-Version ganz ohne Key aus und richtest sie dann auf ein echtes Modell.
Die Schleife in einem Bild#
Stell dir einen Manager vor, der nichts anfassen kann. Der Manager schreibt nur Notizen: „bitte bring mir todo.txt“. Ein Assistent (dein Programm) geht zum Regal, holt die Datei und legt sie auf den Schreibtisch. Der Manager liest sie und schreibt die nächste Notiz oder die endgültige Antwort.
Das ist der ganze Trick. Das Modell öffnet nie eine Datei und führt nie einen Befehl aus. Es schreibt Text, der sagt, welches Tool mit welchen Argumenten aufgerufen werden soll. Dein Code erledigt die Arbeit und meldet zurück. Wenn du Function Calling kennst, ist das derselbe Mechanismus, wiederholt, bis die Aufgabe erledigt ist.
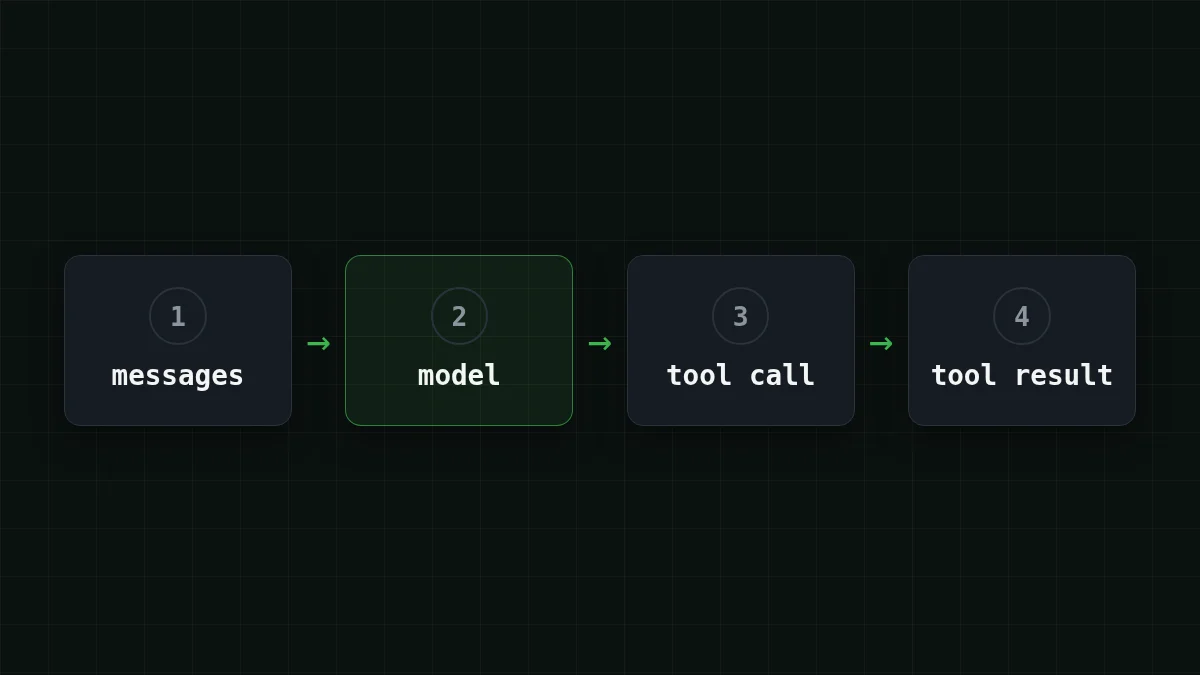
Kannst du eine Runde der Schleife in die richtige Reihenfolge bringen?
In die richtige Reihenfolge bringen
Eine Runde der Agent-Schleife in die richtige Reihenfolge bringen
Ziehe die Elemente oder benutze die Pfeile
- Die Aufgabe und die Tool-Liste an das Modell senden
- Das Modell antwortet mit einem Tool-Aufruf, nicht mit Text
- Dein Programm führt dieses Tool selbst aus
- Das Ergebnis geht als „tool“-Nachricht in die Nachrichten
- Das Modell wird mit dem Ergebnis erneut aufgerufen, bis es in Klartext antwortet
Ohne Key ausführen#
Sagen wir, die Aufgabe lautet: „Wie viele Einträge stehen in todo.txt?“. Das Tool ist eine Funktion read_file, die in einem kleinen Dictionary statt auf einer Festplatte nachsieht. Und statt eines echten Modells gibt es ein geskriptetes, das immer dieselben zwei Dinge tut: die Datei anfordern, dann antworten. Das reicht, um jedes bewegliche Teil zu sehen. Speichere dies als agent_loop.py (Python 3.10+, nur Standardbibliothek):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
Führe python agent_ aus. Ohne LLM_API_KEY in deiner Umgebung bekommst du das geskriptete Modell, und der Bildschirm zeigt genau zwei Runden:
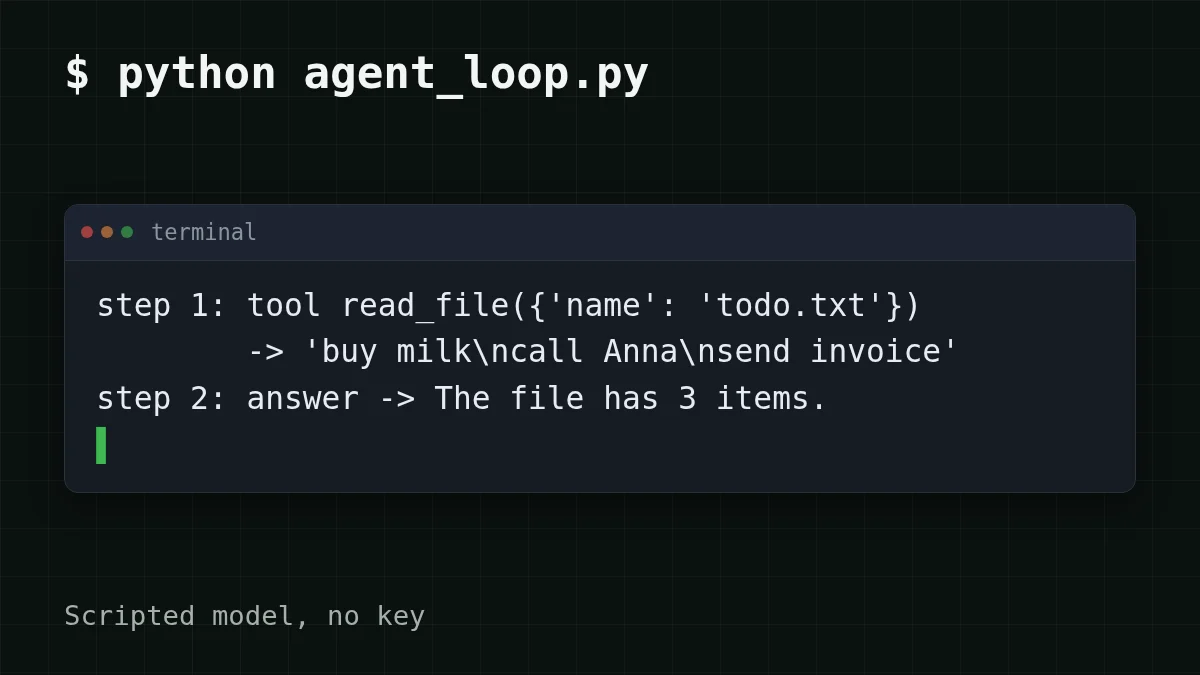
Sieh dir drei Zeilen an, denn sie enthalten die ganze Idee:
messages.behält den eigenen Turn des Modells. Lässt du ihn weg, enthält der nächste Aufruf ein Tool-Ergebnis, das auf eine Anfrage antwortet, die die API nie gesehen hat; die meisten APIs lehnen das mit einem 400 ab.append(reply) argumentskommt als JSON-String an, läuft also durchjson.loads, bevor du die Funktion aufrufst.max_stepsist die Notbremse. Ein Modell kann endlos Tools anfordern, deshalb hat jeder echte Agent ein solches Limit.
Dieselbe Schleife auf ein echtes Modell richten#
Nur eine Sache ändert sich: wer das Modell spielt. Das Skript liest drei Umgebungsvariablen, und wenn ein Key vorhanden ist, sendet es dieselben messages an einen OpenAI-kompatiblen Endpoint. Die CheapTokens-Adresse ist https:/ (kompatibel mit OpenAI Chat Completions und Anthropic Messages), und die Modell-ID muss die vollständige aus der Doku sein: deepseek-.
Die Schleife auf drei Arten ausführen
Kein Key
python agent_loop.pyDas geskriptete Modell spielt beide Runden. Nichts verlässt deinen Rechner.
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
Ein Kontextfenster von 380K und bis zu 32.768 Ausgabe-Tokens pro Antwort: Platz für eine lange Schleife.
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
Ein leichtes Modell mit einem Kontextfenster von 390K für einen ersten Lauf einer mehrstufigen Schleife.
Du solltest dieselbe Form wie zuvor sehen: step 1: tool read_, dann step 2: answer -, mit einer usage:-Zeile unter jedem Modellaufruf. Der Wortlaut der Antwort wird sich vom geskripteten unterscheiden, und ein gesprächiges Modell braucht vielleicht eine zusätzliche Runde. Das ist normal: das Modell entscheidet, die Schleife gehorcht nur. Halte den Key aus dem Skript selbst heraus; eine Umgebungsvariable ist der sichere Ort (hier steht, wie du ihn speicherst).
Die usage:-Zeilen sind der nützliche Teil. Addiere die in-Zahlen eines längeren Laufs, und du siehst, wohin das Geld fließt.
Warum jede Runde mehr kostet als die letzte#
Das Modell erinnert sich zwischen Aufrufen an nichts. Jede Runde sendet die gesamte messages-Liste erneut: die Aufgabe, jeden früheren Tool-Aufruf, jedes Tool-Ergebnis. (Dieselbe Regel macht einen langen Chat teuer; Multi-Turn-Chat zeigt es an einer einfachen Konversation.)
Runde 1 sendet eine Nachricht. Wenn die Schleife weiterläuft, sendet Runde 6 elf.
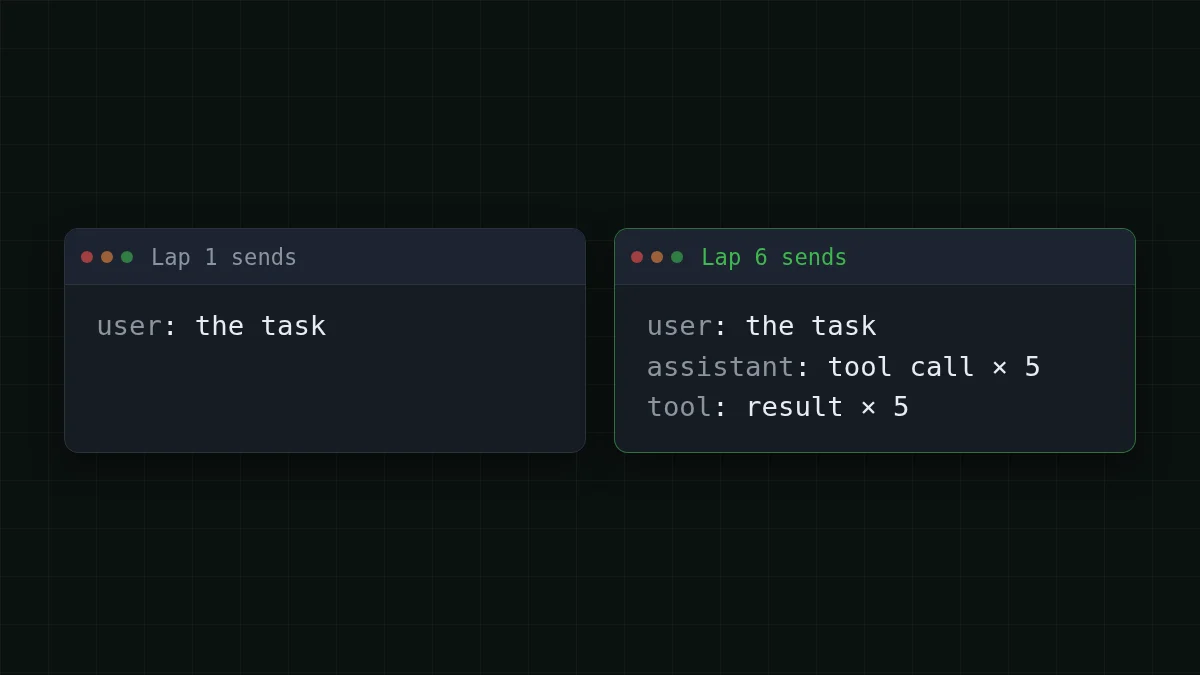
Sagen wir, eine echte Aufgabe dauert 10 Runden. Sie beginnt mit etwa 2.000 Tokens (Anweisungen, Tool-Liste, deine Anfrage), jede Runde fügt etwa 1.500 hinzu (ein Tool-Ergebnis plus die Notiz des Modells), und das Modell schreibt etwa 300 Tokens pro Runde. Runde 1 sendet 2.000, Runde 2 sendet 3.500, Runde 10 sendet 15.500. Die Summe des ersten Teils ist 10 × 2.000 = 20.000 Tokens; das Wachstum fügt 1.500 × 45 = 67.500 hinzu (45 ist 0+1+…+9), also beträgt der Input über die Aufgabe 20.000 + 67.500 = 87.500 Tokens. Der Output ist 10 × 300 = 3.000 Tokens.
Der Aufgabentext selbst sind ein paar Sätze, doch die Input-Seite umfasst 87.500 Tokens. Bei $0.015 pro 1M Input-Tokens kostet die ganze Aufgabe auf DeepSeek-V4-Flash $0.0016. Hier ist dieselbe Last über die Modelle, mit OpenRouter als Referenz. Insgesamt, Input und Output zusammengerechnet, ist CheapTokens bei dieser Last günstiger als OpenRouter:
| Modell | Input $/1M | Output $/1M | Kosten | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
87.500 Input- und 3.000 Output-Tokens insgesamt. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Ein Preis zu jeder Tageszeit hilft hier ebenfalls: ein Agent, der über Nacht läuft, kostet dasselbe wie einer am Mittag, und alle Preise siehst du auf der Preisseite. Für einen Tag solcher Aufgaben verschiebe die Regler:
Kostenrechner
Ein Tag: 20 Aufgaben mit je 10 Runden
Eingabe-Tokens pro Anfrage: 8.750 · Ausgabe-Tokens pro Anfrage: 300 · Anfragen pro Tag: 200
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
Die Felder gelten pro Modellaufruf: 8.750 ist der durchschnittliche Input einer Runde aus dem obigen Beispiel (87.500 ÷ 10), und 200 Aufrufe sind 20 Aufgaben × 10 Runden. Deshalb drehen sich Agent-Rechnungen um die Historie, nicht um die Frage. Das 20-Schritte-Beispiel geht tiefer auf denselben Effekt ein.
Kurzer Check
Runde 3 einer Agent-Schleife kostet mehr als Runde 1, obwohl du nichts Neues gefragt hast. Warum?
Antwort anzeigen
Antwort: Die Nachrichtenliste enthält jetzt zwei Tool-Aufrufe und zwei Ergebnisse, und all das wird erneut gesendet
Die API ist zustandslos. Jeder Aufruf trägt die vollständige Historie, also wachsen die Input-Tokens mit jeder Runde, während der Output etwa gleich bleibt.
Wohin von 40 Zeilen aus#
Das obige Skript ist eine Skizze zum Lernen. Wenn du die lange Version willst, gibt es einen offenen Kurs auf GitHub, justxor/agent-harness-course (README auf Russisch, geprüft am 31. Oktober 2026). Es ist reines Python 3.10+ ohne Abhängigkeiten, der Code steht unter MIT-Lizenz, der Text unter CC BY 4.0. Nach dem Klonen führt python examples/ die Schleife offline mit einem geskripteten Modell aus, und python - führt seine 19 Tests ohne Netzwerk aus. Der Kurs geht weiter mit Kontext-Kompaktierung, Memory, Subagenten, menschlicher Freigabe riskanter Aktionen und Kostenverfolgung. Für ein echtes Modell liest er LLM_PROVIDER, LLM_MODEL, LLM_API_KEY und für OpenAI-kompatible Endpoints LLM_BASE_URL: nimm den exakten LLM_PROVIDER-Wert aus seinem README.
Wenn die Schleife läuft, sind der nächste Schritt ein echter Key und eine echte Aufgabe: die Doku hat in einer Minute eine erste Anfrage, und DeepSeek-V4-Flash ist ein gutes Modell, um die Schleife darauf laufen zu lassen.


