AI cho người mớiHướng dẫn
Cách một AI agent hoạt động: vòng lặp, chạy không cần API key
Một AI agent là một vòng lặp: model yêu cầu một công cụ, mã của bạn chạy nó, kết quả quay lại. Chạy một bản demo Python không cần key, sau đó trỏ nó vào một model thật.
Trên trang này
Bạn yêu cầu một coding agent sửa một lỗi chính tả và nhìn log cuộn: đọc một file, tìm kiếm, đọc file khác, chỉnh sửa, chạy test. Một yêu cầu nhỏ, cả chục lần gọi model. Chúng đến từ đâu?
Một AI agent là một vòng lặp. Chương trình của bạn gửi cuộc hội thoại đến model; model hoặc trả lời hoặc yêu cầu một công cụ ("đọc file này"); chương trình của bạn chạy công cụ, thêm kết quả vào cuộc hội thoại và gọi model lần nữa. Nó lặp lại cho đến khi model trả lời bằng văn bản thuần. Các coding agent như Claude Code, Codex và chế độ agent của Cursor được xây dựng quanh chính vòng lặp này, với nhiều công cụ hơn và cẩn thận hơn. Dưới đây bạn sẽ chạy một phiên bản 40 dòng không cần key, sau đó trỏ nó vào một model thật.
Vòng lặp trong một bức tranh#
Hãy nghĩ đến một người quản lý không thể chạm vào bất cứ thứ gì. Người quản lý chỉ viết ghi chú: "làm ơn mang cho tôi todo.txt". Một trợ lý (chương trình của bạn) đi đến kệ, mang file và đặt lên bàn. Người quản lý đọc nó và viết ghi chú tiếp theo, hoặc câu trả lời cuối cùng.
Đó là toàn bộ mẹo. Model không bao giờ mở file hay chạy lệnh. Nó viết văn bản nói công cụ nào cần gọi và với đối số nào. Mã của bạn làm việc và báo lại. Nếu bạn đã thấy function calling, đây là cùng một cơ chế, lặp lại cho đến khi xong việc.
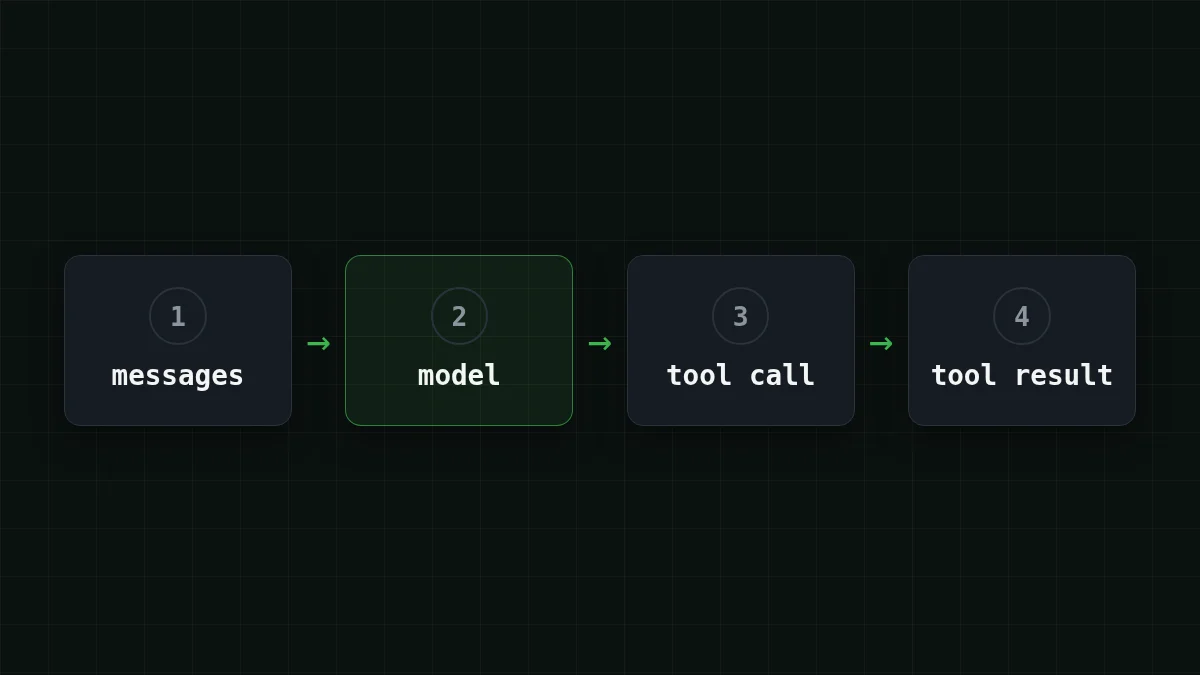
Bạn có thể xếp một vòng của vòng lặp theo đúng thứ tự không?
Sắp xếp thứ tự
Xếp một vòng của vòng lặp agent theo thứ tự
Kéo các mục hoặc dùng mũi tên
- Gửi nhiệm vụ và danh sách công cụ đến model
- Model trả lời bằng một lệnh gọi công cụ, không phải văn bản
- Chương trình của bạn tự chạy công cụ đó
- Kết quả đi vào tin nhắn dưới dạng tin nhắn "tool"
- Model được gọi lại với kết quả, cho đến khi nó trả lời bằng văn bản thuần
Chạy nó không cần key#
Giả sử nhiệm vụ là: "Có bao nhiêu mục trong todo.txt?". Công cụ là một hàm read_file tra trong một từ điển nhỏ thay vì đĩa. Và thay vì một model thật, có một model kịch bản luôn làm hai việc giống nhau: yêu cầu file, rồi trả lời. Thế là đủ để thấy mọi bộ phận chuyển động. Lưu cái này thành agent_loop.py (Python 3.10+, chỉ thư viện chuẩn):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
Chạy python agent_. Không có LLM_API_KEY trong môi trường, bạn nhận được model kịch bản, và màn hình hiện đúng hai vòng:
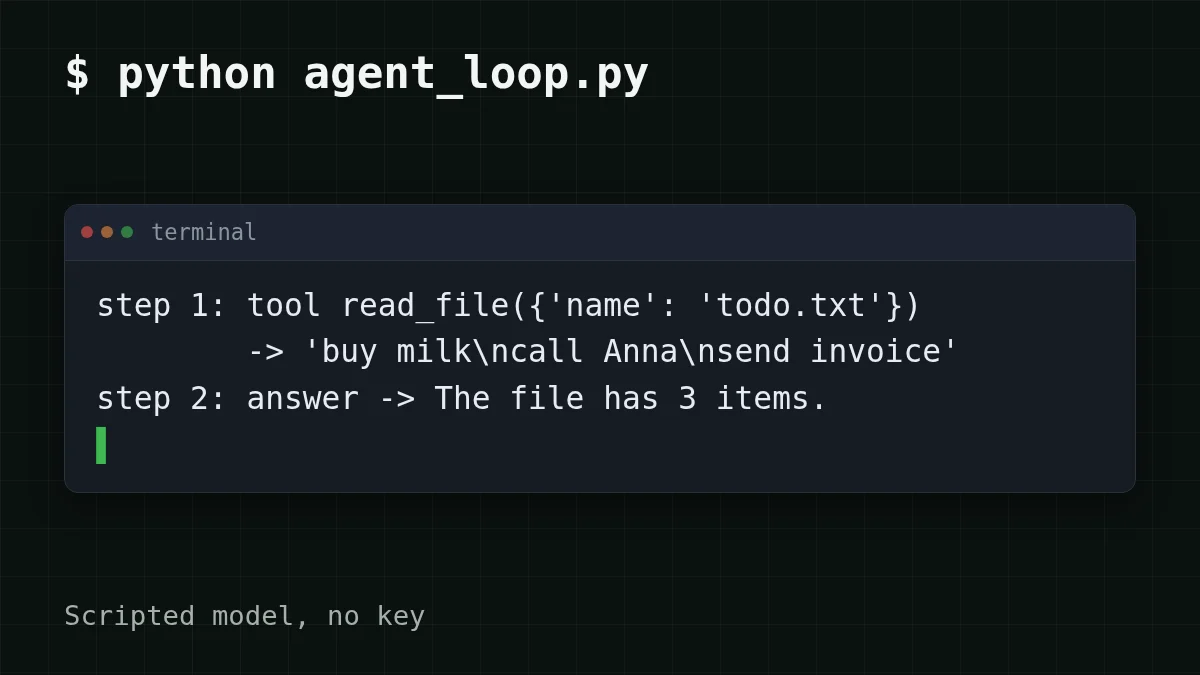
Hãy nhìn ba dòng, vì chúng chứa toàn bộ ý tưởng:
messages.giữ lượt của chính model. Bỏ qua nó, và lần gọi tiếp theo chứa một kết quả công cụ trả lời một yêu cầu mà API chưa từng thấy; hầu hết API từ chối điều đó với lỗi 400.append(reply) argumentsđến dưới dạng một chuỗi JSON, nên nó đi quajson.loadstrước khi bạn gọi hàm.max_stepslà phanh khẩn cấp. Một model có thể liên tục yêu cầu công cụ mãi mãi, nên mọi agent thật đều có giới hạn như thế này.
Trỏ cùng vòng lặp vào một model thật#
Chỉ một thứ thay đổi: ai đóng vai model. Script đọc ba biến môi trường, và nếu có key, nó gửi cùng messages đến một endpoint tương thích OpenAI. Địa chỉ CheapTokens là https:/ (tương thích OpenAI Chat Completions và Anthropic Messages), và id model phải là id đầy đủ từ tài liệu: deepseek-.
Chạy vòng lặp theo ba cách
Không key
python agent_loop.pyModel kịch bản đóng cả hai vòng. Không có gì rời khỏi máy bạn.
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
Cửa sổ ngữ cảnh 380K và tối đa 32.768 token đầu ra mỗi câu trả lời: đủ chỗ cho một vòng lặp dài.
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
Một model nhẹ với cửa sổ ngữ cảnh 390K cho lần chạy đầu của một vòng lặp nhiều bước.
Những gì bạn nên thấy có cùng hình dạng như trước: step 1: tool read_, rồi step 2: answer -, với một dòng usage: dưới mỗi lần gọi model. Cách diễn đạt câu trả lời sẽ khác bản kịch bản, và một model nói nhiều có thể mất thêm một vòng. Đó là bình thường: model quyết định, vòng lặp chỉ tuân theo. Giữ key ngoài chính script; biến môi trường là nơi an toàn (đây là cách lưu nó).
Các dòng usage: là phần hữu ích. Thêm các con số in của một lần chạy dài hơn và bạn sẽ thấy tiền đi đâu.
Tại sao mỗi vòng tốn hơn vòng trước#
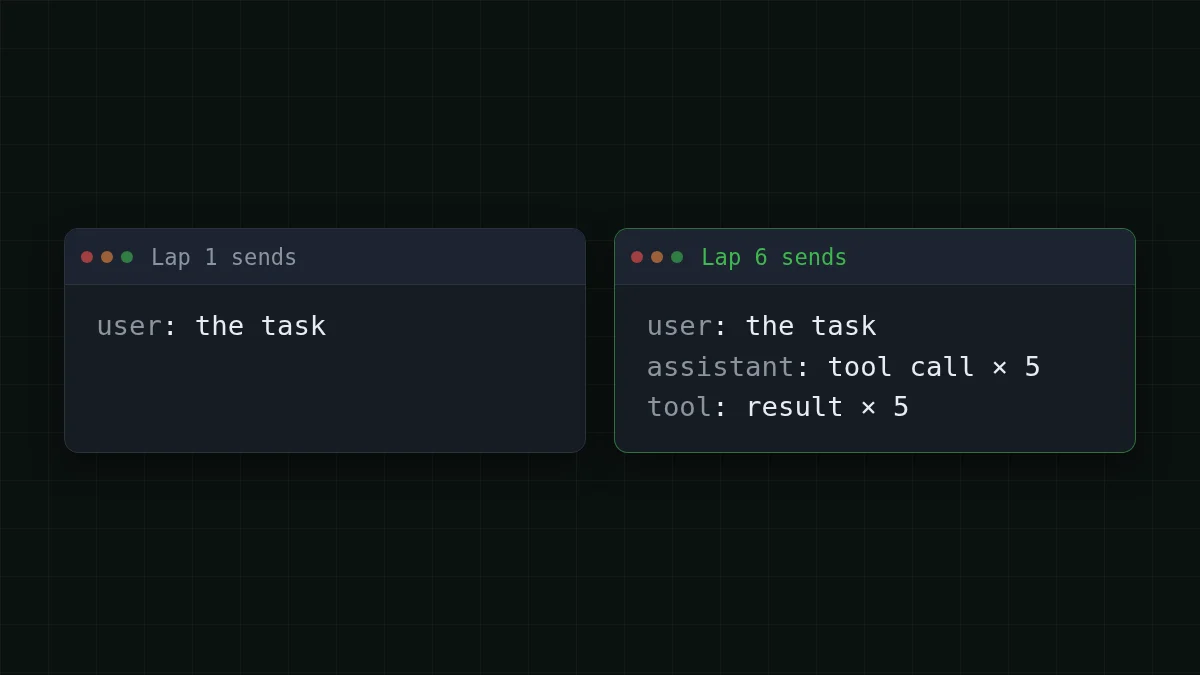
Model không nhớ gì giữa các lần gọi. Mỗi vòng gửi lại toàn bộ danh sách messages: nhiệm vụ, mọi lệnh gọi công cụ trước đó, mọi kết quả công cụ. (Cùng quy tắc đó làm một cuộc trò chuyện dài trở nên đắt; chat nhiều lượt cho thấy điều đó trên một cuộc hội thoại thường.)
Vòng 1 gửi một tin nhắn. Nếu vòng lặp tiếp tục, vòng 6 gửi mười một.
Giả sử một nhiệm vụ thật mất 10 vòng. Nó bắt đầu với khoảng 2.000 token (hướng dẫn, danh sách công cụ, yêu cầu của bạn), mỗi vòng thêm khoảng 1.500 (một kết quả công cụ cộng ghi chú của model), và model viết khoảng 300 token mỗi vòng. Vòng 1 gửi 2.000, vòng 2 gửi 3.500, vòng 10 gửi 15.500. Tổng của phần đầu là 10 × 2.000 = 20.000 token; phần tăng thêm cộng 1.500 × 45 = 67.500 (45 là 0+1+…+9), nên đầu vào cho nhiệm vụ là 20.000 + 67.500 = 87.500 token. Đầu ra là 10 × 300 = 3.000 token.
Bản thân văn bản nhiệm vụ chỉ vài câu, vậy mà phía đầu vào là 87.500 token. Với $0.015 mỗi 1M token đầu vào, toàn bộ nhiệm vụ trên DeepSeek-V4-Flash tốn $0.0016. Đây là cùng tải trên các model, với OpenRouter để tham khảo. Tổng cộng, tính cả đầu vào và đầu ra, CheapTokens rẻ hơn OpenRouter với tải này:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Chi phí | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
Tổng cộng 87.500 token đầu vào và 3.000 token đầu ra. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Một mức giá bất kể thời điểm trong ngày cũng hữu ích ở đây: một agent chạy qua đêm tốn như một agent chạy buổi trưa, và bạn có thể xem mọi giá trên trang giá. Cho một ngày với các nhiệm vụ như vậy, hãy di chuyển thanh trượt:
Máy tính chi phí
Một ngày: 20 nhiệm vụ, mỗi nhiệm vụ 10 vòng
Token đầu vào mỗi yêu cầu: 8.750 · Token đầu ra mỗi yêu cầu: 300 · Số yêu cầu mỗi ngày: 200
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
Các trường là trên mỗi lần gọi model: 8.750 là đầu vào trung bình của một vòng từ ví dụ trên (87.500 ÷ 10), và 200 lần gọi là 20 nhiệm vụ × 10 vòng. Đây là lý do hóa đơn agent chủ yếu là về lịch sử, không phải câu hỏi. Ví dụ 20 bước đi sâu hơn vào cùng hiệu ứng này.
Kiểm tra nhanh
Vòng 3 của một vòng lặp agent tốn hơn vòng 1, dù bạn không hỏi gì mới. Tại sao?
Hiện đáp án
Trả lời: Danh sách tin nhắn giờ chứa hai lệnh gọi công cụ và hai kết quả, và tất cả đều được gửi lại
API là stateless. Mỗi lần gọi mang theo toàn bộ lịch sử, nên token đầu vào tăng theo mỗi vòng trong khi đầu ra gần như giữ nguyên.
Đi tiếp từ 40 dòng#
Script trên là một bản phác thảo để học. Nếu bạn muốn phiên bản dài, có một khóa học mở trên GitHub, justxor/agent-harness-course (README bằng tiếng Nga, kiểm tra ngày 31 tháng 10 năm 2026). Nó là Python 3.10+ thuần không phụ thuộc, mã theo giấy phép MIT, văn bản theo CC BY 4.0. Sau khi clone, python examples/ chạy vòng lặp ngoại tuyến với một model kịch bản, và python - chạy 19 bài test của nó không cần mạng. Khóa học tiếp tục với nén ngữ cảnh, bộ nhớ, subagent, phê duyệt hành động rủi ro bởi con người, và theo dõi chi phí. Với một model thật, nó đọc LLM_PROVIDER, LLM_MODEL, LLM_API_KEY và, với các endpoint tương thích OpenAI, LLM_BASE_URL: lấy giá trị LLM_PROVIDER chính xác từ README của nó.
Khi vòng lặp hoạt động, bước tiếp theo là một key thật và một nhiệm vụ thật: tài liệu có một yêu cầu đầu tiên trong một phút, và DeepSeek-V4-Flash là một model tốt để chạy vòng lặp.


