Bắt đầuHướng dẫn
Trò chuyện đa lượt với API: gửi lại mảng tin nhắn
Mô hình không nhớ gì giữa các yêu cầu. Xây dựng một vòng lặp trò chuyện Python gửi lại mảng tin nhắn và xem token đầu vào tăng lên như thế nào.
Trên trang này
Câu hỏi thứ hai của bạn nhận được câu trả lời kỳ lạ vì API chưa bao giờ thấy câu hỏi đầu tiên. Mô hình không lưu giữ gì giữa các yêu cầu, vì vậy một cuộc trò chuyện là thứ bạn xây dựng: sau mỗi câu trả lời, bạn thêm nó vào một danh sách gọi là messages và gửi lại toàn bộ danh sách. Đó là toàn bộ mẹo, và dưới đây là một vòng lặp Python hoạt động cho nó với API tương thích OpenAI của CheapTokens.
Hai tài liệu chính thức mô tả cùng một điều. Tài liệu tham khảo API Messages của Anthropic (kiểm tra ngày 30 tháng 10 năm 2026) gọi API là không trạng thái và đa lượt: các lượt trước đó di chuyển trong tham số messages. Hướng dẫn tạo văn bản của OpenAI (kiểm tra ngày 30 tháng 10 năm 2026) nói rằng để giữ ngữ cảnh bằng cách gửi các lượt trước đó dưới dạng tin nhắn được gắn thẻ vai trò và thêm mỗi câu trả lời trước yêu cầu tiếp theo.
Tại sao câu hỏi thứ hai nhận được cái nhìn trống rỗng#
Giả sử bạn gõ What is a token?, đọc câu trả lời, và sau đó gõ Explain it shorter. Đối với bạn, "nó" là rõ ràng. Đối với API, yêu cầu số hai là một tin nhắn một dòng của người lạ: không có "nó", không có gì để rút ngắn. Bạn sẽ nhận được một phỏng đoán hoặc một câu hỏi lại, không phải một lời giải thích ngắn hơn.
Cách khắc phục là làm cho yêu cầu hai mang mọi thứ yêu cầu một đã có, cộng với câu trả lời, cộng với câu hỏi mới. So sánh hai payload:
So sánh
Yêu cầu 2, có và không có lịch sử
Không có lịch sử
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
Mô hình không biết "nó" là gì.
Có lịch sử
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
Bây giờ "nó" chỉ vào câu trả lời đầu tiên.
Ba vai trò làm tất cả công việc. system đặt ra các quy tắc một lần (giọng điệu, độ dài, bot dùng để làm gì). user là những gì người dùng đã gõ. assistant là những gì mô hình đã nói trước đó. Mô hình đọc danh sách từ trên xuống dưới và viết tin nhắn assistant tiếp theo.
Vòng lặp trò chuyện trong vài dòng#
Cài đặt SDK với pip install openai và giữ khóa của bạn trong một biến môi trường, như trong cách lưu trữ khóa API an toàn. URL cơ sở và id mô hình đến từ tài liệu CheapTokens và GET /v1/models (thêm trong liệt kê các mô hình để tìm id chính xác). Đối với một vòng lặp học tập, GLM-5.3-Flash là một lựa chọn tốt: ngữ cảnh 390K và tối đa 8.192 token đầu ra mỗi câu trả lời.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
Chạy nó, hỏi What is a token?, sau đó Explain it shorter. Câu trả lời thứ hai bây giờ đề cập đến câu trả lời đầu tiên. Dòng cuối cùng in usage., phía đầu vào của hóa đơn cho lượt đó; xem nó tăng lên với mỗi câu hỏi.
Thứ tự trong vòng lặp rất quan trọng, và đó là phần người mới thường làm sai nhất:
Sắp xếp thứ tự
Đặt một lượt của vòng lặp theo thứ tự
Kéo các mục hoặc dùng mũi tên
- Thêm câu hỏi của người dùng vào tin nhắn
- Gửi toàn bộ danh sách tin nhắn
- Đọc câu trả lời từ phản hồi
- Thêm câu trả lời dưới dạng tin nhắn trợ lý
Bỏ qua bước 4 và mô hình quên câu trả lời của chính nó, vì vậy "giải thích ngắn hơn" hoạt động một lần và sau đó lại hỏng ở câu hỏi thứ ba.
Danh sách trông như thế nào sau hai lượt#
Sau What is a token? và Explain it shorter, danh sách mà mã của bạn giữ có năm mục: quy tắc hệ thống, câu hỏi đầu tiên, câu trả lời đầu tiên, câu hỏi thứ hai, câu trả lời thứ hai. Yêu cầu tiếp theo sẽ gửi tất cả năm cộng với câu hỏi thứ ba.
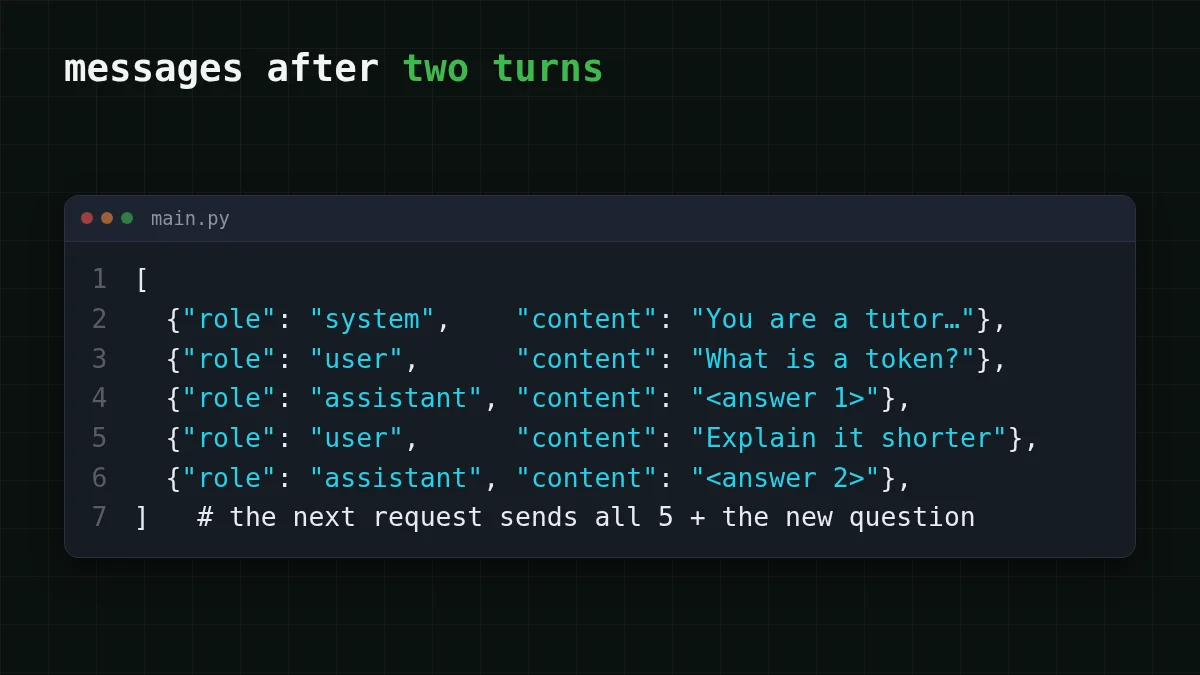
Tin nhắn hệ thống được gửi mỗi lần. API không "giữ" nó ở phía nó; nó chỉ là mục đầu tiên của danh sách. Hướng dẫn của OpenAI (kiểm tra ngày 30 tháng 10 năm 2026) lưu ý rằng các hướng dẫn chỉ áp dụng cho yêu cầu hiện tại, đó là cùng một ý tưởng từ hướng ngược lại. Nếu bạn muốn điều chỉnh tin nhắn đầu tiên đó, hãy xem giải thích về lời nhắc hệ thống và nhiệt độ.
Điều gì xảy ra với token đầu vào khi cuộc trò chuyện phát triển#
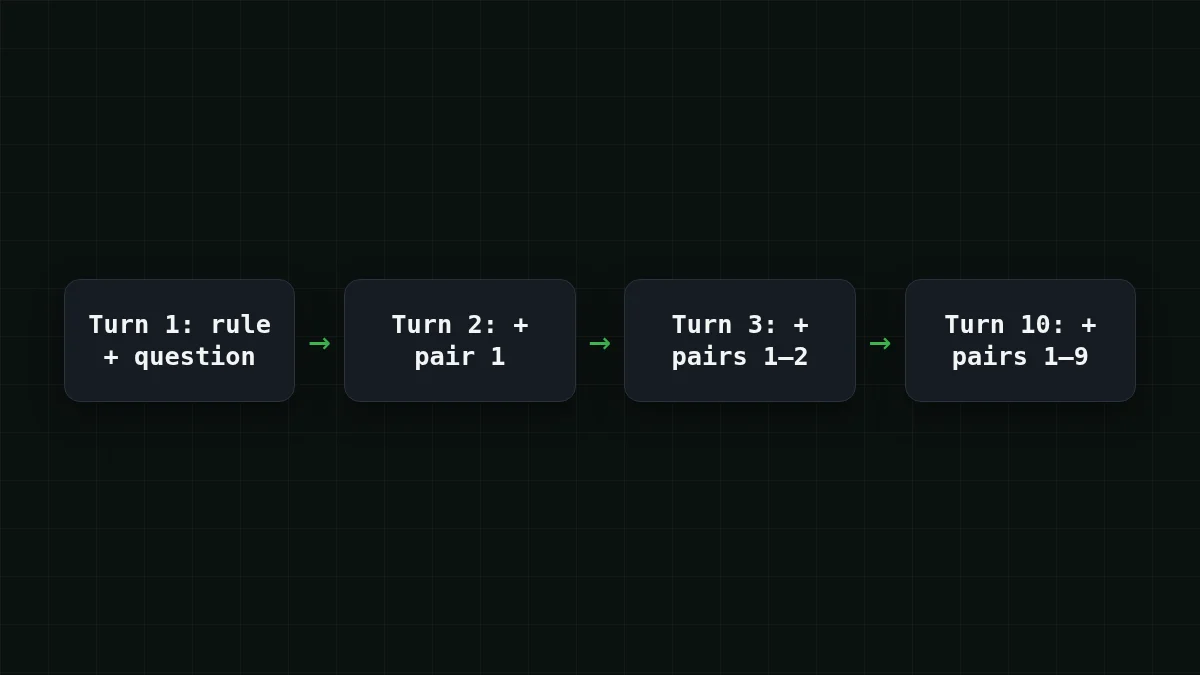
Mỗi yêu cầu phải trả cho toàn bộ danh sách một lần nữa dưới dạng đầu vào. Lượt 1 gửi quy tắc hệ thống và một câu hỏi; lượt 10 gửi quy tắc, chín cặp câu hỏi-trả lời trước đó và câu hỏi mới. Vì vậy đầu vào tăng lên với mỗi lượt, ngay cả khi mỗi tin nhắn của bạn ngắn.
Giả sử một cuộc trò chuyện 10 lượt với các giả định sau: quy tắc hệ thống khoảng 50 token, mỗi câu hỏi khoảng 150, mỗi câu trả lời khoảng 250. Lượt 1 gửi 50 + 150 = 200 token đầu vào. Mỗi lượt sau thêm một cặp 400 token nữa (150 + 250 = 400), vì vậy tổng đầu vào qua mười lượt là 200 × 10 + 400 × 45 = 20.000 token, trong đó 45 là 0 + 1 + … + 9. Đầu ra là 250 × 10 = 2.500 token. Mười tin nhắn từ bạn, và đầu vào gấp tám lần đầu ra.
Đây là toàn bộ cuộc trò chuyện đó được định giá theo giá trực tiếp, 20.000 token vào và 2.500 ra:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Chi phí | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
Tổng cộng 20.000 token đầu vào và 2.500 token đầu ra. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Trong tổng số, với đầu vào và đầu ra được tính cùng nhau, GLM-5.3-Flash và DeepSeek-V4-Flash có giá ở đây thấp hơn so với tại OpenRouter, và cả hai giữ một mức giá vào bất kỳ giờ nào. Nếu bạn muốn câu trả lời dài hơn 8.192 token trong cùng một vòng lặp trò chuyện, DeepSeek-V4-Flash cho phép tối đa 32.768 token đầu ra mỗi câu trả lời với ngữ cảnh 380K; thay id mô hình bằng deepseek- và không có gì khác trong vòng lặp thay đổi.
Câu chuyện chi phí sâu hơn nằm trong tại sao một cuộc trò chuyện AI dài lại tốn kém hơn; token đầu vào so với đầu ra giải thích tại sao hai bên được định giá riêng.
Kiểm tra nhanh
Cuộc trò chuyện của bạn đang ở lượt 8. Yêu cầu cho lượt 8 chứa gì?
Hiện đáp án
Trả lời: Tin nhắn hệ thống và mọi câu hỏi và câu trả lời trước đó, cộng với câu hỏi mới nhất
API không nhớ gì, vì vậy toàn bộ danh sách được gửi đi mỗi lần. Đó cũng là lý do tại sao token đầu vào tăng lên qua từng lượt.
Giữ một cuộc trò chuyện dài trong tầm kiểm soát#
Danh sách không thể phát triển mãi mãi: nó phải vừa với cửa sổ ngữ cảnh của mô hình (xem cửa sổ ngữ cảnh là gì), và mỗi lượt thêm tốn đầu vào. Hai thói quen giữ nó hợp lý cho một nguyên mẫu:
- Cắt bớt các lượt cũ nhất. Giữ tin nhắn hệ thống và vài cặp cuối cùng, ví dụ
messages = messages[:1] + messages[-trước mỗi yêu cầu. Bỏ các cặp cùng nhau để một câu hỏi không bao giờ mất câu trả lời của nó.8:] - Bắt đầu một danh sách mới cho một chủ đề mới. Một nhiệm vụ mới không cần lịch sử của nhiệm vụ cũ.
Một bot hỗ trợ với một bộ quy tắc tồn tại lâu dài là cùng một vòng lặp: tin nhắn hệ thống đặt ra các quy tắc một lần, mỗi lượt người dùng và câu trả lời được thêm vào, và bạn cắt bớt khi danh sách trở nên nặng. Đối với yêu cầu đầu tiên, hãy xem yêu cầu API đầu tiên của bạn với CheapTokens; danh sách mô hình và giá có trên trang định giá.


