البدءدليل
محادثة متعددة الأدوار مع API: أعد إرسال مصفوفة الرسائل
النموذج لا يتذكر شيئًا بين الطلبات. ابنِ حلقة محادثة Python تعيد إرسال مصفوفة الرسائل وشاهد كيف تنمو رموز الإدخال.
في هذه الصفحة
سؤالك الثاني يحصل على إجابة غريبة لأن الـ API لم يرَ سؤالك الأول قط. النموذج لا يحتفظ بشيء بين الطلبات، لذا فإن المحادثة شيء أنت تبنيه: بعد كل رد تُلحقه بقائمة تُسمى messages وتُرسل القائمة كاملة مرة أخرى. هذه هي الحيلة بأكملها، وفيما يلي حلقة Python عاملة لذلك مقابل واجهة CheapTokens المتوافقة مع OpenAI.
وثيقتان رسميتان تصفان الشيء نفسه. مرجع Anthropic's Messages API (تم التحقق منه في 30 أكتوبر 2026) يصف الـ API بأنه عديم الحالة ومتعدد الأدوار: الأدوار السابقة تنتقل في المعامل messages. دليل OpenAI لتوليد النصوص (تم التحقق منه في 30 أكتوبر 2026) يقول إنه للحفاظ على السياق تُرسل الأدوار السابقة كرسائل موسومة بالأدوار وتُلحق كل رد قبل الطلب التالي.
لماذا يحصل السؤال الثاني على نظرة فارغة#
لنفترض أنك تكتب What is a token?، وتقرأ الإجابة، ثم تكتب Explain it shorter. بالنسبة لك، "it" واضح. بالنسبة للـ API، الطلب رقم اثنين هو رسالة من سطر واحد من غريب: لا يوجد "it"، ولا شيء يمكن اختصاره. ستحصل على تخمين أو سؤال ردًا عليك، لا على شرح أقصر.
الحل هو أن يحمل الطلب الثاني كل ما حمله الطلب الأول، بالإضافة إلى الرد، بالإضافة إلى السؤال الجديد. قارن الحِملين:
قارن
الطلب 2، مع وبدون السجل
بدون سجل
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
النموذج لا يعرف ما هو "it".
مع سجل
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
الآن "it" يشير إلى الإجابة الأولى.
ثلاثة أدوار تقوم بكل العمل. system يضع القواعد مرة واحدة (النبرة، الطول، الغرض من البوت). user هو ما كتبه الشخص. assistant هو ما قاله النموذج سابقًا. يقرأ النموذج القائمة من الأعلى إلى الأسفل ويكتب رسالة assistant التالية.
حلقة المحادثة في بضعة أسطر#
ثبّت الـ SDK باستخدام pip install openai واحفظ مفتاحك في متغير بيئة، كما في كيفية تخزين مفتاح API بأمان. يأتي عنوان URL الأساسي ومعرّف النموذج من وثائق CheapTokens وGET /v1/models (المزيد في سرد النماذج للعثور على المعرّف الدقيق). لحلقة تعليمية، يُعد GLM-5.3-Flash خيارًا مناسبًا: سياق 390K وحتى 8,192 رمز إخراج لكل إجابة.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
شغّلها، واسأل What is a token?، ثم Explain it shorter. الإجابة الثانية تشير الآن إلى الأولى. السطر الأخير يطبع usage.، الجانب المدخلات من الفاتورة لذلك الدور؛ راقبه يرتفع مع كل سؤال.
الترتيب داخل الحلقة مهم، وهو الجزء الذي يخطئ فيه المبتدئون أكثر من غيره:
رتّب بالترتيب
رتّب دورًا واحدًا من الحلقة بالترتيب
اسحب العناصر أو استخدم الأسهم
- ألحق سؤال المستخدم بالرسائل
- أرسل قائمة الرسائل كاملة
- اقرأ الرد من الاستجابة
- ألحق الرد كرسالة مساعد
تخطَّ الخطوة 4 وسينسى النموذج إجاباته، لذا ستعمل "اشرحها أقصر" مرة واحدة ثم تتعطل مجددًا عند السؤال الثالث.
كيف تبدو القائمة بعد دورين#
بعد What is a token? وExplain it shorter، تحتوي القائمة التي يحتفظ بها كودك على خمسة عناصر: قاعدة النظام، السؤال الأول، الإجابة الأولى، السؤال الثاني، الإجابة الثانية. الطلب التالي سيرسل الخمسة كلها بالإضافة إلى السؤال الثالث.
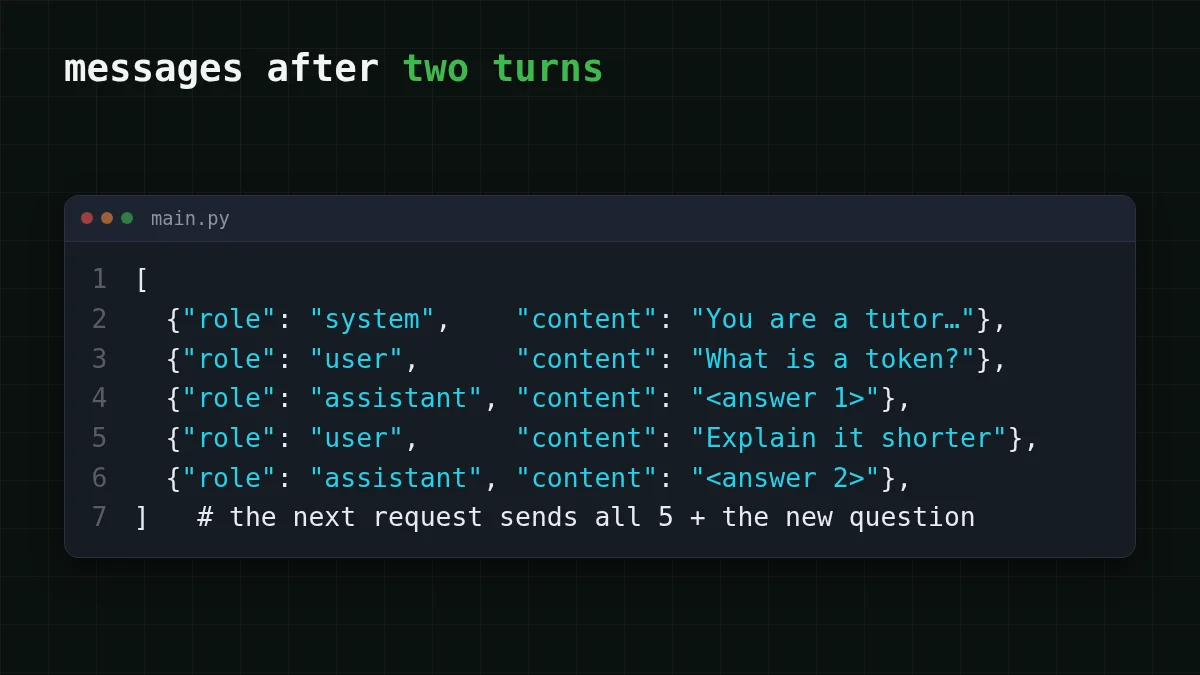
رسالة النظام تُرسل في كل مرة. الـ API لا "يحتفظ" بها من جهته؛ إنها فقط العنصر الأول من القائمة. يلاحظ دليل OpenAI (تم التحقق منه في 30 أكتوبر 2026) أن التعليمات تنطبق فقط على الطلب الحالي، وهي الفكرة نفسها من الاتجاه المعاكس. إذا أردت ضبط تلك الرسالة الأولى، راجع شرح system prompt وtemperature.
ماذا يحدث لرموز الإدخال مع نمو المحادثة#
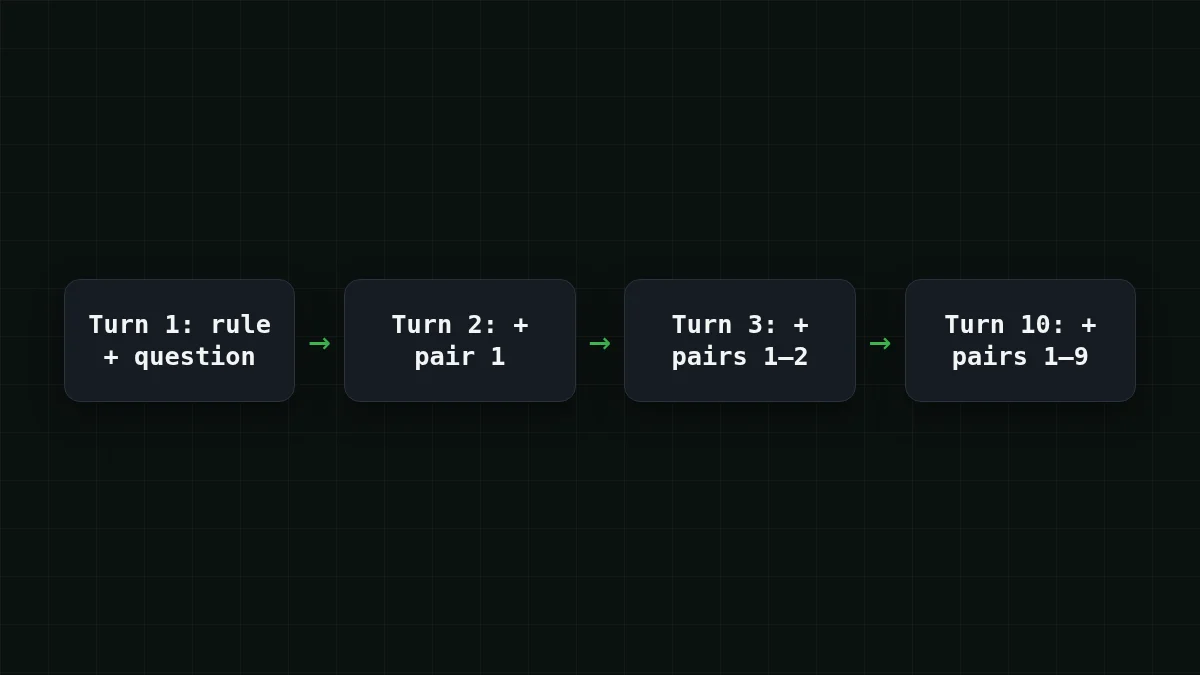
كل طلب يدفع مقابل القائمة كاملة مرة أخرى كإدخال. الدور 1 يرسل قاعدة النظام وسؤالًا واحدًا؛ الدور 10 يرسل القاعدة وتسعة أزواج سؤال وجواب سابقة والسؤال الجديد. لذا ينمو الإدخال مع كل دور، حتى لو كانت كل رسالة من رسائلك قصيرة.
لنفترض محادثة من 10 أدوار بهذه الافتراضات: قاعدة النظام حوالي 50 رمزًا، كل سؤال حوالي 150، كل رد حوالي 250. الدور 1 يرسل 50 + 150 = 200 رمز إدخال. كل دور لاحق يضيف زوجًا آخر من 400 رمز (150 + 250 = 400)، لذا إجمالي الإدخال على عشرة أدوار هو 200 × 10 + 400 × 45 = 20,000 رمز، حيث 45 هو 0 + 1 + … + 9. الإخراج هو 250 × 10 = 2,500 رمز. عشر رسائل منك، والإدخال ثمانية أضعاف الإخراج.
إليك تلك المحادثة كاملة مسعّرة بالأسعار الحية، 20,000 رمز إدخال و2,500 إخراج:
| النموذج | الإدخال $/1M | الإخراج $/1M | التكلفة | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
20,000 رمز إدخال و2,500 رمز إخراج إجمالًا. الأسعار لكل مليون رمز حالية وتتغير مع تعريفاتنا؛ يعرض عمود OpenRouter أسعارًا مرجعية لنفس حجم العمل.
في الإجمالي، مع احتساب الإدخال والإخراج معًا، يكلف GLM-5.3-Flash وDeepSeek-V4-Flash هنا أقل من OpenRouter، وكلاهما يحافظ على سعر واحد في أي ساعة. إذا أردت إجابات أطول من 8,192 رمزًا في حلقة المحادثة نفسها، يسمح DeepSeek-V4-Flash بما يصل إلى 32,768 رمز إخراج لكل إجابة مع سياق 380K؛ استبدل معرّف النموذج بـ deepseek- ولن يتغير أي شيء آخر في الحلقة.
قصة التكلفة الأعمق في لماذا تكلف محادثة AI الطويلة أكثر؛ رموز الإدخال مقابل الإخراج يشرح لماذا يُسعّر الجانبان بشكل منفصل.
فحص سريع
محادثتك في الدور 8. ماذا يحتوي طلب الدور 8؟
إظهار الإجابة
الإجابة: رسالة النظام وكل سؤال وإجابة سابقين، بالإضافة إلى السؤال الأحدث
الـ API لا يتذكر شيئًا، لذا تخرج القائمة كاملة في كل مرة. هذا أيضًا سبب ارتفاع رموز الإدخال دورًا بعد دور.
إبقاء محادثة طويلة تحت السيطرة#
لا يمكن للقائمة أن تنمو إلى الأبد: يجب أن تتسع لنافذة سياق النموذج (راجع ما هي نافذة السياق)، وكل دور إضافي يكلف إدخالًا. عادتان تحافظان عليها معقولة لنموذج أولي:
- قلّم أقدم الأدوار. احتفظ برسالة النظام وآخر بضعة أزواج، مثلًا
messages = messages[:1] + messages[-قبل كل طلب. أسقط الأزواج معًا حتى لا يفقد سؤال إجابته أبدًا.8:] - ابدأ قائمة جديدة لموضوع جديد. المهمة الجديدة لا تحتاج سجل القديمة.
بوت دعم بمجموعة قواعد طويلة العمر هو الحلقة نفسها: رسالة النظام تضع القواعد مرة واحدة، وكل دور مستخدم ورد يُلحق، وتقلّم عندما تصبح القائمة ثقيلة. للطلب الأول نفسه، راجع طلبك الأول من الـ API مع CheapTokens؛ قائمة النماذج والأسعار على صفحة الأسعار.


