الذكاء الاصطناعي للمبتدئيندليل
ما هي نافذة السياق في الذكاء الاصطناعي؟ ما يملؤها وماذا تفعل
نافذة السياق هي الذاكرة العاملة للنموذج لطلب واحد: موجهك، سجل المحادثة والإجابة. تعرف على ما يملؤها، وكيفية تقديرها، وثلاث عادات.
في هذه الصفحة
محادثتك عملت بشكل جيد لعشرين رسالة، والآن أصبحت الإجابات غامضة. الشيء الوحيد الذي ينمو مع كل رسالة هو نافذة السياق: الذاكرة العاملة للنموذج لطلب واحد. إنها تحتفظ بكل ما ترسله بالإضافة إلى الإجابة التي يكتبها النموذج، ولها حجم ثابت، على سبيل المثال 380K رمزًا لـ DeepSeek-V4-Flash.
ما هي نافذة السياق#
تخيل مكتبًا. يمكن للنموذج العمل فقط بما هو موجود على المكتب الآن: تعليماتك، المحادثة حتى الآن، مستند ملصق، والإجابة التي يكتبها. أي شيء ليس على المكتب لا وجود له بالنسبة له. توثيق Anthropic حول نوافذ السياق (تم التحقق في 27 أكتوبر 2026) يصفها بنفس الطريقة: النافذة هي كل النص الذي يمكن للنموذج الرجوع إليه عند توليد رد، بما في ذلك الرد نفسه، وهي منفصلة عن البيانات التي تم تدريب النموذج عليها.
المكتب له حجم ثابت، يُحسب بالرموز. الرمز هو قطعة نص، تقريبًا ¾ من كلمة إنجليزية؛ ما هو الرمز في الذكاء الاصطناعي يتعمق أكثر. إليك النماذج الثلاثة على CheapTokens ونوافذها:
- GLM-5.3-Flash: 390K رمزًا
- DeepSeek-V4-Flash: 380K رمزًا
- MiniMax-M2.7: 180K رمزًا
K تعني ألف. نافذة 380K تعادل حوالي 285,000 كلمة إنجليزية: 380,000 × 0.75 = 285,000. هذه بضع روايات على مكتب واحد، ومع ذلك تنفد أسرع مما تتوقع.
ما يُحتسب ضمنها#
كل شيء في الطلب يُحتسب، وليس فقط رسالتك الأخيرة:
- موجه النظام (التعليمات الدائمة)؛
- كل رسالة سابقة، رسائلك ورسائل النموذج؛
- تعريفات الأدوات ونتائج الأدوات، إذا كنت تستخدم وكيلًا أو إضافة محرر؛
- المستندات والصور التي ترفقها؛
- الإجابة نفسها، بما في ذلك أي تفكير يقوم به النموذج.
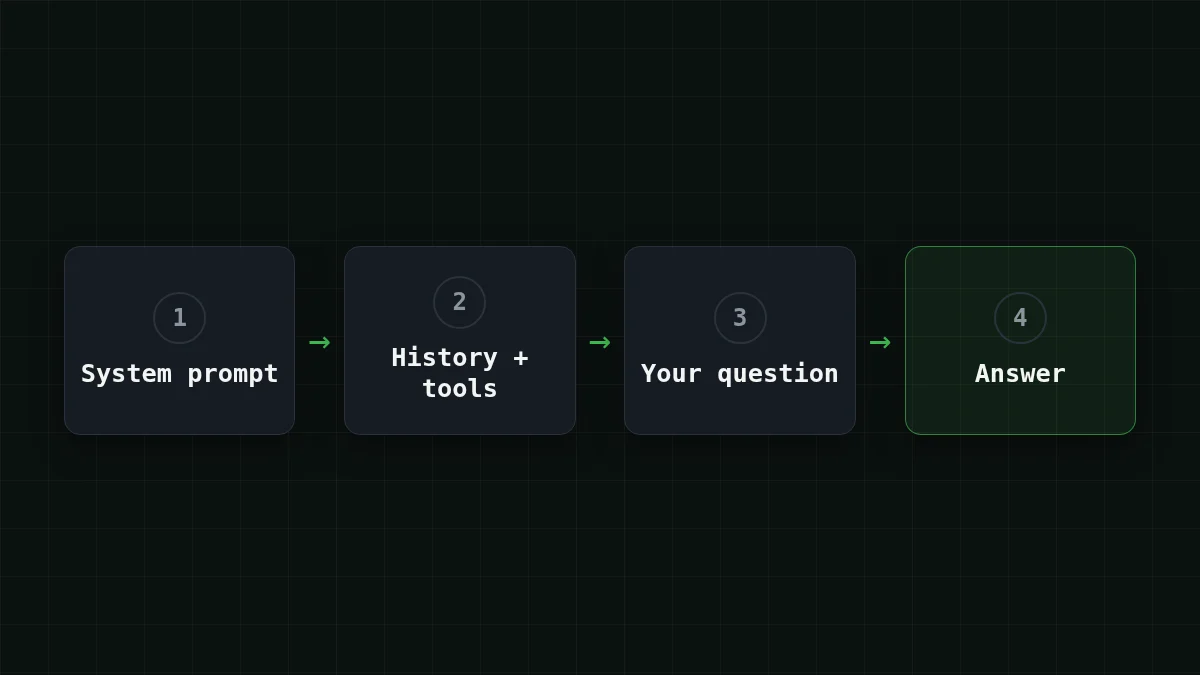
وكيل المحرر هو الحالة الخفية. في كل خطوة يرسل قائمة الأدوات مرة أخرى بالإضافة إلى كل ما قرأه حتى الآن. كتبت جملة واحدة؛ النافذة ترى أكثر بكثير.
لا تحتاج إلى تخمين الحجم. كل رد يحمل حقل usage مع أعداد الرموز. حلقة المحادثة البسيطة هذه (واجهة برمجة تطبيقات متوافقة مع OpenAI، معرّف النموذج من وثائق CheapTokens) تُظهر كلا الأمرين في آن واحد: السجل الكامل يُرسل في كل دور، والأعداد تعود.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
استدعِ ask() عشر مرات وراقب الرقم الأول وهو يتسلق. هذا التسلق هو قصة هذا المقال بأكملها.
النافذة مقابل الحد الأقصى للمخرجات: رقمان مختلفان#
كل صفحة نموذج تسرد حجمين، وغالبًا ما يخلط المبتدئون بينهما. النافذة هي المكتب بأكمله، المدخلات والمخرجات معًا. حد المخرجات هو طول الإجابة الواحدة: حتى 32,768 رمزًا لـ DeepSeek-V4-Flash، وحتى 8,192 لـ GLM-5.3-Flash و MiniMax-M2.7.
يتشاركان نفس المساحة. مهما استهلكت مدخلاتك، يجب أن تتسع الإجابة لما تبقى. إذا أردت رؤية كيف تبدو إجابة مقطوعة، لماذا تتوقف إجابة الذكاء الاصطناعي في منتصف الجملة يستعرض ذلك.
فحص سريع
DeepSeek-V4-Flash لديه نافذة 380K وحد مخرجات 32,768 رمزًا. ترسل 375K رمزًا من المدخلات. كم يمكن أن تكون الإجابة تقريبًا؟
إظهار الإجابة
الإجابة: حوالي 5K رمزًا، ما تبقى في النافذة
النافذة تغطي المدخلات والمخرجات معًا: 380K − 375K يترك حوالي 5K، وهو أقل من سقف 32,768.
لماذا تملأ محادثة طويلة النافذة (والفاتورة)#
النموذج لا يتذكر رسالتك الأخيرة. لمواصلة المحادثة، تتلقى واجهة برمجة التطبيقات السجل الكامل مرة أخرى في كل دور: الأدوار السابقة تُحفظ بالكامل، وتصبح إجابة النموذج جزءًا من المدخلات التالية. (تطبيقات المحادثة أحيانًا تُسقط أقدم الرسائل بهدوء؛ واجهة برمجة التطبيقات لا تفعل ذلك نيابة عنك.)
لنفترض أنك تتحدث مع مساعد دعم لمدة 30 دورًا. افترض موجه نظام بـ 400 رمز، و150 رمزًا لكل سؤال و450 لكل إجابة، لذا كل تبادل يضيف 600 رمز إلى السجل.
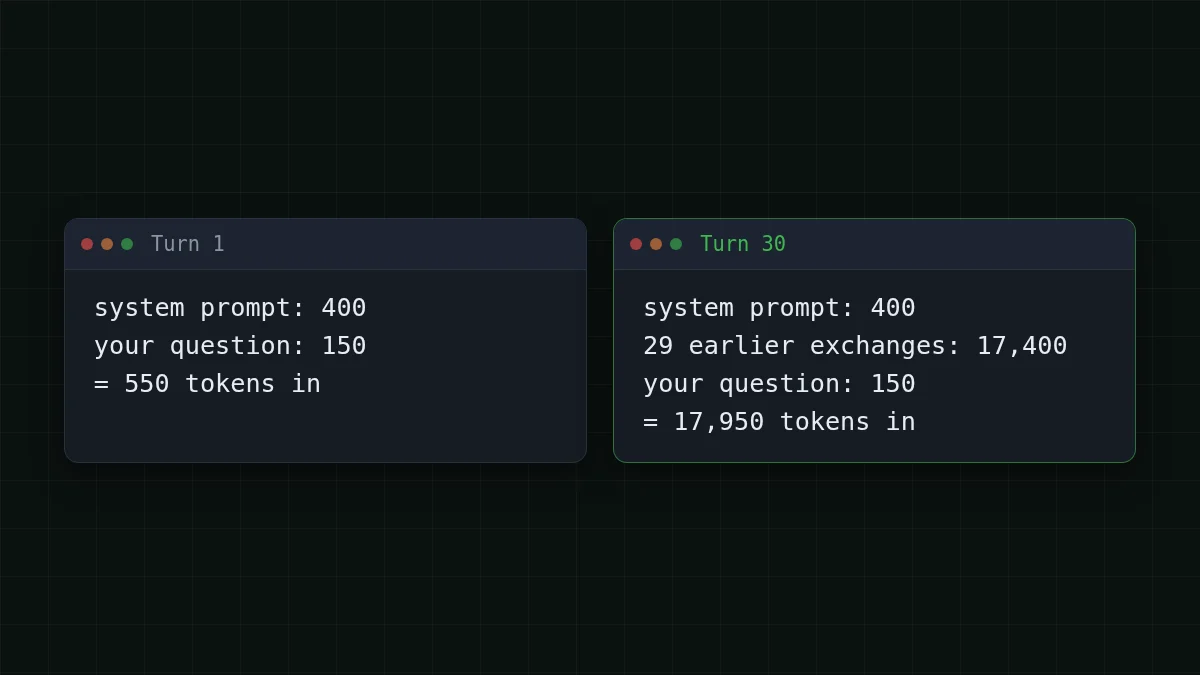
الدور 1 يرسل حوالي 550 رمزًا. الدور 30 يرسل 400 + 150 + 29 × 600 = 17,950. عند الجمع على مدار المحادثة بأكملها، كل دور يحمل 550 رمزًا من بدايته الخاصة، لذا 30 × 550 = 16,500. فوق ذلك، الدور n يعيد إرسال n − 1 تبادلًا سابقًا بـ 600 رمز لكل منها: 600 × 435 = 261,000، حيث 435 = 1 + 2 + … + 29. مدخلات المحادثة بأكملها هي 16,500 + 261,000 = 277,500 رمزًا، والإجابات تضيف 30 × 450 = 13,500.
على DeepSeek-V4-Flash تكلف هذه المحادثة بأكملها $0.0055. إليك النماذج الثلاثة، مع سعر OpenRouter المرجعي بجانبها؛ عند حساب المدخلات والمخرجات معًا، كل منها أرخص من OpenRouter لهذه المحادثة:
| النموذج | الإدخال $/1M | الإخراج $/1M | التكلفة | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
277,500 رمز إدخال و13,500 رمز إخراج إجمالًا. الأسعار لكل مليون رمز حالية وتتغير مع تعريفاتنا؛ يعرض عمود OpenRouter أسعارًا مرجعية لنفس حجم العمل.
بالمتوسط، هذه المحادثة هي 277,500 ÷ 30 = 9,250 رمزًا في كل طلب و450 خارج.
تريد محادثتك الخاصة؟ غيّر الأرقام أدناه، على سبيل المثال إلى 100 دور، وراقب مدى سرعة نمو الإجمالي.
حاسبة التكلفة
نفس المحادثة المكونة من 30 دورًا، بالمتوسط
رموز الإدخال لكل طلب: 9,250 · رموز الإخراج لكل طلب: 450 · الطلبات يوميًا: 30
| النموذج | يوميًا | شهريًا |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
الآن الجزء الصادق. 17,950 رمزًا أقل من 5% من نافذة 380K، لذا نادرًا ما تصل محادثة عادية إلى الحائط. ما ينمو هو الفاتورة والضجيج. يشير توثيق Anthropic إلى أن الدقة والاستدعاء تتدهور مع نمو عدد الرموز (يسمي هذا تعفن السياق)، لذا نافذة أكبر ليست أفضل تلقائيًا: ما تضعه يهم بقدر ما يتسع. حيث يظهر الحائط هو المستندات والوكلاء. على واجهة برمجة تطبيقات Anthropic نفسها، الطلب الذي تكون مدخلاته وحدها أكبر من النافذة يحصل على خطأ 400، الموجه طويل جدًا. لجانب التكلفة من نفس التأثير، انظر لماذا تكلف محادثة ذكاء اصطناعي طويلة أكثر.
هل سيتسع مستندي؟#
قاعدة تقريبية للنص الإنجليزي: الرمز الواحد حوالي ¾ من كلمة، لذا الرموز ≈ الكلمات ÷ 0.75. اللغات الأخرى عادة تأخذ رموزًا أكثر لكل كلمة، لذا اترك هامشًا إضافيًا. جربها قبل متابعة القراءة.
خمّن الرقم
كم عدد الرموز في كتاب من 90,000 كلمة؟
تخمينك
0300,000
إظهار الإجابة
الإجابة: 120,000
حوالي 120,000: 90,000 ÷ 0.75 = 120,000. يتسع في أي من النوافذ الثلاث مع مساحة إضافية.
الآن حالة أكبر. لنفترض أن لديك أرشيفًا من 150,000 كلمة من رسائل البريد الإلكتروني للدعم وتريد ملخصًا: 150,000 ÷ 0.75 = 200,000 رمزًا. 200,000 رمزًا أكثر من نافذة 180K، لذا لهذا الأرشيف اختر GLM-5.3-Flash (390K) أو DeepSeek-V4-Flash (380K). لا يزال DeepSeek-V4-Flash يترك 380,000 − 200,000 = 180,000 رمزًا من المساحة على DeepSeek-V4-Flash، أكثر من كافٍ لملخص تحت حد إجابته البالغ 32,768 رمزًا. قراءة تلك الـ 200,000 رمز وكتابة ملخص من 2,000 رمز تكلف $0.0032.
حالة أصغر: تقرير من 60,000 كلمة هو 60,000 ÷ 0.75 = 80,000 رمزًا. يتعامل معه MiniMax-M2.7 مع 100K فائضة، مما يجعل نافذته البالغة 180K كافية للمحادثات والمستندات متوسطة الحجم.
ثلاث عادات لنافذة شبه ممتلئة#
1. لخّص وأعد البدء. في الدور 30 يحمل الطلب 17,950 رمزًا. اطلب من النموذج كتابة ملخص من 200 رمز للقرارات حتى الآن، ثم ابدأ محادثة جديدة به. الطلب التالي هو 400 + 200 + 150 = 750 رمزًا مدخلات، ولا يزال النموذج يعرف ما يهم.
2. أرسل فقط الجزء الذي تحتاجه. الصق الفصل الذي تسأل عنه، وليس الكتاب بأكمله؛ الدالة، وليس المستودع بأكمله. أقل على المكتب يعني فاتورة أصغر، ووفقًا لملاحظة تعفن السياق من Anthropic، نموذجًا لديه أقل ليضيع فيه.
3. حافظ على الأجزاء الثابتة نحيفة وراقب usage. موجه النظام، تعريفات الأدوات ونتائج الأدوات الطويلة ترافق كل خطوة. قلّم ما لا تستخدمه، اطبع أعداد الرموز بعد كل رد كما في الحلقة أعلاه، واضبط max_tokens على الطول الذي تحتاجه فعليًا.
عندما تريد تجربة هذا على نموذج حقيقي، وثائق CheapTokens تعرض الطلب الأول في بضعة أسطر، وصفحة الأسعار تسرد السعر المباشر لكل نموذج. للمستندات الطويلة وحلقات الوكلاء، DeepSeek-V4-Flash (سياق 380K، حتى 32,768 رمز إخراج، سعر ثابت واحد بدون ساعات ذروة) و GLM-5.3-Flash (390K، أكبر نافذة من الثلاثة) هما أول ما يجب النظر إليه.


