AI dla początkującychPrzewodnik
Czym jest okno kontekstowe w AI? Co je zapełnia i co robić
Okno kontekstowe to pamięć robocza modelu dla jednego żądania: twój prompt, historia rozmowy i odpowiedź. Zobacz, co je zapełnia, jak je oszacować i trzy nawyki.
Na tej stronie
Twoja rozmowa działała dobrze przez dwadzieścia wiadomości, a teraz odpowiedzi stają się niejasne. Jedną z rzeczy, która rośnie z każdą wiadomością, jest okno kontekstowe: pamięć robocza modelu dla jednego żądania. Mieści wszystko, co wysyłasz, plus odpowiedź, którą pisze model, i ma stały rozmiar, na przykład 380K tokenów dla DeepSeek-V4-Flash.
Czym jest okno kontekstowe#
Wyobraź sobie biurko. Model może pracować tylko z tym, co jest teraz na biurku: twoimi instrukcjami, dotychczasową rozmową, wklejonym dokumentem i odpowiedzią, którą pisze. Cokolwiek nie leży na biurku, nie istnieje dla niego. Dokumentacja Anthropic dotycząca okien kontekstowych (sprawdzona 27 października 2026) ujmuje to tak samo: okno to cały tekst, do którego model może się odwołać, gdy generuje odpowiedź, w tym sama odpowiedź, i jest oddzielone od danych, na których model był trenowany.
Biurko ma stały rozmiar, liczony w tokenach. Token to fragment tekstu, w przybliżeniu ¾ angielskiego słowa; co to jest token w AI wyjaśnia to głębiej. Oto trzy modele na CheapTokens i ich okna:
- GLM-5.3-Flash: 390K tokenów
- DeepSeek-V4-Flash: 380K tokenów
- MiniMax-M2.7: 180K tokenów
K oznacza tysiąc. Okno 380K to około 285 000 angielskich słów: 380 000 × 0,75 = 285 000. To kilka powieści na jednym biurku, a mimo to kończy się szybciej, niż myślisz.
Co się do niego liczy#
Wszystko w żądaniu się liczy, nie tylko twoja ostatnia wiadomość:
- prompt systemowy (stałe instrukcje);
- każda wcześniejsza wiadomość, twoja i modelu;
- definicje narzędzi i wyniki narzędzi, jeśli używasz agenta lub wtyczki edytora;
- dokumenty i obrazy, które załączasz;
- sama odpowiedź, w tym wszelkie myślenie, które wykonuje model.
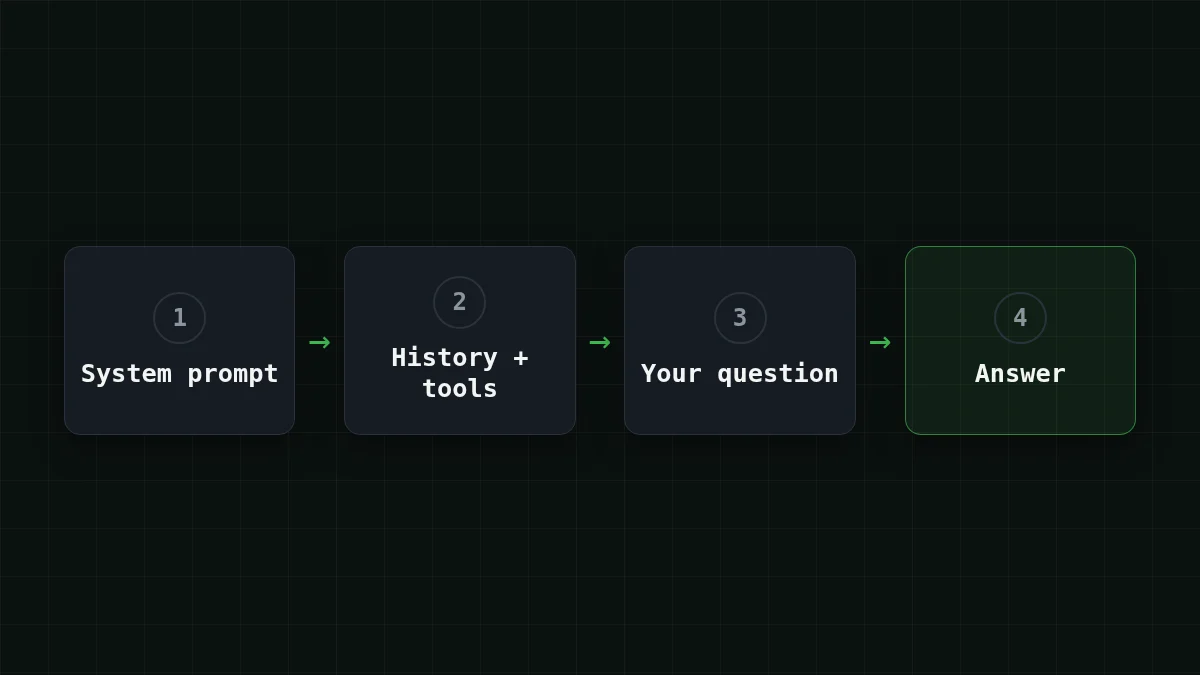
Agent edytora to podstępny przypadek. Na każdym kroku wysyła ponownie listę narzędzi plus wszystko, co do tej pory przeczytał. Wpisałeś jedno zdanie; okno widzi znacznie więcej.
Nie musisz zgadywać rozmiaru. Każda odpowiedź zawiera pole usage z liczbami tokenów. Ta minimalna pętla czatu (API zgodne z OpenAI, identyfikator modelu z dokumentacji CheapTokens) pokazuje obie rzeczy naraz: cała historia wychodzi w każdej turze, a liczby wracają.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
Wywołaj ask() dziesięć razy i obserwuj, jak rośnie pierwsza liczba. Ten wzrost to cała historia tego artykułu.
Okno a maksymalne wyjście: dwie różne liczby#
Każda strona modelu podaje dwa rozmiary, a początkujący często je mylą. Okno to całe biurko, wejście i wyjście razem. Limit wyjścia to maksymalna długość jednej odpowiedzi: do 32 768 tokenów dla DeepSeek-V4-Flash, do 8 192 dla GLM-5.3-Flash i MiniMax-M2.7.
Dzielą tę samą przestrzeń. Cokolwiek zajmie twoje wejście, odpowiedź musi zmieścić się w tym, co zostało. Jeśli chcesz zobaczyć, jak wygląda ucięta odpowiedź, dlaczego odpowiedź AI urywa się w połowie zdania przeprowadza przez to.
Szybkie sprawdzenie
DeepSeek-V4-Flash ma okno 380K i limit wyjścia 32 768 tokenów. Wysyłasz 375K tokenów wejścia. Mniej więcej jak długa może być odpowiedź?
Pokaż odpowiedź
Odpowiedź: Około 5K tokenów, czyli tyle, ile zostało w oknie
Okno obejmuje wejście i wyjście razem: 380K − 375K zostawia około 5K, co jest poniżej limitu 32 768.
Dlaczego długa rozmowa zapełnia okno (i rachunek)#
Model nie pamięta twojej ostatniej wiadomości. Aby podtrzymać rozmowę, API otrzymuje całą historię ponownie w każdej turze: poprzednie tury są zachowywane w całości, a odpowiedź modelu staje się częścią następnego wejścia. (Aplikacje czatowe czasami po cichu usuwają najstarsze wiadomości; API nie robi tego za ciebie.)
Załóżmy, że rozmawiasz z asystentem wsparcia przez 30 tur. Przyjmij prompt systemowy o długości 400 tokenów, 150 tokenów na pytanie i 450 na odpowiedź, więc każda wymiana dodaje 600 tokenów do historii.
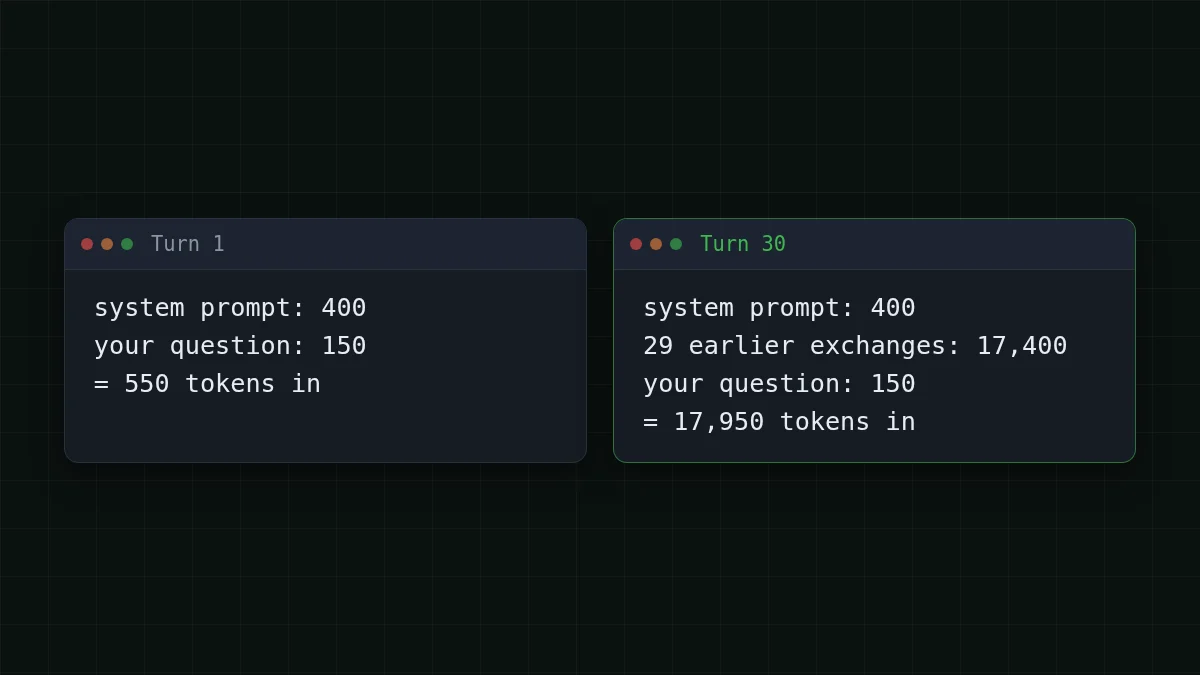
Tura 1 wysyła około 550 tokenów. Tura 30 wysyła 400 + 150 + 29 × 600 = 17 950. Sumując przez całą rozmowę, każda tura niesie 550 tokenów swojego początku, więc 30 × 550 = 16 500. Na dodatek tura n ponownie wysyła n − 1 wcześniejszych wymian po 600 tokenów każda: 600 × 435 = 261 000, gdzie 435 = 1 + 2 + … + 29. Wejście całej rozmowy to 16 500 + 261 000 = 277 500 tokenów, a odpowiedzi dodają 30 × 450 = 13 500.
W DeepSeek-V4-Flash cała ta rozmowa kosztuje $0.0055. Oto wszystkie trzy modele, z ceną referencyjną OpenRouter obok nich; licząc wejście i wyjście razem, każdy jest tańszy niż OpenRouter dla tej rozmowy:
| Model | Wejście $/1M | Wyjście $/1M | Koszt | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
277 500 tokenów wejściowych i 13 500 tokenów wyjściowych łącznie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Uśredniając, ta rozmowa to 277 500 ÷ 30 = 9 250 tokenów na żądanie i 450 na wyjściu.
Chcesz własną rozmowę? Zmień liczby poniżej, na przykład na 100 tur, i obserwuj, jak szybko rośnie suma.
Kalkulator kosztów
Ta sama 30-turowa rozmowa, uśredniona
Tokeny wejściowe na żądanie: 9250 · Tokeny wyjściowe na żądanie: 450 · Żądania dziennie: 30
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
Teraz uczciwa część. 17 950 tokenów to mniej niż 5% okna 380K, więc zwykła rozmowa rzadko uderza w ścianę. Rośnie rachunek i szum. Dokumentacja Anthropic zauważa, że dokładność i przywoływanie pogarszają się wraz ze wzrostem liczby tokenów (nazywa to gniciem kontekstu), więc większe okno nie jest automatycznie lepsze: to, co wkładasz, ma znaczenie tak samo jak to, ile się mieści. Ściana pojawia się przy dokumentach i agentach. W samym API Anthropic żądanie, którego samo wejście jest większe niż okno, otrzymuje błąd 400, prompt is too long. Aby poznać stronę kosztów tego samego efektu, zobacz dlaczego długa rozmowa z AI kosztuje więcej.
Czy mój dokument się zmieści?#
Przybliżona zasada dla tekstu angielskiego: jeden token to około ¾ słowa, więc tokeny ≈ słowa ÷ 0,75. Inne języki zwykle zużywają więcej tokenów na słowo, więc zostaw dodatkowy margines. Wypróbuj to przed dalszym czytaniem.
Zgadnij liczbę
Ile tokenów ma książka o 90 000 słów?
Twoje przypuszczenie
0300 000
Pokaż odpowiedź
Odpowiedź: 120 000
Około 120 000: 90 000 ÷ 0,75 = 120 000. Mieści się w każdym z trzech okien z zapasem.
Teraz większy przypadek. Załóżmy, że masz archiwum e-maili wsparcia o 150 000 słów i chcesz podsumowanie: 150 000 ÷ 0,75 = 200 000 tokenów. 200 000 tokenów to więcej niż okno 180K, więc dla tego archiwum wybierz GLM-5.3-Flash (390K) lub DeepSeek-V4-Flash (380K). DeepSeek-V4-Flash nadal zostawia 380 000 − 200 000 = 180 000 tokenów miejsca w DeepSeek-V4-Flash, więcej niż wystarczy na podsumowanie w ramach jego limitu odpowiedzi 32 768 tokenów. Przeczytanie tych 200 000 tokenów i napisanie podsumowania o 2 000 tokenów kosztuje $0.0032.
Mniejszy przypadek: raport o 60 000 słów to 60 000 ÷ 0,75 = 80 000 tokenów. MiniMax-M2.7 radzi sobie z nim, mając 100K zapasu, co sprawia, że jego okno 180K wystarcza na rozmowy i dokumenty średniej wielkości.
Trzy nawyki na prawie pełne okno#
1. Podsumuj i zacznij od nowa. W turze 30 żądanie niesie 17 950 tokenów. Poproś model o napisanie podsumowania decyzji o długości 200 tokenów, a następnie rozpocznij nową rozmowę z nim. Następne żądanie to 400 + 200 + 150 = 750 tokenów na wejściu, a model nadal wie, co się liczy.
2. Wysyłaj tylko potrzebną część. Wklej rozdział, o który pytasz, a nie całą książkę; funkcję, a nie całe repozytorium. Mniej na biurku oznacza mniejszy rachunek i, idąc za uwagą Anthropic o gniciu kontekstu, model, który ma mniej okazji się zgubić.
3. Utrzymuj stałe części w ryzach i obserwuj usage. Prompt systemowy, definicje narzędzi i długie wyniki narzędzi jadą z tobą na każdym kroku. Przytnij to, czego nie używasz, drukuj liczby tokenów po każdej odpowiedzi jak w pętli powyżej i ustaw max_tokens na długość, której naprawdę potrzebujesz.
Gdy chcesz wypróbować to na prawdziwym modelu, dokumentacja CheapTokens pokazuje pierwsze żądanie w kilku linijkach, a strona z cenami wymienia aktualną cenę każdego modelu. W przypadku długich dokumentów i pętli agentów najpierw warto spojrzeć na DeepSeek-V4-Flash (kontekst 380K, do 32 768 tokenów wyjścia, jedna stała cena bez godzin szczytu) i GLM-5.3-Flash (390K, największe okno z trzech).


