AI में कॉन्टेक्स्ट विंडो क्या है? इसे क्या भरता है और क्या करें
कॉन्टेक्स्ट विंडो एक अनुरोध के लिए मॉडल की कार्यशील स्मृति है: आपका प्रॉम्प्ट, चैट इतिहास और उत्तर। देखें इसे क्या भरता है, इसका अनुमान कैसे लगाएँ, और तीन आदतें।
इस पृष्ठ पर
आपकी चैट बीस संदेशों तक ठीक चली, और अब उत्तर अस्पष्ट होने लगे हैं। हर संदेश के साथ एक चीज़ बढ़ती जाती है: कॉन्टेक्स्ट विंडो, यानी एक अनुरोध के लिए मॉडल की कार्यशील स्मृति। इसमें वह सब कुछ होता है जो आप भेजते हैं और वह उत्तर भी जो मॉडल लिखता है, और इसका आकार निश्चित होता है, उदाहरण के लिए DeepSeek-V4-Flash के लिए 380K टोकन।
कॉन्टेक्स्ट विंडो क्या है#
एक मेज़ की कल्पना करें। मॉडल केवल उसी चीज़ के साथ काम कर सकता है जो इस समय मेज़ पर है: आपके निर्देश, अब तक की बातचीत, चिपकाया गया दस्तावेज़ और वह उत्तर जो वह लिख रहा है। जो चीज़ मेज़ पर नहीं है, उसका उसके लिए कोई अस्तित्व नहीं है। कॉन्टेक्स्ट विंडो पर Anthropic का दस्तावेज़ (27 अक्टूबर 2026 को जाँचा गया) इसे इसी तरह कहता है: विंडो वह सारा टेक्स्ट है जिसे मॉडल उत्तर उत्पन्न करते समय संदर्भित कर सकता है, जिसमें उत्तर भी शामिल है, और यह उस डेटा से अलग है जिस पर मॉडल को प्रशिक्षित किया गया था।
मेज़ का आकार निश्चित होता है, जिसे टोकन में गिना जाता है। एक टोकन टेक्स्ट का एक टुकड़ा है, मोटे तौर पर एक अंग्रेज़ी शब्द का ¾; AI में टोकन क्या है इस पर और गहराई से बताता है। यहाँ CheapTokens पर तीन मॉडल और उनकी विंडो हैं:
- GLM-5.3-Flash: 390K टोकन
- DeepSeek-V4-Flash: 380K टोकन
- MiniMax-M2.7: 180K टोकन
K का मतलब हज़ार है। 380K विंडो लगभग 285,000 अंग्रेज़ी शब्दों की होती है: 380,000 × 0.75 = 285,000। यह एक मेज़ पर कुछ उपन्यासों जितना है, और फिर भी यह आपकी सोच से कहीं तेज़ी से खत्म हो जाती है।
इसमें क्या गिना जाता है#
अनुरोध में सब कुछ गिना जाता है, केवल आपका अंतिम संदेश नहीं:
- सिस्टम प्रॉम्प्ट (स्थायी निर्देश);
- हर पिछला संदेश, आपका और मॉडल का;
- टूल परिभाषाएँ और टूल परिणाम, यदि आप एजेंट या एडिटर प्लगइन का उपयोग करते हैं;
- आपके द्वारा संलग्न दस्तावेज़ और छवियाँ;
- उत्तर स्वयं, जिसमें मॉडल की कोई भी सोच शामिल है।
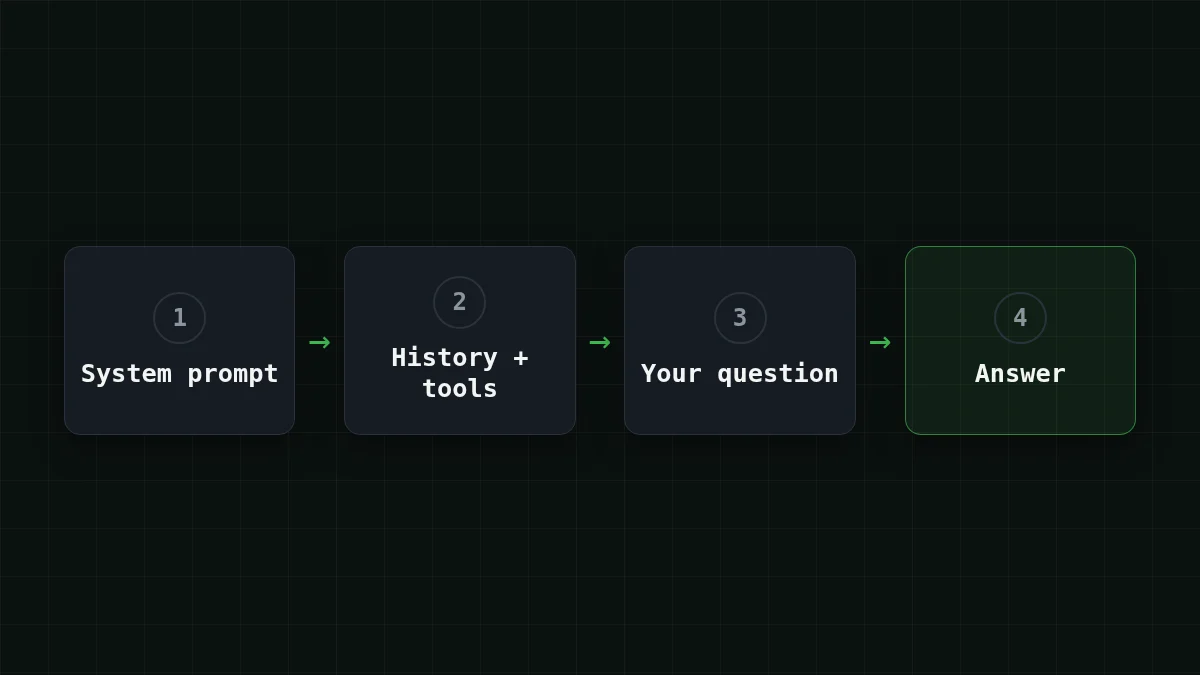
एडिटर एजेंट चालाक मामला है। हर चरण में यह टूल सूची फिर से भेजता है और साथ में वह सब कुछ जो उसने अब तक पढ़ा है। आपने एक वाक्य टाइप किया; विंडो बहुत अधिक देखती है।
आपको आकार का अनुमान लगाने की ज़रूरत नहीं है। प्रत्येक प्रतिक्रिया में टोकन गणना के साथ एक usage फ़ील्ड होता है। यह न्यूनतम चैट लूप (OpenAI-संगत API, मॉडल आईडी CheapTokens दस्तावेज़ों से) दोनों चीज़ें एक साथ दिखाता है: पूरा इतिहास हर बार बाहर जाता है, और गणनाएँ वापस आती हैं।
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
ask() को दस बार कॉल करें और पहली संख्या को बढ़ते हुए देखें। यही वृद्धि इस लेख की पूरी कहानी है।
विंडो बनाम अधिकतम आउटपुट: दो अलग संख्याएँ#
हर मॉडल पृष्ठ दो आकार सूचीबद्ध करता है, और शुरुआती लोग अक्सर इन्हें मिला देते हैं। विंडो पूरी मेज़ है, इनपुट और आउटपुट एक साथ। आउटपुट सीमा यह है कि एक उत्तर कितना लंबा हो सकता है: DeepSeek-V4-Flash के लिए 32,768 टोकन तक, GLM-5.3-Flash और MiniMax-M2.7 के लिए 8,192 तक।
वे एक ही स्थान साझा करते हैं। आपका इनपुट जितना लेता है, उत्तर को शेष में फिट होना पड़ता है। यदि आप देखना चाहते हैं कि कटा हुआ उत्तर कैसा दिखता है, AI का उत्तर बीच वाक्य में क्यों रुक जाता है इसे समझाता है।
त्वरित जाँच
DeepSeek-V4-Flash में 380K विंडो और 32,768-टोकन आउटपुट सीमा है। आप 375K टोकन इनपुट भेजते हैं। उत्तर लगभग कितना लंबा हो सकता है?
उत्तर दिखाएँ
उत्तर: लगभग 5K टोकन, विंडो में जो बचा है
विंडो इनपुट और आउटपुट दोनों को कवर करती है: 380K − 375K लगभग 5K छोड़ता है, जो 32,768 की सीमा से नीचे है।
लंबी चैट विंडो (और बिल) क्यों भर देती है#
मॉडल आपका अंतिम संदेश याद नहीं रखता। बातचीत जारी रखने के लिए, API को हर बार पूरा इतिहास फिर से मिलता है: पिछले टर्न पूरी तरह रखे जाते हैं, और मॉडल का उत्तर अगले इनपुट का हिस्सा बन जाता है। (चैट ऐप्स कभी-कभी सबसे पुराने संदेश चुपचाप हटा देते हैं; API आपके लिए ऐसा नहीं करता।)
मान लें कि आप एक सहायता सहायक से 30 टर्न तक चैट करते हैं। मान लें 400-टोकन सिस्टम प्रॉम्प्ट, प्रति प्रश्न 150 टोकन और प्रति उत्तर 450 टोकन, इसलिए प्रत्येक आदान-प्रदान इतिहास में 600 टोकन जोड़ता है।
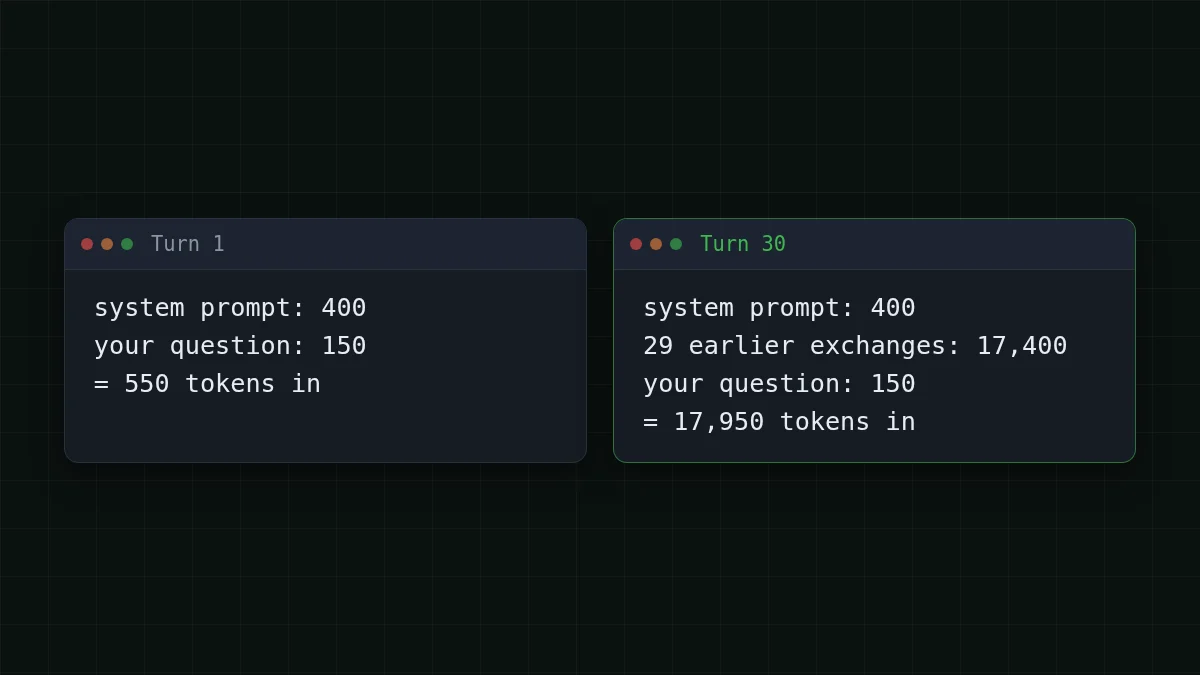
टर्न 1 लगभग 550 टोकन भेजता है। टर्न 30 भेजता है 400 + 150 + 29 × 600 = 17,950। पूरी चैट में जोड़ने पर, हर टर्न अपने शुरू के 550 टोकन साथ ले जाता है, इसलिए 30 × 550 = 16,500। इसके अलावा, टर्न n पिछले n − 1 आदान-प्रदानों को 600 टोकन प्रत्येक के साथ फिर से भेजता है: 600 × 435 = 261,000, जहाँ 435 = 1 + 2 + … + 29। पूरी चैट का इनपुट 16,500 + 261,000 = 277,500 टोकन है, और उत्तर 30 × 450 = 13,500 जोड़ते हैं।
DeepSeek-V4-Flash पर उस पूरी चैट की लागत $0.0055 है। यहाँ तीनों मॉडल हैं, साथ में OpenRouter का संदर्भ मूल्य; इनपुट और आउटपुट को एक साथ गिनते हुए, इस चैट के लिए प्रत्येक OpenRouter से सस्ता है:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | लागत | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
कुल 2,77,500 इनपुट और 13,500 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
औसतन, वह चैट प्रति अनुरोध 277,500 ÷ 30 = 9,250 टोकन इन और 450 आउट है।
अपनी चैट चाहते हैं? नीचे दी गई संख्याएँ बदलें, उदाहरण के लिए 100 टर्न, और देखें कि कुल कितनी तेज़ी से बढ़ता है।
लागत कैलकुलेटर
वही 30-टर्न चैट, औसतन
प्रति अनुरोध इनपुट टोकन: 9,250 · प्रति अनुरोध आउटपुट टोकन: 450 · प्रति दिन अनुरोध: 30
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
अब ईमानदार बात। 17,950 टोकन 380K विंडो के 5% से कम है, इसलिए एक साधारण चैट शायद ही कभी दीवार से टकराती है। जो बढ़ता है वह बिल और शोर है। Anthropic का दस्तावेज़ बताता है कि टोकन संख्या बढ़ने के साथ सटीकता और स्मरण क्षमता घटती है (यह इसे कॉन्टेक्स्ट रॉट कहता है), इसलिए बड़ी विंडो स्वतः बेहतर नहीं होती: आप क्या डालते हैं, यह उतना ही मायने रखता है जितना कि कितना फिट होता है। दीवार वास्तव में दस्तावेज़ों और एजेंटों में दिखती है। Anthropic के अपने API पर, जिस अनुरोध का अकेला इनपुट विंडो से बड़ा होता है, उसे 400 त्रुटि मिलती है, प्रॉम्प्ट बहुत लंबा है। इसी प्रभाव के लागत पक्ष के लिए, देखें लंबी AI चैट अधिक महंगी क्यों होती है।
क्या मेरा दस्तावेज़ फिट होगा?#
अंग्रेज़ी टेक्स्ट के लिए एक मोटा नियम: एक टोकन लगभग एक शब्द का ¾ होता है, इसलिए टोकन ≈ शब्द ÷ 0.75। अन्य भाषाएँ आमतौर पर प्रति शब्द अधिक टोकन लेती हैं, इसलिए अतिरिक्त मार्जिन छोड़ें। आगे पढ़ने से पहले इसे आज़माएँ।
संख्या का अनुमान लगाएँ
90,000 शब्दों की पुस्तक कितने टोकन की है?
आपका अनुमान
03,00,000
उत्तर दिखाएँ
उत्तर: 1,20,000
लगभग 120,000: 90,000 ÷ 0.75 = 120,000। यह तीनों विंडो में बची जगह के साथ फिट हो जाती है।
अब एक बड़ा मामला। मान लें आपके पास सहायता ईमेल का 150,000-शब्द संग्रह है और आप सारांश चाहते हैं: 150,000 ÷ 0.75 = 200,000 टोकन। 200,000 टोकन 180K विंडो से अधिक है, इसलिए इस संग्रह के लिए GLM-5.3-Flash (390K) या DeepSeek-V4-Flash (380K) चुनें। DeepSeek-V4-Flash पर अभी भी 380,000 − 200,000 = 180,000 टोकन की जगह बचती है, जो इसकी 32,768-टोकन उत्तर सीमा के तहत सारांश के लिए पर्याप्त से अधिक है। उन 200,000 टोकन को पढ़ने और 2,000-टोकन सारांश लिखने की लागत $0.0032 है।
एक छोटा मामला: 60,000-शब्द रिपोर्ट 60,000 ÷ 0.75 = 80,000 टोकन है। MiniMax-M2.7 इसे 100K बची जगह के साथ संभाल लेता है, जिससे इसकी 180K विंडो चैट और मध्यम आकार के दस्तावेज़ों के लिए पर्याप्त हो जाती है।
लगभग भरी विंडो के लिए तीन आदतें#
1. सारांश बनाएँ और पुनः आरंभ करें। टर्न 30 पर अनुरोध 17,950 टोकन ले जाता है। मॉडल से अब तक के निर्णयों का 200-टोकन सारांश लिखने को कहें, फिर उसके साथ नई चैट शुरू करें। अगला अनुरोध 400 + 200 + 150 = 750 टोकन इन है, और मॉडल अभी भी जानता है कि क्या मायने रखता है।
2. केवल वही भाग भेजें जिसकी आपको आवश्यकता है। जिस अध्याय के बारे में पूछ रहे हैं वही चिपकाएँ, पूरी पुस्तक नहीं; फ़ंक्शन, पूरा रिपॉज़िटरी नहीं। मेज़ पर कम होने का मतलब छोटा बिल, और Anthropic के कॉन्टेक्स्ट-रॉट नोट के अनुसार, एक मॉडल जिसमें खोने के लिए कम होता है।
3. स्थिर भागों को छोटा रखें और usage पर नज़र रखें। सिस्टम प्रॉम्प्ट, टूल परिभाषाएँ और लंबे टूल परिणाम हर चरण में साथ चलते हैं। जो उपयोग नहीं करते उसे छाँटें, ऊपर के लूप की तरह प्रत्येक प्रतिक्रिया के बाद टोकन गणनाएँ प्रिंट करें, और max_tokens को उस लंबाई पर सेट करें जिसकी आपको वास्तव में आवश्यकता है।
जब आप इसे किसी वास्तविक मॉडल पर आज़माना चाहें, CheapTokens दस्तावेज़ कुछ पंक्तियों में पहला अनुरोध दिखाते हैं, और मूल्य पृष्ठ प्रत्येक मॉडल का लाइव मूल्य सूचीबद्ध करता है। लंबे दस्तावेज़ों और एजेंट लूप के लिए, DeepSeek-V4-Flash (380K कॉन्टेक्स्ट, 32,768 आउटपुट टोकन तक, बिना पीक आवर्स के एक निश्चित मूल्य) और GLM-5.3-Flash (390K, तीनों में सबसे बड़ी विंडो) पहले देखने योग्य हैं।


