लागत अनुकूलनगाइड
मल्टी-एजेंट हैंडऑफ़ लागत: 3-एजेंट श्रृंखला टोकन में क्या उपयोग करती है
देखें कि श्रृंखला में प्रत्येक एजेंट सभी पिछले हैंडऑफ़ को क्यों फिर से पढ़ता है, इसकी टोकन में क्या लागत है, और तीन बदलाव जो इनपुट को छोटा करते हैं।
इस पृष्ठ पर
आपके तीन एजेंट्स ने काम पूरा कर लिया, और बिल काम की तुलना में बड़ा है। कारण सरल है: टेक्स्ट हैंडऑफ़ के साथ, प्रत्येक एजेंट अपने से पहले के एजेंट्स द्वारा लिखी गई हर चीज़ को पढ़ने के लिए भुगतान करता है। 1,500-टोकन की योजना के लिए एक बार भुगतान तब होता है जब योजनाकार इसे लिखता है, फिर कोडर द्वारा, फिर समीक्षक द्वारा। हैंडऑफ़ को छोटा करें, प्रत्येक एजेंट को केवल वही दें जो उसे चाहिए, और बाद के प्रत्येक एजेंट का इनपुट छोटा हो जाता है।
नीचे: टोकन गणित के साथ एक काम किया हुआ 3-एजेंट उदाहरण, लाइव कीमतों पर प्रति दिन 100 कार्यों का लागत अनुमान, और तीन बदलाव जो आप आज कर सकते हैं। चैट-कम्प्लीशन API स्टेटलेस होते हैं, इसलिए प्रत्येक अनुरोध अपना पूरा संदर्भ फिर से ले जाता है (लंबी चैट अधिक महंगी क्यों होती है और messages array कैसे काम करता है मूल बातें कवर करते हैं)।
टोकन कहाँ जमा होते हैं#
मान लें कि आप एक योजनाकार, एक कोडर और एक समीक्षक चलाते हैं। कार्य और निर्देश 1,000 टोकन हैं। योजनाकार 1,500-टोकन की योजना लिखता है, कोडर 3,000 टोकन का कोड और नोट्स लिखता है, समीक्षक 800-टोकन का निर्णय लिखता है। ये उदाहरण के लिए गोल संख्याएँ हैं, माप नहीं; अपने usage फ़ील्ड से अपनी संख्याएँ डालें (इसे कैसे पढ़ें)।
संख्या का अनुमान लगाएँ
समीक्षक इनपुट के रूप में कितने टोकन पढ़ता है?
आपका अनुमान
08,000
उत्तर दिखाएँ
उत्तर: 5,500
5,500: कार्य (1,000), योजना (1,500) और कोड (3,000) सभी उसके अनुरोध में आते हैं।
प्रत्येक एजेंट का इनपुट कार्य और उसे प्राप्त होने वाला प्रत्येक हैंडऑफ़ है:
तालिका को दाईं ओर स्क्रॉल करें →
| एजेंट | पढ़ता है (इनपुट) | लिखता है (आउटपुट) |
|---|---|---|
| योजनाकार | 1,000 (कार्य) | 1,500 |
| कोडर | 1,000 + 1,500 = 2,500 | 3,000 |
| समीक्षक | 1,000 + 1,500 + 3,000 = 5,500 | 800 |
| पूरी श्रृंखला | 1,000 + 2,500 + 5,500 = 9,000 | 1,500 + 3,000 + 800 = 5,300 |
श्रृंखला 5,300 उत्पन्न करने के लिए 9,000 टोकन पढ़ती है। एक चौथा एजेंट जोड़ें और वह कार्य और सभी तीन हैंडऑफ़ पढ़ेगा, इसलिए इनपुट प्रत्येक हॉप के साथ बढ़ता है, न कि केवल एक हैंडऑफ़ से।
प्रति दिन 100 कार्यों की लागत#
एक हैंडऑफ़ टोकन का बिल एक बार आउटपुट के रूप में होता है, जब एजेंट इसे लिखता है, और फिर प्रत्येक बाद के एजेंट के लिए इनपुट के रूप में जो इसे पढ़ता है। आउटपुट टोकन का मूल्य इनपुट टोकन से अधिक होता है, इसलिए इस उदाहरण में उत्तर बिल का बड़ा हिस्सा हैं, भले ही श्रृंखला लिखने से अधिक पढ़ती है (इनपुट बनाम आउटपुट टोकन)।
एक कार्य 9,000 टोकन इन और 5,300 आउट है। MiniMax-M2.7 पर यह प्रति कार्य $0.0012 है। प्रति दिन 100 कार्यों के लिए, ये हमारे मॉडलों में लाइव कीमतें हैं, OpenRouter के बगल में:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 100 अनुरोध | OpenRouter, 100 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
प्रति अनुरोध 9,000 इनपुट और 5,300 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
कुल मिलाकर, इनपुट और आउटपुट को एक साथ गिनते हुए, इस श्रृंखला के लिए ऊपर दिए गए CheapTokens मॉडल OpenRouter से सस्ते निकलते हैं।
अपनी श्रृंखला के लिए गणना चाहते हैं? कैलकुलेटर में एक एजेंट के औसत अनुरोध को डालें: लगभग 3,000 टोकन इन और 1,800 आउट, 300 बार दोहराया गया, तीन एजेंट्स के 100 कार्य हैं।
लागत कैलकुलेटर
प्रति दिन 100 कार्य, प्रत्येक तीन एजेंट्स
प्रति अनुरोध इनपुट टोकन: 3,000 · प्रति अनुरोध आउटपुट टोकन: 1,800 · प्रति दिन अनुरोध: 300
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
बिल कम करने के तीन तरीके#
1. हैंडऑफ़ को एक छोटा संरचित नोट बनाएं#
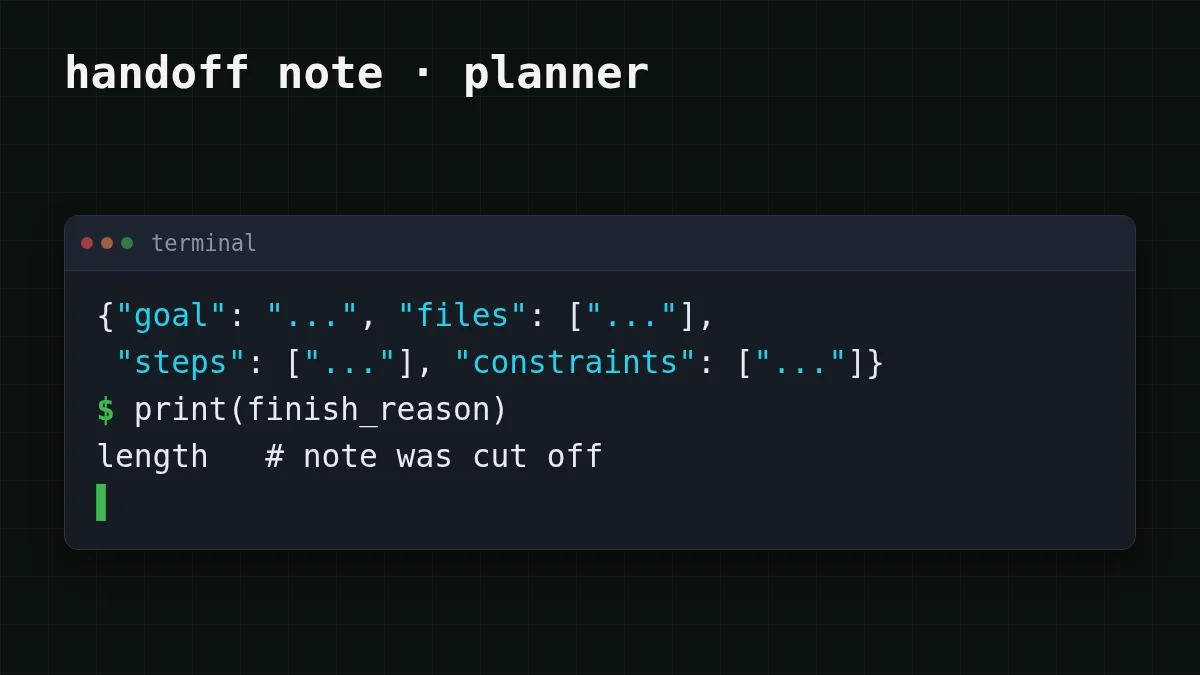
योजनाकार को कोडर के लिए निबंध लिखने की आवश्यकता नहीं है। फ़ील्ड मांगें: लक्ष्य, फ़ाइलें, चरण, बाधाएँ। मान लें कि आठ एक-पंक्ति चरणों का एक छोटा नोट लगभग 400 टोकन लेता है, 1,500 के बजाय (एक धारणा: usage से अपनी संख्या डालें), और प्रत्येक बाद का एजेंट उस छोटे नोट को पढ़ता है। उत्तर को max_tokens से सीमित करें, अपेक्षित नोट से थोड़ा ऊपर सेट करें, ताकि एक बातूनी मॉडल निबंध को वापस न ला सके।
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
यदि finish_reason length है, तो नोट कैप द्वारा काट दिया गया था: max_tokens को थोड़ा बढ़ाएँ या स्कीमा को छोटा करें (वह त्रुटि कैसी दिखती है)। मॉडल आईडी और बेस URL CheapTokens दस्तावेज़ों में हैं।
2. प्रत्येक एजेंट को केवल वही दें जो उसे चाहिए#
यदि समीक्षक कोड को कार्य के विरुद्ध जाँचता है, तो उसे योजना की आवश्यकता नहीं है: कार्य और कोड पर्याप्त हैं। यदि वह कोड को योजना के विरुद्ध भी जाँचता है, तो योजना रखें। इसके संदर्भ से योजना को हटाना आपके ऑर्केस्ट्रेटर में एक-पंक्ति का बदलाव है:
तुलना करें
समीक्षक क्या पढ़ता है
पहले: सब कुछ
कार्य 1,000 + योजना 1,500 + कोड 3,000 = 5,500 टोकन इन।
बाद में: कार्य और कोड
कार्य 1,000 + कोड 3,000 = 4,000 टोकन इन।
दोनों बदलावों के साथ (और 400-टोकन नोट, जो हमारी धारणा है), उदाहरण श्रृंखला बनती है योजनाकार 1,000 इन और 400 आउट, कोडर 1,000 + 400 = 1,400 इन और 3,000 आउट, समीक्षक 1,000 + 3,000 = 4,000 इन और 800 आउट। यह 1,000 + 1,400 + 4,000 = 6,400 टोकन इन और 400 + 3,000 + 800 = 4,200 आउट है, पहले के 9,000 और 5,300 के मुकाबले। वही प्रति दिन 100 कार्य:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 100 अनुरोध | OpenRouter, 100 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
प्रति अनुरोध 6,400 इनपुट और 4,200 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
MiniMax-M2.7 पर एक कार्य के लिए छोटी की गई श्रृंखला $0.00095 है, जो $0.0012 से कम है।
3. छोटी भूमिकाओं को सस्ता मॉडल दें#
योजनाकार छोटे उत्तर लिखता है, इसलिए वहीं से शुरू करें: GLM-5.3-Flash (390K संदर्भ, प्रति उत्तर अधिकतम 8,192 आउटपुट टोकन) आज़माएँ और अपने 10–20 कार्यों पर परिणाम की तुलना करें। कोडर सबसे लंबे उत्तर लिखता है: DeepSeek-V4-Flash प्रति उत्तर अधिकतम 32,768 आउटपुट टोकन की अनुमति देता है। चूँकि प्रत्येक मॉडल किसी भी घंटे एक कीमत पर एक बैलेंस पर बैठता है, उन्हें एक श्रृंखला में मिलाने के लिए प्रत्येक एजेंट के लिए केवल एक अलग model स्ट्रिंग की आवश्यकता होती है। दोनों के वर्तमान मूल्य मूल्य तालिका और DeepSeek पृष्ठ पर हैं।
केवल KV कैश क्यों नहीं पास करें?#
पेपर SwaT (arXiv:2610.15095), जो 10 अक्टूबर 2026 को Alabdulkareem, Tenison, Zhang, Zhu, Katz और Gutfreund द्वारा प्रस्तुत किया गया, ठीक यही प्रस्तावित करता है: एजेंट्स एक-दूसरे को टेक्स्ट के बजाय KV-कैश स्थिति सौंपते हैं, ताकि प्राप्तकर्ता टेक्स्ट को फिर से पढ़ने से बचे। सार पृष्ठ (31 अक्टूबर 2026 को पढ़ा गया) के अनुसार, लेखक 17 बेंचमार्क, 12 LLM और 6 मॉडल परिवारों में टेक्स्ट-टू-टेक्स्ट संचार की तुलना में 40% अधिक औसत सटीकता (KV-कैश कम्पैक्शन के साथ) और 4x तेज़ औसत वॉल-क्लॉक समय की रिपोर्ट करते हैं। 40% सटीकता है, टोकन या कीमत पर बचत नहीं।
इस तरह की एक शोध विधि के लिए मॉडल के आंतरिक कैश तक पहुँच की आवश्यकता होती है। एक चैट-कम्प्लीशन अनुरोध टेक्स्ट लेता है और टेक्स्ट देता है, इसलिए API के साथ आपका लीवर टेक्स्ट है: ऊपर दिए गए तीन बदलाव।
सैकड़ों रन तक स्केल करने से पहले#
चेकलिस्ट
हैंडऑफ़ चेकलिस्ट
एजेंट बजट की बड़ी तस्वीर के लिए, AI एजेंट की लागत का अनुमान कैसे लगाएं और एजेंट्स इतने सारे टोकन क्यों उपयोग करते हैं देखें।


