KostenoptimierungAnleitung
Multi-Agenten-Übergabekosten: Was eine 3-Agenten-Kette an Tokens verbraucht
Erfahre, warum jeder Agent in einer Kette alle früheren Übergaben erneut liest, was das an Tokens kostet und drei Änderungen, die den Input verkleinern.
Auf dieser Seite
- Wo sich die Tokens stapeln
- Was 100 Aufgaben pro Tag kosten
- Drei Wege, die Rechnung zu verkleinern
- 1. Mach die Übergabe zu einer kurzen strukturierten Notiz
- 2. Gib jedem Agenten nur, was er braucht
- 3. Gib kurzen Rollen ein günstiges Modell
- Warum nicht einfach den KV-Cache weitergeben?
- Bevor du auf Hunderte von Läufen skalierst
Deine drei Agenten haben die Aufgabe erledigt, und die Rechnung ist größer als die Aufgabe aussieht. Der Grund ist einfach: Bei Text-Übergaben zahlt jeder Agent dafür, alles zu lesen, was die Agenten davor geschrieben haben. Ein Plan mit 1.500 Tokens wird einmal bezahlt, wenn der Planer ihn schreibt, dann noch einmal vom Coder und dann noch einmal vom Reviewer. Kürze die Übergabe, gib jedem Agenten nur das, was er braucht, und der Input jedes späteren Agenten wird kleiner.
Unten: ein durchgerechnetes 3-Agenten-Beispiel mit seiner Token-Rechnung, eine Kostenschätzung für 100 Aufgaben pro Tag zu Live-Preisen und drei Änderungen, die du heute umsetzen kannst. Chat-Completions-APIs sind zustandslos, also trägt jede Anfrage ihren vollständigen Kontext erneut (warum ein langer Chat mehr kostet und wie das messages-Array funktioniert decken die Grundlagen ab).
Wo sich die Tokens stapeln#
Sagen wir, du betreibst einen Planer, einen Coder und einen Reviewer. Die Aufgabe plus Anweisungen sind 1.000 Tokens. Der Planer schreibt einen Plan mit 1.500 Tokens, der Coder schreibt 3.000 Tokens Code und Notizen, der Reviewer schreibt ein Urteil mit 800 Tokens. Das sind runde Zahlen für das Beispiel, keine Messung; ersetze sie durch deine eigenen aus dem usage-Feld (wie man es liest).
Zahl erraten
Wie viele Tokens liest der Reviewer als Input?
Deine Schätzung
08.000
Antwort anzeigen
Antwort: 5.500
5.500: die Aufgabe (1.000), der Plan (1.500) und der Code (3.000) kommen alle in seiner Anfrage an.
Der Input jedes Agenten ist die Aufgabe plus jede Übergabe, die er erhält:
Tabelle nach rechts scrollen →
| Agent | Liest (Input) | Schreibt (Output) |
|---|---|---|
| Planer | 1.000 (Aufgabe) | 1.500 |
| Coder | 1.000 + 1.500 = 2.500 | 3.000 |
| Reviewer | 1.000 + 1.500 + 3.000 = 5.500 | 800 |
| Ganze Kette | 1.000 + 2.500 + 5.500 = 9.000 | 1.500 + 3.000 + 800 = 5.300 |
Die Kette liest 9.000 Tokens, um 5.300 zu produzieren. Füge einen vierten Agenten hinzu, und er würde die Aufgabe plus alle drei Übergaben lesen, also wächst der Input mit jedem Sprung, nicht nur um eine Übergabe.
Was 100 Aufgaben pro Tag kosten#
Ein Übergabe-Token wird einmal als Output abgerechnet, wenn der Agent es schreibt, und dann als Input für jeden späteren Agenten, der es liest. Output-Tokens sind teurer als Input-Tokens, also sind in diesem Beispiel die Antworten der größere Anteil an der Rechnung, obwohl die Kette mehr liest als schreibt (Input vs. Output-Tokens).
Eine Aufgabe sind 9.000 Tokens Input und 5.300 Output. Auf MiniMax-M2.7 sind das $0.0012 pro Aufgabe. Für 100 Aufgaben pro Tag sind dies die Live-Preise über unsere Modelle, neben OpenRouter:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 100 Anfragen | OpenRouter, 100 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
9.000 Input- und 5.300 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Insgesamt, mit Input und Output zusammen gezählt, kommen die CheapTokens-Modelle oben für diese Kette günstiger weg als OpenRouter.
Willst du die Berechnung für deine eigene Kette? Gib die durchschnittliche Anfrage eines Agenten in den Rechner ein: etwa 3.000 Tokens Input und 1.800 Output, 300-mal wiederholt, sind 100 Aufgaben mit drei Agenten.
Kostenrechner
100 Aufgaben pro Tag, jeweils drei Agenten
Eingabe-Tokens pro Anfrage: 3.000 · Ausgabe-Tokens pro Anfrage: 1.800 · Anfragen pro Tag: 300
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
Drei Wege, die Rechnung zu verkleinern#
1. Mach die Übergabe zu einer kurzen strukturierten Notiz#
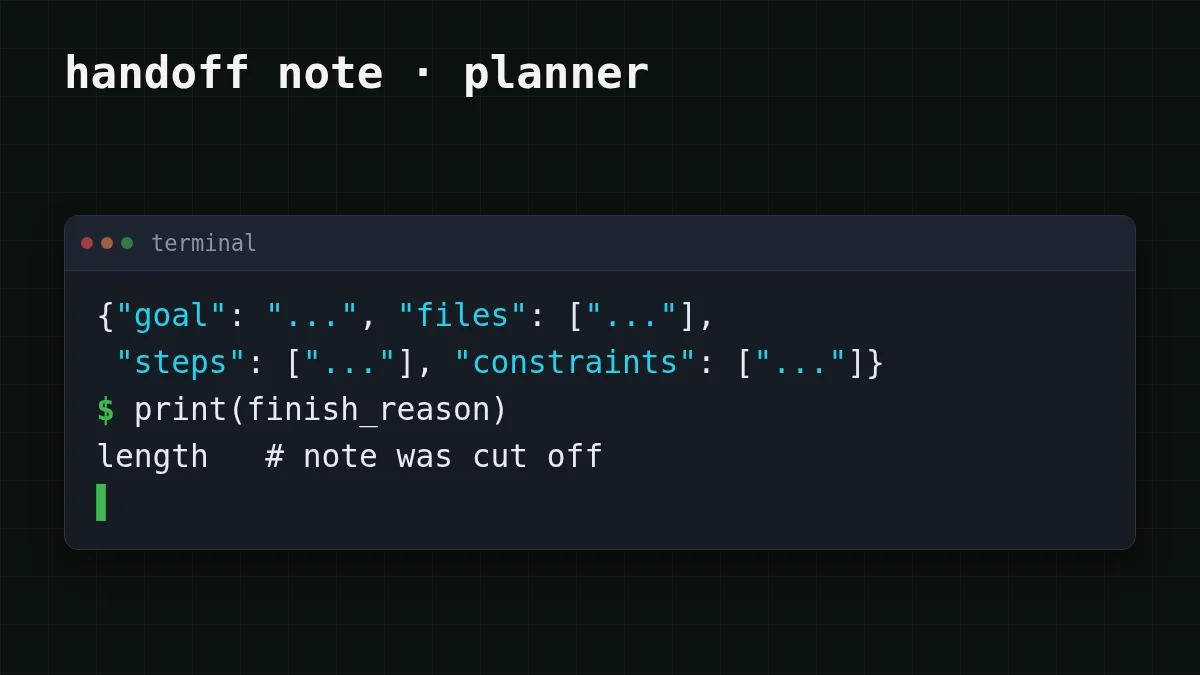
Der Planer muss für den Coder keinen Aufsatz schreiben. Frage nach Feldern: Ziel, Dateien, Schritte, Einschränkungen. Sagen wir, eine kurze Notiz mit acht einzeiligen Schritten braucht etwa 400 Tokens statt 1.500 (eine Annahme: setze deine eigene Zahl aus usage ein), und jeder spätere Agent liest diese kleinere Notiz. Begrenze die Antwort mit max_tokens, etwas über der erwarteten Notiz, damit ein geschwätziges Modell den Aufsatz nicht wieder einschmuggeln kann.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
Wenn finish_reason gleich length ist, wurde die Notiz durch die Begrenzung abgeschnitten: erhöhe max_tokens ein wenig oder kürze das Schema (wie dieser Fehler aussieht). Modell-ID und Basis-URL stehen in der CheapTokens-Dokumentation.
2. Gib jedem Agenten nur, was er braucht#
Wenn der Reviewer den Code gegen die Aufgabe prüft, braucht er den Plan nicht: Aufgabe und Code reichen. Wenn er den Code auch gegen den Plan prüft, behalte den Plan. Den Plan aus seinem Kontext herauszuschneiden ist eine einzeilige Änderung in deinem Orchestrator:
Vergleichen
Was der Reviewer liest
Vorher: alles
Aufgabe 1.000 + Plan 1.500 + Code 3.000 = 5.500 Tokens Input.
Nachher: Aufgabe und Code
Aufgabe 1.000 + Code 3.000 = 4.000 Tokens Input.
Mit beiden Änderungen (und der 400-Token-Notiz, die unsere Annahme ist) wird die Beispielkette zu: Planer 1.000 Input und 400 Output, Coder 1.000 + 400 = 1.400 Input und 3.000 Output, Reviewer 1.000 + 3.000 = 4.000 Input und 800 Output. Das sind 1.000 + 1.400 + 4.000 = 6.400 Tokens Input und 400 + 3.000 + 800 = 4.200 Output, gegenüber 9.000 und 5.300 vorher. Gleiche 100 Aufgaben pro Tag:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 100 Anfragen | OpenRouter, 100 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
6.400 Input- und 4.200 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Für eine Aufgabe auf MiniMax-M2.7 kostet die gekürzte Kette $0.00095, herunter von $0.0012.
3. Gib kurzen Rollen ein günstiges Modell#
Der Planer schreibt kurze Antworten, also fang dort an: probiere GLM-5.3-Flash (390K Kontext, bis zu 8.192 Output-Tokens pro Antwort) und vergleiche das Ergebnis an 10–20 deiner eigenen Aufgaben. Der Coder schreibt die längsten Antworten: DeepSeek-V4-Flash erlaubt bis zu 32.768 Output-Tokens pro Antwort. Da jedes Modell auf einem Guthaben mit einem Preis zu jeder Stunde liegt, braucht das Mischen in einer Kette nur einen anderen model-String pro Agenten. Aktuelle Preise für beide stehen in der Preistabelle und auf der DeepSeek-Seite.
Warum nicht einfach den KV-Cache weitergeben?#
Das Paper SwaT (arXiv:2610.15095), eingereicht am 10. Oktober 2026 von Alabdulkareem, Tenison, Zhang, Zhu, Katz und Gutfreund, schlägt genau das vor: Agenten übergeben einander KV-Cache-Zustand statt Text, sodass der Empfänger das erneute Lesen des Textes überspringt. Laut der Abstract-Seite (gelesen am 31. Oktober 2026) berichten die Autoren von 40 % höherer mittlerer Genauigkeit (mit KV-Cache-Kompaktierung) als bei Text-zu-Text-Kommunikation und 4x schnellerer mittlerer Wall-Clock-Zeit über 17 Benchmarks, 12 LLMs und 6 Modellfamilien. Die 40 % sind Genauigkeit, keine Einsparung bei Tokens oder Preis.
Eine Forschungsmethode wie diese braucht Zugriff auf den internen Cache des Modells. Eine Chat-Completions-Anfrage nimmt Text entgegen und gibt Text aus, also ist mit einer API dein Hebel der Text: die drei Änderungen oben.
Bevor du auf Hunderte von Läufen skalierst#
Checkliste
Übergabe-Checkliste
Für das größere Bild der Agenten-Budgets siehe wie man die Kosten eines KI-Agenten schätzt und warum Agenten so viele Tokens verbrauchen.


