খরচ অপ্টিমাইজেশনগাইড
মাল্টি-এজেন্ট হ্যান্ডঅফ খরচ: একটি ৩-এজেন্ট চেইন টোকেনে কী ব্যবহার করে
কেন একটি চেইনের প্রতিটি এজেন্ট সমস্ত পূর্ববর্তী হ্যান্ডঅফ আবার পড়ে, টোকেনে তার খরচ কত, এবং তিনটি পরিবর্তন যা ইনপুট ছোট করে তা দেখুন।
এই পৃষ্ঠায়
আপনার তিনটি এজেন্ট কাজটি শেষ করেছে, এবং বিলটি কাজের চেয়ে বড় দেখাচ্ছে। কারণটি সহজ: টেক্সট হ্যান্ডঅফের সাথে, প্রতিটি এজেন্ট তার আগের এজেন্টরা যা লিখেছে তা পড়ার জন্য অর্থ দেয়। একটি ১,৫০০-টোকেনের প্ল্যান প্ল্যানার লেখার সময় একবার, তারপর কোডার আবার, তারপর রিভিউয়ার আবার দেয়। হ্যান্ডঅফ ছোট করুন, প্রতিটি এজেন্টকে শুধু যা প্রয়োজন তাই দিন, এবং পরবর্তী প্রতিটি এজেন্টের ইনপুট ছোট হয়ে যাবে।
নিচে: টোকেন গণিতসহ একটি কার্যকর ৩-এজেন্ট উদাহরণ, লাইভ মূল্যে দিনে ১০০টি কাজের জন্য একটি খরচ অনুমান, এবং আজই আপনি করতে পারেন এমন তিনটি পরিবর্তন। চ্যাট-কমপ্লিশন API স্টেটলেস, তাই প্রতিটি অনুরোধ তার সম্পূর্ণ প্রসঙ্গ আবার বহন করে (কেন একটি দীর্ঘ চ্যাট বেশি খরচ করে এবং কীভাবে মেসেজ অ্যারে কাজ করে মৌলিক বিষয়গুলি কভার করে)।
টোকেন কোথায় জমা হয়#
ধরুন আপনি একটি প্ল্যানার, একটি কোডার এবং একটি রিভিউয়ার চালান। কাজটি প্লাস নির্দেশাবলী ১,০০০ টোকেন। প্ল্যানার একটি ১,৫০০-টোকেনের প্ল্যান লেখে, কোডার ৩,০০০ টোকেনের কোড এবং নোট লেখে, রিভিউয়ার একটি ৮০০-টোকেনের রায় লেখে। এগুলি উদাহরণের জন্য গোল সংখ্যা, পরিমাপ নয়; usage ক্ষেত্র থেকে আপনার নিজেরটি বসান (কীভাবে পড়বেন)।
সংখ্যা অনুমান করুন
রিভিউয়ার ইনপুট হিসেবে কত টোকেন পড়ে?
আপনার অনুমান
০৮,০০০
উত্তর দেখান
উত্তর: ৫,৫০০
৫,৫০০: কাজ (১,০০০), প্ল্যান (১,৫০০) এবং কোড (৩,০০০) সবই তার অনুরোধে আসে।
প্রতিটি এজেন্টের ইনপুট হল কাজ প্লাস প্রতিটি হ্যান্ডঅফ যা এটি পায়:
টেবিলটি ডানদিকে স্ক্রোল করুন →
| এজেন্ট | পড়ে (ইনপুট) | লেখে (আউটপুট) |
|---|---|---|
| প্ল্যানার | ১,০০০ (কাজ) | ১,৫০০ |
| কোডার | ১,০০০ + ১,৫০০ = ২,৫০০ | ৩,০০০ |
| রিভিউয়ার | ১,০০০ + ১,৫০০ + ৩,০০০ = ৫,৫০০ | ৮০০ |
| সম্পূর্ণ চেইন | ১,০০০ + ২,৫০০ + ৫,৫০০ = ৯,০০০ | ১,৫০০ + ৩,০০০ + ৮০০ = ৫,৩০০ |
চেইনটি ৫,৩০০ উৎপাদন করতে ৯,০০০ টোকেন পড়ে। একটি চতুর্থ এজেন্ট যোগ করলে এটি কাজ প্লাস তিনটি হ্যান্ডঅফই পড়বে, তাই ইনপুট প্রতিটি হপের সাথে বাড়ে, শুধু একটি হ্যান্ডঅফ দ্বারা নয়।
দিনে ১০০টি কাজের খরচ#
একটি হ্যান্ডঅফ টোকেন একবার আউটপুট হিসেবে বিল হয়, যখন এজেন্ট এটি লেখে, এবং তারপর প্রতিটি পরবর্তী এজেন্টের জন্য ইনপুট হিসেবে যা এটি পড়ে। আউটপুট টোকেনের মূল্য ইনপুট টোকেনের চেয়ে বেশি, তাই এই উদাহরণে উত্তরগুলিই বিলের বড় অংশ যদিও চেইন লেখার চেয়ে বেশি পড়ে (ইনপুট বনাম আউটপুট টোকেন)।
একটি কাজ হল ৯,০০০ টোকেন ইন এবং ৫,৩০০ আউট। MiniMax-M2.7-এ এটি প্রতি কাজে $0.0012। দিনে ১০০টি কাজের জন্য, এগুলি আমাদের মডেলগুলিতে লাইভ মূল্য, OpenRouter-এর পাশে:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ১০০টি অনুরোধ | OpenRouter, ১০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
প্রতি অনুরোধে ৯,০০০ ইনপুট এবং ৫,৩০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
সামগ্রিকভাবে, ইনপুট এবং আউটপুট একসাথে গণনা করলে, উপরের CheapTokens মডেলগুলি এই চেইনের জন্য OpenRouter-এর চেয়ে সস্তা হয়।
আপনার নিজের চেইনের জন্য গণনা চান? ক্যালকুলেটরে একজন এজেন্টের গড় অনুরোধ রাখুন: প্রায় ৩,০০০ টোকেন ইন এবং ১,৮০০ আউট, ৩০০ বার পুনরাবৃত্তি, হল তিনটি এজেন্টের ১০০টি কাজ।
খরচ ক্যালকুলেটর
দিনে ১০০টি কাজ, প্রতিটি তিনটি এজেন্ট
প্রতি অনুরোধে ইনপুট টোকেন: ৩,০০০ · প্রতি অনুরোধে আউটপুট টোকেন: ১,৮০০ · প্রতিদিন অনুরোধ: ৩০০
| মডেল | প্রতিদিন | প্রতি মাসে |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
বিল কমানোর তিনটি উপায়#
১. হ্যান্ডঅফকে একটি সংক্ষিপ্ত কাঠামোবদ্ধ নোট করুন#
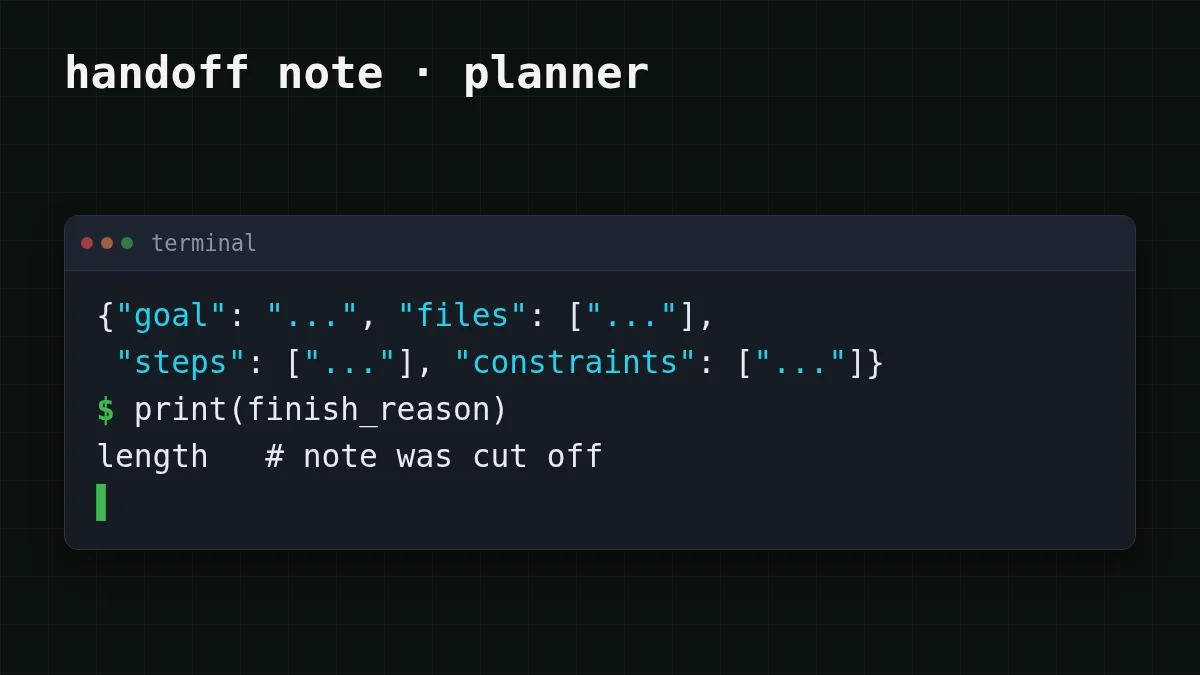
প্ল্যানারকে কোডারের জন্য একটি প্রবন্ধ লিখতে হবে না। ক্ষেত্র চান: লক্ষ্য, ফাইল, ধাপ, সীমাবদ্ধতা। ধরুন আটটি এক-লাইনের ধাপের একটি সংক্ষিপ্ত নোট প্রায় ৪০০ টোকেন নেয় ১,৫০০-এর পরিবর্তে (একটি অনুমান: usage থেকে আপনার নিজের সংখ্যা বসান), এবং প্রতিটি পরবর্তী এজেন্ট সেই ছোট নোটটি পড়ে। উত্তরটি max_tokens দিয়ে সীমাবদ্ধ করুন, প্রত্যাশিত নোটের সামান্য উপরে সেট করুন, যাতে একটি কথাবহুল মডেল প্রবন্ধটি আবার চুপিচুপি ঢোকাতে না পারে।
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
যদি finish_reason হয় length, নোটটি ক্যাপ দ্বারা কাটা হয়েছিল: max_tokens সামান্য বাড়ান বা স্কিমা ছোট করুন (সেই ত্রুটি কেমন দেখায়)। মডেল আইডি এবং বেস URL CheapTokens ডক্সে আছে।
২. প্রতিটি এজেন্টকে শুধু যা প্রয়োজন তাই দিন#
যদি রিভিউয়ার কাজের বিরুদ্ধে কোড পরীক্ষা করে, তার প্ল্যানের প্রয়োজন নেই: কাজ এবং কোডই যথেষ্ট। যদি এটি প্ল্যানের বিরুদ্ধেও কোড পরীক্ষা করে, প্ল্যান রাখুন। এর প্রসঙ্গ থেকে প্ল্যান কেটে ফেলা আপনার অর্কেস্ট্রেটরে এক-লাইনের পরিবর্তন:
তুলনা করুন
রিভিউয়ার যা পড়ে
আগে: সবকিছু
কাজ ১,০০০ + প্ল্যান ১,৫০০ + কোড ৩,০০০ = ৫,৫০০ টোকেন ইন।
পরে: কাজ এবং কোড
কাজ ১,০০০ + কোড ৩,০০০ = ৪,০০০ টোকেন ইন।
উভয় পরিবর্তনসহ (এবং ৪০০-টোকেনের নোট, যা আমাদের অনুমান), উদাহরণ চেইন হয় প্ল্যানার ১,০০০ ইন এবং ৪০০ আউট, কোডার ১,০০০ + ৪০০ = ১,৪০০ ইন এবং ৩,০০০ আউট, রিভিউয়ার ১,০০০ + ৩,০০০ = ৪,০০০ ইন এবং ৮০০ আউট। সেটি হল ১,০০০ + ১,৪০০ + ৪,০০০ = ৬,৪০০ টোকেন ইন এবং ৪০০ + ৩,০০০ + ৮০০ = ৪,২০০ আউট, আগের ৯,০০০ এবং ৫,৩০০-এর বিপরীতে। একই দিনে ১০০টি কাজ:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ১০০টি অনুরোধ | OpenRouter, ১০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
প্রতি অনুরোধে ৬,৪০০ ইনপুট এবং ৪,২০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
MiniMax-M2.7-এ একটি কাজের জন্য ছাঁটা চেইন হল $0.00095, $0.0012 থেকে নিচে।
৩. সংক্ষিপ্ত ভূমিকাকে সস্তা মডেল দিন#
প্ল্যানার সংক্ষিপ্ত উত্তর লেখে, তাই সেখান থেকেই শুরু করুন: GLM-5.3-Flash চেষ্টা করুন (৩৯০K প্রসঙ্গ, প্রতি উত্তরে ৮,১৯২ আউটপুট টোকেন পর্যন্ত) এবং আপনার নিজের ১০–২০টি কাজে ফলাফল তুলনা করুন। কোডার সবচেয়ে দীর্ঘ উত্তর লেখে: DeepSeek-V4-Flash প্রতি উত্তরে ৩২,৭৬৮ আউটপুট টোকেন পর্যন্ত অনুমোদন করে। যেহেতু প্রতিটি মডেল যেকোনো সময়ে একটি মূল্যে একটি ব্যালেন্সে বসে, একটি চেইনে তাদের মিশ্রণ করতে শুধু প্রতিটি এজেন্টের জন্য একটি ভিন্ন model স্ট্রিং প্রয়োজন। উভয়ের বর্তমান মূল্য মূল্য সারণীতে এবং DeepSeek পৃষ্ঠায় আছে।
শুধু KV ক্যাশ পাস করবেন না কেন?#
পেপার SwaT (arXiv:2610.15095), ১০ অক্টোবর ২০২৬-এ Alabdulkareem, Tenison, Zhang, Zhu, Katz এবং Gutfreund দ্বারা জমা দেওয়া, ঠিক সেটাই প্রস্তাব করে: এজেন্টরা একে অপরকে টেক্সটের পরিবর্তে KV-ক্যাশ অবস্থা হস্তান্তর করে, তাই প্রাপক টেক্সট আবার পড়া এড়িয়ে যায়। বিমূর্ত পৃষ্ঠা অনুসারে (৩১ অক্টোবর ২০২৬-এ পড়া), লেখকরা ১৭টি বেঞ্চমার্ক, ১২টি LLM এবং ৬টি মডেল পরিবারে টেক্সট-থেকে-টেক্সট যোগাযোগের চেয়ে ৪০% উচ্চতর গড় নির্ভুলতা (KV-ক্যাশ কম্প্যাকশনসহ) এবং ৪x দ্রুত গড় ওয়াল-ক্লক সময় রিপোর্ট করেন। ৪০% হল নির্ভুলতা, টোকেন বা মূল্যে সঞ্চয় নয়।
এই ধরনের একটি গবেষণা পদ্ধতির মডেলের অভ্যন্তরীণ ক্যাশে অ্যাক্সেস প্রয়োজন। একটি চ্যাট-কমপ্লিশন অনুরোধ টেক্সট নেয় এবং টেক্সট দেয়, তাই একটি API-এর সাথে আপনার লিভার হল টেক্সট: উপরের তিনটি পরিবর্তন।
শত শত রানে স্কেল করার আগে#
চেকলিস্ট
হ্যান্ডঅফ চেকলিস্ট
এজেন্ট বাজেটের বৃহত্তর চিত্রের জন্য, দেখুন কীভাবে একটি AI এজেন্টের খরচ অনুমান করবেন এবং কেন এজেন্টরা এত টোকেন ব্যবহার করে।


