শুরু করাগাইড
API দিয়ে মাল্টি-টার্ন চ্যাট: messages অ্যারে আবার পাঠান
মডেল অনুরোধের মধ্যে কিছুই মনে রাখে না। একটি Python চ্যাট লুপ তৈরি করুন যা messages অ্যারে আবার পাঠায় এবং ইনপুট টোকেন কীভাবে বাড়ে দেখুন।
এই পৃষ্ঠায়
আপনার দ্বিতীয় প্রশ্নের উত্তর অদ্ভুত আসে কারণ API কখনোই আপনার প্রথম প্রশ্নটি দেখেনি। মডেল অনুরোধের মধ্যে কিছুই মনে রাখে না, তাই একটি চ্যাট হলো এমন কিছু যা আপনি তৈরি করেন: প্রতিটি উত্তর পাওয়ার পর আপনি সেটি messages নামের একটি তালিকায় যোগ করেন এবং পুরো তালিকাটি আবার পাঠান। এটাই পুরো কৌশল, এবং নিচে CheapTokens-এর OpenAI-সামঞ্জস্যপূর্ণ API-এর বিরুদ্ধে এটির একটি কার্যকর Python লুপ দেওয়া হলো।
দুটি অফিসিয়াল ডকুমেন্ট একই বিষয় বর্ণনা করে। Anthropic-এর Messages API রেফারেন্স (৩০ অক্টোবর ২০২৬-এ যাচাইকৃত) API-কে স্টেটলেস এবং মাল্টি-টার্ন বলে উল্লেখ করে: আগের টার্নগুলো messages প্যারামিটারে যায়। OpenAI-এর টেক্সট-জেনারেশন গাইড (৩০ অক্টোবর ২০২৬-এ যাচাইকৃত) বলে যে আগের টার্নগুলো রোল-ট্যাগযুক্ত মেসেজ হিসেবে পাঠিয়ে এবং পরবর্তী অনুরোধের আগে প্রতিটি উত্তর যোগ করে কনটেক্সট ধরে রাখতে হবে।
কেন দ্বিতীয় প্রশ্নে ফাঁকা দৃষ্টি পাওয়া যায়#
ধরুন আপনি What is a token? টাইপ করলেন, উত্তর পড়লেন, তারপর Explain it shorter টাইপ করলেন। আপনার কাছে "এটা" স্পষ্ট। API-এর কাছে দ্বিতীয় অনুরোধটি একজন অপরিচিতের এক-লাইনের বার্তা: কোনো "এটা" নেই, সংক্ষিপ্ত করার কিছু নেই। আপনি একটি অনুমান বা একটি প্রশ্ন ফেরত পাবেন, সংক্ষিপ্ত ব্যাখ্যা নয়।
সমাধান হলো দ্বিতীয় অনুরোধে প্রথম অনুরোধের সবকিছু, প্লাস উত্তর, প্লাস নতুন প্রশ্ন বহন করানো। দুটি পেলোড তুলনা করুন:
তুলনা করুন
অনুরোধ ২, হিস্ট্রি সহ এবং ছাড়া
হিস্ট্রি ছাড়া
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
মডেলের কোনো ধারণা নেই "এটা" কী।
হিস্ট্রি সহ
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
এখন "এটা" প্রথম উত্তরটিকে নির্দেশ করে।
তিনটি রোলই পুরো কাজটি করে। system একবার নিয়ম নির্ধারণ করে (টোন, দৈর্ঘ্য, বটটি কীসের জন্য)। user হলো যা ব্যক্তি টাইপ করেছেন। assistant হলো যা মডেল আগে বলেছে। মডেল তালিকাটি উপর থেকে নিচে পড়ে এবং পরবর্তী assistant মেসেজ লেখে।
কয়েক লাইনে চ্যাট লুপ#
SDK ইনস্টল করুন pip install openai দিয়ে এবং আপনার কী একটি এনভায়রনমেন্ট ভেরিয়েবলে রাখুন, যেমন কীভাবে একটি API কী নিরাপদে সংরক্ষণ করবেন-এ। বেস URL এবং মডেল আইডি আসে CheapTokens ডকস এবং GET /v1/models থেকে (আরও দেখুন সঠিক আইডি খুঁজতে মডেল তালিকা করা)। শেখার লুপের জন্য GLM-5.3-Flash ভালো মানায়: ৩৯০K কনটেক্সট এবং প্রতি উত্তরে সর্বোচ্চ ৮,১৯২ আউটপুট টোকেন।
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
এটি চালান, What is a token? জিজ্ঞাসা করুন, তারপর Explain it shorter। দ্বিতীয় উত্তরটি এখন প্রথমটিকে নির্দেশ করে। শেষ লাইনটি usage. প্রিন্ট করে, সেই টার্নের বিলের ইনপুট দিক; প্রতিটি প্রশ্নের সাথে এটি বাড়তে দেখুন।
লুপের ভেতরের ক্রম গুরুত্বপূর্ণ, এবং এটাই নতুনরা সবচেয়ে বেশি ভুল করে:
ক্রমে সাজান
লুপের একটি টার্ন ক্রমানুসারে সাজান
আইটেমগুলো ড্র্যাগ করুন বা তীর ব্যবহার করুন
- ব্যবহারকারীর প্রশ্ন messages-এ যোগ করুন
- পুরো messages তালিকা পাঠান
- রেসপন্স থেকে উত্তর পড়ুন
- উত্তরটি assistant মেসেজ হিসেবে যোগ করুন
ধাপ ৪ বাদ দিলে মডেল তার নিজের উত্তর ভুলে যায়, তাই "এটা সংক্ষেপে ব্যাখ্যা করো" একবার কাজ করে তারপর তৃতীয় প্রশ্নে আবার ভেঙে যায়।
দুই টার্ন পরে তালিকাটি কেমন দেখায়#
What is a token? এবং Explain it shorter-এর পরে, আপনার কোড যে তালিকা ধরে রাখে তাতে পাঁচটি এন্ট্রি থাকে: সিস্টেম নিয়ম, প্রথম প্রশ্ন, প্রথম উত্তর, দ্বিতীয় প্রশ্ন, দ্বিতীয় উত্তর। পরবর্তী অনুরোধ পাঁচটিই প্লাস তৃতীয় প্রশ্ন পাঠাবে।
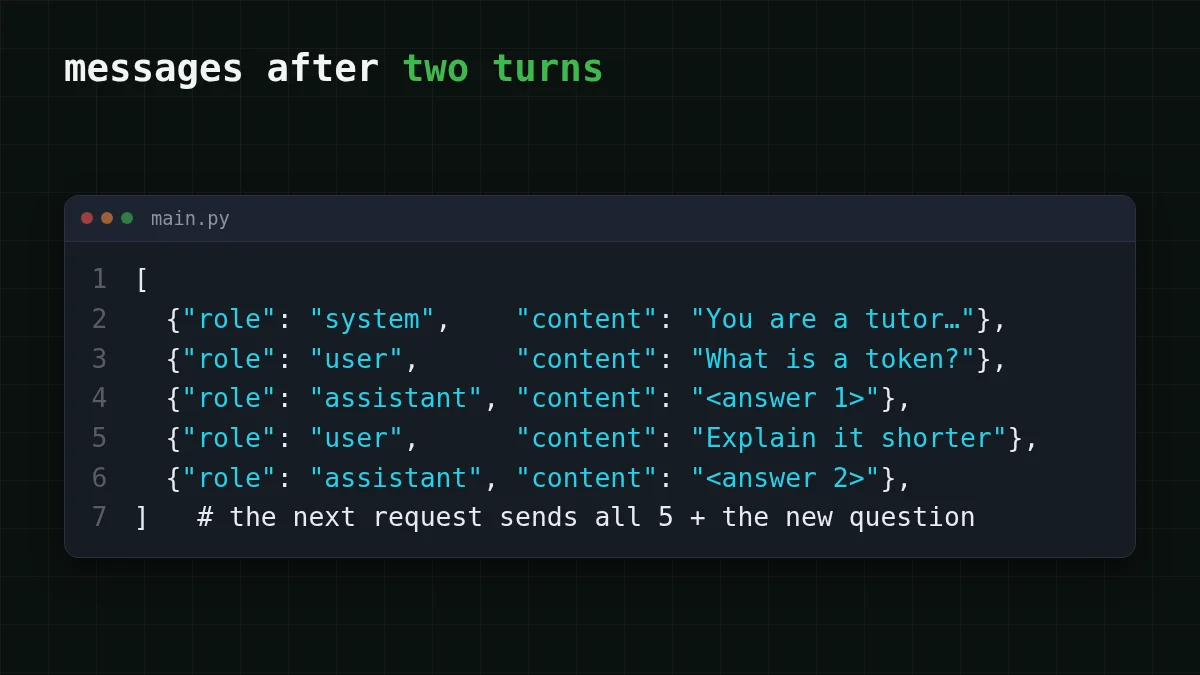
সিস্টেম মেসেজ প্রতিবার পাঠানো হয়। API এটি তার দিকে "রাখে" না; এটি কেবল তালিকার প্রথম আইটেম। OpenAI-এর গাইড (৩০ অক্টোবর ২০২৬-এ যাচাইকৃত) উল্লেখ করে যে নির্দেশাবলি কেবল বর্তমান অনুরোধে প্রযোজ্য, যা অন্যদিক থেকে একই ধারণা। আপনি যদি সেই প্রথম মেসেজটি টিউন করতে চান, দেখুন সিস্টেম প্রম্পট এবং টেম্পারেচার ব্যাখ্যা।
চ্যাট বাড়ার সাথে ইনপুট টোকেনের কী হয়#
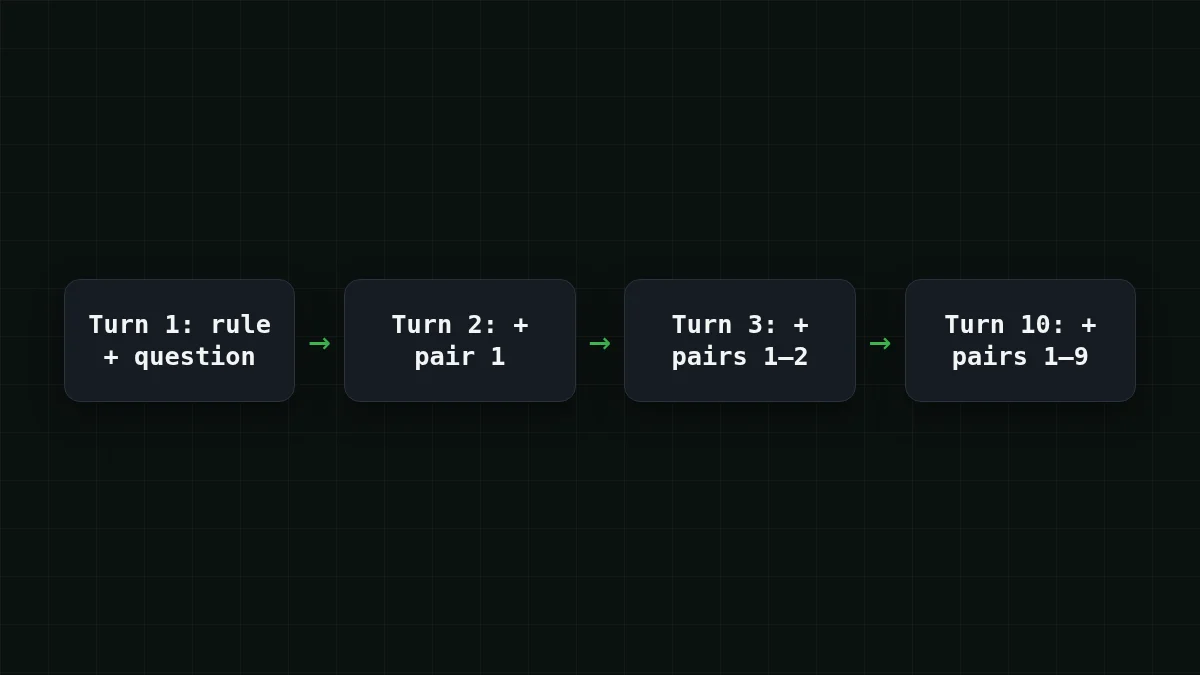
প্রতিটি অনুরোধ ইনপুট হিসেবে পুরো তালিকার জন্য আবার অর্থ দেয়। টার্ন ১ সিস্টেম নিয়ম এবং একটি প্রশ্ন পাঠায়; টার্ন ১০ নিয়ম, নয়টি আগের প্রশ্ন-উত্তর জোড়া এবং নতুন প্রশ্ন পাঠায়। তাই আপনার প্রতিটি মেসেজ ছোট হলেও প্রতিটি টার্নে ইনপুট বাড়ে।
ধরুন এই অনুমানসহ একটি ১০-টার্নের চ্যাট: সিস্টেম নিয়ম প্রায় ৫০ টোকেন, প্রতিটি প্রশ্ন প্রায় ১৫০, প্রতিটি উত্তর প্রায় ২৫০। টার্ন ১ পাঠায় ৫০ + ১৫০ = ২০০ ইনপুট টোকেন। প্রতিটি পরবর্তী টার্ন আরও একটি ৪০০-টোকেন জোড়া যোগ করে (১৫০ + ২৫০ = ৪০০), তাই দশ টার্নে মোট ইনপুট ২০০ × ১০ + ৪০০ × ৪৫ = ২০,০০০ টোকেন, যেখানে ৪৫ হলো ০ + ১ + … + ৯। আউটপুট ২৫০ × ১০ = ২,৫০০ টোকেন। আপনার দশটি মেসেজ, এবং ইনপুট আউটপুটের আট গুণ।
এখানে লাইভ রেটে সেই পুরো চ্যাটের মূল্য, ২০,০০০ টোকেন ইন এবং ২,৫০০ আউট:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | খরচ | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
মোট ২০,০০০ ইনপুট এবং ২,৫০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
মোটে, ইনপুট ও আউটপুট একসাথে গণনা করলে, GLM-5.3-Flash এবং DeepSeek-V4-Flash এখানে OpenRouter-এর চেয়ে কম খরচে পড়ে, এবং উভয়ই যেকোনো সময়ে একই মূল্য রাখে। একই চ্যাট লুপে ৮,১৯২ টোকেনের বেশি উত্তর চাইলে, DeepSeek-V4-Flash ৩৮০K কনটেক্সটসহ প্রতি উত্তরে সর্বোচ্চ ৩২,৭৬৮ আউটপুট টোকেন অনুমোদন করে; মডেল আইডি deepseek- দিয়ে বদলান এবং লুপে আর কিছুই বদলায় না।
গভীর খরচের গল্প কেন একটি দীর্ঘ AI চ্যাট বেশি খরচ করে-এ; ইনপুট বনাম আউটপুট টোকেন ব্যাখ্যা করে কেন দুই দিক আলাদাভাবে মূল্যায়িত হয়।
দ্রুত যাচাই
আপনার চ্যাট টার্ন ৮-এ আছে। টার্ন ৮-এর অনুরোধে কী থাকে?
উত্তর দেখান
উত্তর: সিস্টেম মেসেজ এবং আগের প্রতিটি প্রশ্ন ও উত্তর, প্লাস নতুন প্রশ্ন
API কিছুই মনে রাখে না, তাই প্রতিবার পুরো তালিকা যায়। এজন্যই ইনপুট টোকেন টার্নের পর টার্ন বাড়ে।
একটি দীর্ঘ চ্যাট নিয়ন্ত্রণে রাখা#
তালিকা অনন্তকাল বাড়তে পারে না: এটি মডেলের কনটেক্সট উইন্ডোতে ফিট হতে হবে (দেখুন কনটেক্সট উইন্ডো কী), এবং প্রতিটি অতিরিক্ত টার্নে ইনপুট খরচ হয়। একটি প্রোটোটাইপের জন্য দুটি অভ্যাস এটিকে যুক্তিসঙ্গত রাখে:
- সবচেয়ে পুরনো টার্নগুলো ছাঁটুন। সিস্টেম মেসেজ এবং শেষ কয়েকটি জোড়া রাখুন, উদাহরণস্বরূপ প্রতিটি অনুরোধের আগে
messages = messages[:1] + messages[-। জোড়াগুলো একসাথে বাদ দিন যাতে একটি প্রশ্ন কখনো তার উত্তর হারিয়ে না ফেলে।8:] - নতুন বিষয়ের জন্য নতুন তালিকা শুরু করুন। একটি নতুন কাজের পুরনো কাজের হিস্ট্রি দরকার নেই।
দীর্ঘস্থায়ী নিয়ম-সেটসহ একটি সাপোর্ট বট একই লুপ: সিস্টেম মেসেজ একবার নিয়ম নির্ধারণ করে, প্রতিটি ব্যবহারকারী টার্ন এবং উত্তর যোগ হয়, এবং তালিকা ভারী হলে আপনি ছাঁটেন। প্রথম অনুরোধের জন্য দেখুন CheapTokens দিয়ে আপনার প্রথম API অনুরোধ; মডেল তালিকা এবং মূল্য প্রাইসিং পেজে।


