AI-তে কনটেক্সট উইন্ডো কী? এটি কী পূরণ করে এবং কী করতে হবে
কনটেক্সট উইন্ডো হলো একটি অনুরোধের জন্য মডেলের কার্যকরী স্মৃতি: আপনার প্রম্পট, চ্যাট ইতিহাস এবং উত্তর। দেখুন এটি কী পূরণ করে, কীভাবে অনুমান করবেন, এবং তিনটি অভ্যাস।
এই পৃষ্ঠায়
আপনার চ্যাট বিশটি বার্তা পর্যন্ত ভালো চলছিল, এখন উত্তরগুলো অস্পষ্ট হয়ে যাচ্ছে। প্রতিটি বার্তার সাথে একটি জিনিস বাড়তে থাকে: কনটেক্সট উইন্ডো — একটি অনুরোধের জন্য মডেলের কার্যকরী স্মৃতি। এটি আপনার পাঠানো সবকিছু এবং মডেল যে উত্তর লেখে তা ধারণ করে, এবং এর একটি নির্দিষ্ট আকার থাকে, উদাহরণস্বরূপ DeepSeek-V4-Flash-এর জন্য 380K টোকেন।
কনটেক্সট উইন্ডো কী#
একটি ডেস্কের কথা ভাবুন। মডেল কেবল এখন ডেস্কে যা আছে তা নিয়েই কাজ করতে পারে: আপনার নির্দেশাবলী, এখন পর্যন্ত কথোপকথন, পেস্ট করা একটি ডকুমেন্ট এবং এটি যে উত্তর লিখছে। ডেস্কে যা নেই তা তার কাছে অস্তিত্বহীন। কনটেক্সট উইন্ডো সম্পর্কে Anthropic-এর ডকুমেন্টেশন (২৭ অক্টোবর ২০২৬-এ যাচাইকৃত) একইভাবে বলে: উইন্ডো হলো সেই সমস্ত টেক্সট যা একটি মডেল উত্তর তৈরি করার সময় রেফারেন্স করতে পারে, উত্তরটি সহ, এবং এটি মডেল যে ডেটার উপর প্রশিক্ষিত হয়েছে তা থেকে আলাদা।
ডেস্কের একটি নির্দিষ্ট আকার থাকে, টোকেনে গণনা করা হয়। একটি টোকেন হলো টেক্সটের একটি অংশ, মোটামুটি একটি ইংরেজি শব্দের ¾; AI-তে টোকেন কী আরও গভীরে যায়। এখানে CheapTokens-এ তিনটি মডেল এবং তাদের উইন্ডো:
- GLM-5.3-Flash: 390K টোকেন
- DeepSeek-V4-Flash: 380K টোকেন
- MiniMax-M2.7: 180K টোকেন
K মানে হাজার। একটি 380K উইন্ডো প্রায় 285,000 ইংরেজি শব্দ: 380,000 × 0.75 = 285,000। এটি একটি ডেস্কে কয়েকটি উপন্যাস, এবং এটি আপনার ধারণার চেয়েও দ্রুত শেষ হয়ে যায়।
এর মধ্যে কী কী গণনা করা হয়#
অনুরোধের সবকিছুই গণনা করা হয়, কেবল আপনার শেষ বার্তা নয়:
- সিস্টেম প্রম্পট (স্থায়ী নির্দেশাবলী);
- প্রতিটি পূর্ববর্তী বার্তা, আপনার এবং মডেলের;
- টুল সংজ্ঞা এবং টুল ফলাফল, যদি আপনি একটি এজেন্ট বা এডিটর প্লাগইন ব্যবহার করেন;
- আপনি যে ডকুমেন্ট এবং ছবি সংযুক্ত করেন;
- উত্তরটি নিজেই, মডেলের যেকোনো চিন্তা সহ।
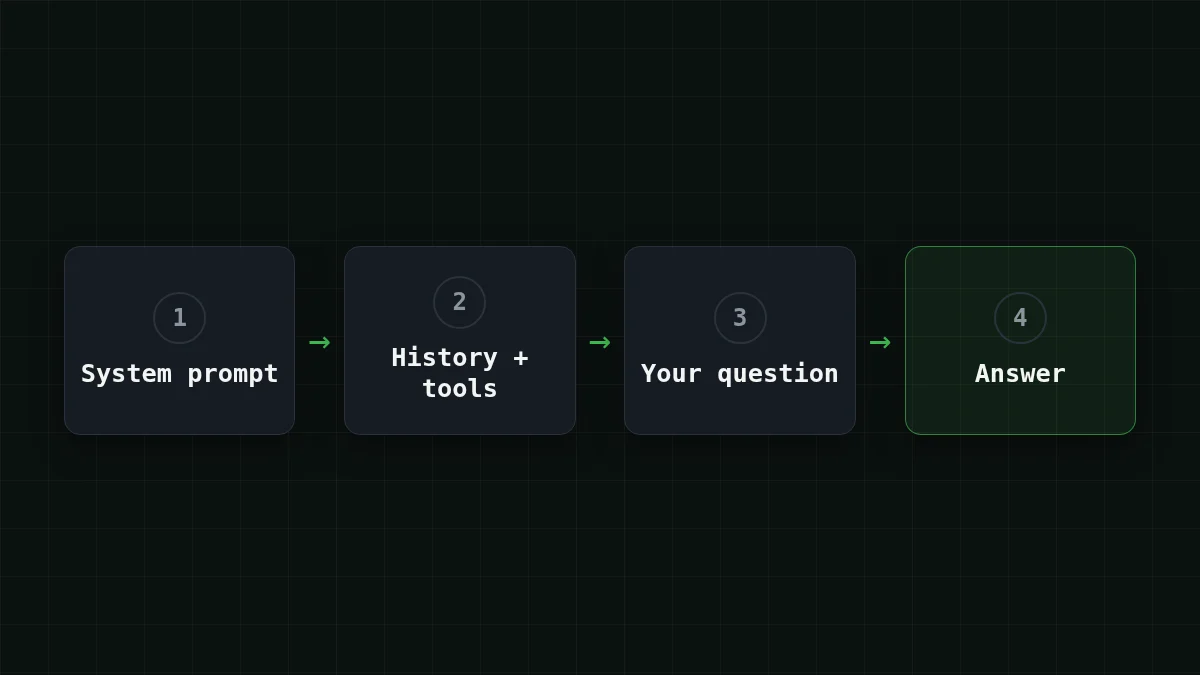
একটি এডিটর এজেন্ট হলো ধূর্ত কেস। প্রতিটি ধাপে এটি আবার টুল তালিকা পাঠায় এবং এখন পর্যন্ত যা পড়েছে তা সবই। আপনি একটি বাক্য টাইপ করেছেন; উইন্ডো অনেক বেশি দেখে।
আকার অনুমান করতে হবে না। প্রতিটি প্রতিক্রিয়ায় টোকেন গণনা সহ একটি usage ফিল্ড থাকে। এই ন্যূনতম চ্যাট লুপ (OpenAI-সামঞ্জস্যপূর্ণ API, CheapTokens ডকস থেকে মডেল আইডি) একসাথে দুটি জিনিস দেখায়: প্রতিটি পালায় পুরো ইতিহাস বাইরে যায়, এবং গণনাগুলো ফিরে আসে।
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
ask() দশবার কল করুন এবং প্রথম সংখ্যাটি বাড়তে দেখুন। সেই বৃদ্ধিই এই নিবন্ধের পুরো গল্প।
উইন্ডো বনাম সর্বোচ্চ আউটপুট: দুটি ভিন্ন সংখ্যা#
প্রতিটি মডেল পৃষ্ঠায় দুটি আকার তালিকাভুক্ত থাকে, এবং নতুনরা প্রায়ই এগুলো মিশিয়ে ফেলে। উইন্ডো হলো পুরো ডেস্ক, ইনপুট এবং আউটপুট একসাথে। আউটপুট সীমা হলো একটি উত্তর কত দীর্ঘ হতে পারে: DeepSeek-V4-Flash-এর জন্য 32,768 টোকেন পর্যন্ত, GLM-5.3-Flash এবং MiniMax-M2.7-এর জন্য 8,192 পর্যন্ত।
তারা একই স্থান ভাগ করে। আপনার ইনপুট যতটুকু নেয়, উত্তরকে বাকি অংশে ফিট হতে হবে। একটি কাটা উত্তর কেমন দেখায় তা দেখতে চাইলে, কেন একটি AI উত্তর মাঝবাক্যে থেমে যায় তা ব্যাখ্যা করে।
দ্রুত যাচাই
DeepSeek-V4-Flash-এর একটি 380K উইন্ডো এবং 32,768-টোকেন আউটপুট সীমা রয়েছে। আপনি 375K টোকেন ইনপুট পাঠান। উত্তরটি প্রায় কত দীর্ঘ হতে পারে?
উত্তর দেখান
উত্তর: প্রায় 5K টোকেন, উইন্ডোতে যা বাকি আছে
উইন্ডো ইনপুট এবং আউটপুট একসাথে কভার করে: 380K − 375K প্রায় 5K রাখে, যা 32,768 সীমার নিচে।
কেন একটি দীর্ঘ চ্যাট উইন্ডো (এবং বিল) পূরণ করে#
একটি মডেল আপনার শেষ বার্তা মনে রাখে না। কথোপকথন চালিয়ে যেতে, API প্রতিটি পালায় আবার পুরো ইতিহাস পায়: পূর্ববর্তী পালাগুলো সম্পূর্ণভাবে রাখা হয়, এবং মডেলের উত্তর পরবর্তী ইনপুটের অংশ হয়ে যায়। (চ্যাট অ্যাপগুলো কখনও কখনও সবচেয়ে পুরনো বার্তাগুলো চুপচাপ বাদ দেয়; API আপনার জন্য তা করে না।)
ধরুন আপনি একটি সাপোর্ট অ্যাসিস্ট্যান্টের সাথে 30 পালা চ্যাট করেন। ধরে নিন একটি 400-টোকেন সিস্টেম প্রম্পট, প্রতি প্রশ্নে 150 টোকেন এবং প্রতি উত্তরে 450, তাই প্রতিটি বিনিময় ইতিহাসে 600 টোকেন যোগ করে।
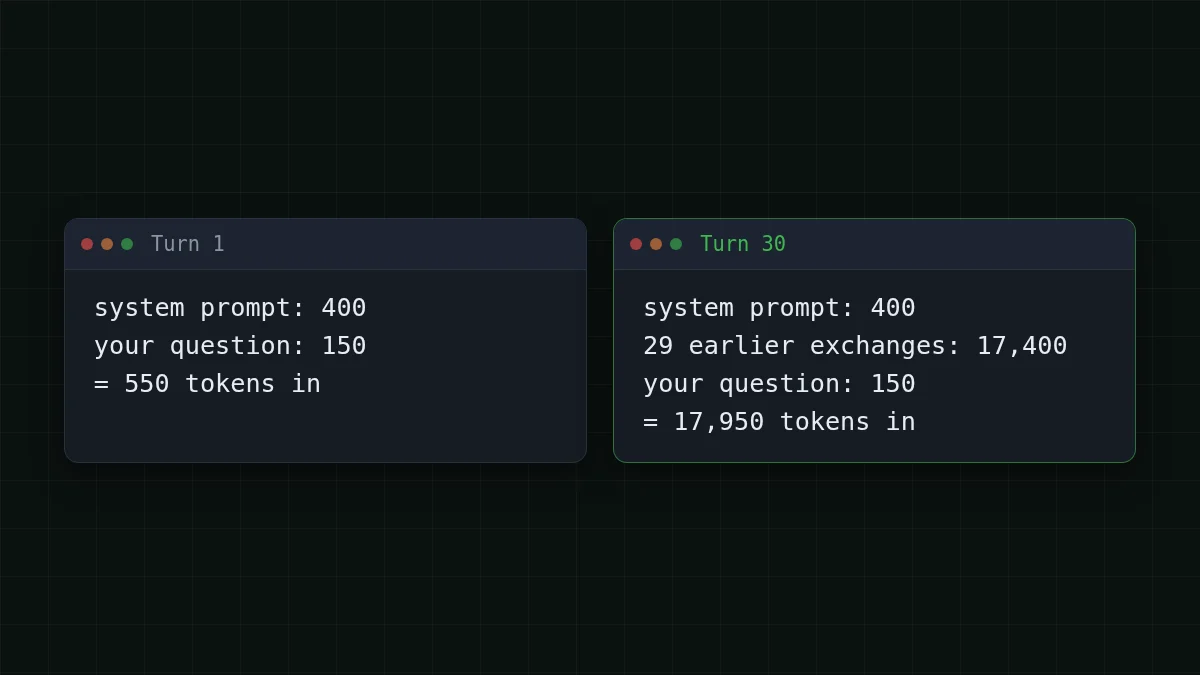
পালা 1 প্রায় 550 টোকেন পাঠায়। পালা 30 পাঠায় 400 + 150 + 29 × 600 = 17,950। পুরো চ্যাট জুড়ে যোগ করলে, প্রতিটি পালা তার নিজের শুরুর 550 টোকেন বহন করে, তাই 30 × 550 = 16,500। তার উপরে, পালা n আবার n − 1 পূর্ববর্তী বিনিময় 600 টোকেন প্রতিটি পাঠায়: 600 × 435 = 261,000, যেখানে 435 = 1 + 2 + … + 29। পুরো চ্যাটের ইনপুট 16,500 + 261,000 = 277,500 টোকেন, এবং উত্তরগুলো যোগ করে 30 × 450 = 13,500।
DeepSeek-V4-Flash-এ সেই পুরো চ্যাটের খরচ $0.0055। এখানে তিনটি মডেলই, তাদের পাশে OpenRouter রেফারেন্স মূল্য; ইনপুট এবং আউটপুট একসাথে গণনা করলে, এই চ্যাটের জন্য প্রতিটি OpenRouter-এর চেয়ে সস্তা:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | খরচ | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
মোট ২,৭৭,৫০০ ইনপুট এবং ১৩,৫০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
গড়ে, সেই চ্যাট প্রতি অনুরোধে 277,500 ÷ 30 = 9,250 টোকেন ইন এবং 450 আউট।
নিজের চ্যাট চান? নিচের সংখ্যাগুলো পরিবর্তন করুন, উদাহরণস্বরূপ 100 পালায়, এবং মোট কত দ্রুত বাড়ে তা দেখুন।
খরচ ক্যালকুলেটর
একই 30-পালার চ্যাট, গড়ে
প্রতি অনুরোধে ইনপুট টোকেন: ৯,২৫০ · প্রতি অনুরোধে আউটপুট টোকেন: ৪৫০ · প্রতিদিন অনুরোধ: ৩০
| মডেল | প্রতিদিন | প্রতি মাসে |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
এখন সৎ অংশ। 17,950 টোকেন একটি 380K উইন্ডোর 5% এর নিচে, তাই একটি সাধারণ চ্যাট খুব কমই দেয়ালে ধাক্কা খায়। যা বাড়ে তা হলো বিল এবং শব্দ। Anthropic-এর ডকুমেন্টেশন উল্লেখ করে যে টোকেন সংখ্যা বাড়ার সাথে সাথে নির্ভুলতা এবং স্মরণ ক্ষমতা কমে যায় (এটিকে কনটেক্সট রট বলে), তাই একটি বড় উইন্ডো স্বয়ংক্রিয়ভাবে ভালো নয়: আপনি কী রাখেন তা যতটা ফিট করে তার মতোই গুরুত্বপূর্ণ। দেয়ালটি যেখানে দেখা যায় তা হলো ডকুমেন্ট এবং এজেন্ট। Anthropic-এর নিজস্ব API-তে, একটি অনুরোধ যার ইনপুট একাই উইন্ডোর চেয়ে বড়, সেটি একটি 400 ত্রুটি পায়, প্রম্পট খুব দীর্ঘ। একই প্রভাবের খরচের দিকটি দেখতে, কেন একটি দীর্ঘ AI চ্যাট বেশি খরচ করে দেখুন।
আমার ডকুমেন্ট কি ফিট হবে?#
ইংরেজি টেক্সটের জন্য একটি মোটামুটি নিয়ম: একটি টোকেন প্রায় একটি শব্দের ¾, তাই টোকেন ≈ শব্দ ÷ 0.75। অন্যান্য ভাষায় সাধারণত প্রতি শব্দে বেশি টোকেন লাগে, তাই অতিরিক্ত মার্জিন রাখুন। পড়া চালিয়ে যাওয়ার আগে এটি চেষ্টা করুন।
সংখ্যা অনুমান করুন
একটি 90,000-শব্দের বই কত টোকেন?
আপনার অনুমান
০৩,০০,০০০
উত্তর দেখান
উত্তর: ১,২০,০০০
প্রায় 120,000: 90,000 ÷ 0.75 = 120,000। এটি তিনটি উইন্ডোর যেকোনোটিতে বাড়তি জায়গা সহ ফিট করে।
এখন একটি বড় কেস। ধরুন আপনার কাছে সাপোর্ট ইমেইলের একটি 150,000-শব্দের আর্কাইভ আছে এবং একটি সারাংশ চান: 150,000 ÷ 0.75 = 200,000 টোকেন। 200,000 টোকেন একটি 180K উইন্ডোর চেয়ে বেশি, তাই এই আর্কাইভের জন্য GLM-5.3-Flash (390K) বা DeepSeek-V4-Flash (380K) বেছে নিন। DeepSeek-V4-Flash এখনও DeepSeek-V4-Flash-এ 380,000 − 200,000 = 180,000 টোকেন জায়গা রাখে, যা তার 32,768-টোকেন উত্তর সীমার অধীনে একটি সারাংশের জন্য যথেষ্ট। সেই 200,000 টোকেন পড়া এবং একটি 2,000-টোকেন সারাংশ লেখার খরচ $0.0032।
একটি ছোট কেস: একটি 60,000-শব্দের রিপোর্ট হলো 60,000 ÷ 0.75 = 80,000 টোকেন। MiniMax-M2.7 এটি 100K বাড়তি সহ সামলায়, যা তার 180K উইন্ডোকে চ্যাট এবং মাঝারি আকারের ডকুমেন্টের জন্য যথেষ্ট করে তোলে।
প্রায় পূর্ণ উইন্ডোর জন্য তিনটি অভ্যাস#
1. সারাংশ করুন এবং পুনরায় শুরু করুন। পালা 30-এ অনুরোধটি 17,950 টোকেন বহন করে। মডেলকে এখন পর্যন্ত সিদ্ধান্তগুলোর একটি 200-টোকেন সারাংশ লিখতে বলুন, তারপর এটি দিয়ে একটি নতুন চ্যাট শুরু করুন। পরবর্তী অনুরোধটি 400 + 200 + 150 = 750 টোকেন ইন, এবং মডেল এখনও জানে কী গুরুত্বপূর্ণ।
2. কেবল আপনার প্রয়োজনীয় অংশ পাঠান। আপনি যে অধ্যায় সম্পর্কে জিজ্ঞাসা করছেন সেটি পেস্ট করুন, পুরো বই নয়; ফাংশনটি, পুরো রিপোজিটরি নয়। ডেস্কে কম থাকা মানে ছোট বিল, এবং Anthropic-এর কনটেক্সট-রট নোট অনুসারে, একটি মডেল যার হারানোর জন্য কম আছে।
3. স্থির অংশগুলো লীন রাখুন এবং usage দেখুন। সিস্টেম প্রম্পট, টুল সংজ্ঞা এবং দীর্ঘ টুল ফলাফল প্রতিটি ধাপে সাথে চলে। আপনি যা ব্যবহার করেন না তা ছেঁটে ফেলুন, উপরের লুপের মতো প্রতিটি প্রতিক্রিয়ার পরে টোকেন গণনা প্রিন্ট করুন, এবং max_tokens আপনার আসলে প্রয়োজনীয় দৈর্ঘ্যে সেট করুন।
যখন আপনি একটি বাস্তব মডেলে এটি চেষ্টা করতে চান, CheapTokens ডকস কয়েক লাইনে প্রথম অনুরোধ দেখায়, এবং মূল্য পৃষ্ঠা প্রতিটি মডেলের লাইভ মূল্য তালিকাভুক্ত করে। দীর্ঘ ডকুমেন্ট এবং এজেন্ট লুপের জন্য, DeepSeek-V4-Flash (380K কনটেক্সট, 32,768 আউটপুট টোকেন পর্যন্ত, পিক আওয়ার ছাড়া একটি নির্দিষ্ট মূল্য) এবং GLM-5.3-Flash (390K, তিনটির মধ্যে বৃহত্তম উইন্ডো) প্রথমে দেখার মতো।


