সমস্যা সমাধানগাইড
রিকোয়েস্ট খুব দীর্ঘ: 400 বনাম 413, কনটেক্সট উইন্ডো এবং max_tokens
একটি 413 (অনেক বেশি বাইট) থেকে একটি টোকেন-দৈর্ঘ্য ত্রুটি (সাধারণত একটি 400) আলাদা করুন, কনটেক্সট উইন্ডোর বিরুদ্ধে ইনপুট প্লাস max_tokens যাচাই করুন, এবং রিকোয়েস্ট ছোট করুন।
এই পৃষ্ঠায়
আপনার চ্যাট চল্লিশ টার্ন পর্যন্ত ঠিকঠাক চলছিল, তারপর প্রতিটি রিকোয়েস্ট ব্যর্থ হতে শুরু করল। সংক্ষিপ্ত উত্তর: "request too long" দুটি ভিন্ন সীমা লুকিয়ে রাখে। একটি 413 মানে রিকোয়েস্টটি বাইটে খুব বড় এবং কোনো মডেল এটি দেখার আগেই ফিরিয়ে দেওয়া হয়েছে। যদি ত্রুটিটি টোকেনে দৈর্ঘ্যের অভিযোগ করে (সাধারণত 400-শ্রেণির অবৈধ রিকোয়েস্ট), তাহলে আপনার ইনপুট এবং আপনি যে উত্তর চাইছেন তা কনটেক্সট উইন্ডোতে ফিট করছে না; কোনটি তা দেখতে error.message পড়ুন। সমাধান হলো পরিমাপ করা, তারপর ছাঁটা।
এই গাইডটি দেখায় কীভাবে দুটিকে আলাদা করবেন, পাঠানোর আগে কীভাবে গণিত যাচাই করবেন, এবং একটি রিকোয়েস্ট ছোট করার চারটি উপায়। যদি শব্দটি নতুন হয়, কনটেক্সট উইন্ডো কী সহজ ভাষায় তা কভার করে।
দুটি সীমা, দুটি ত্রুটি#
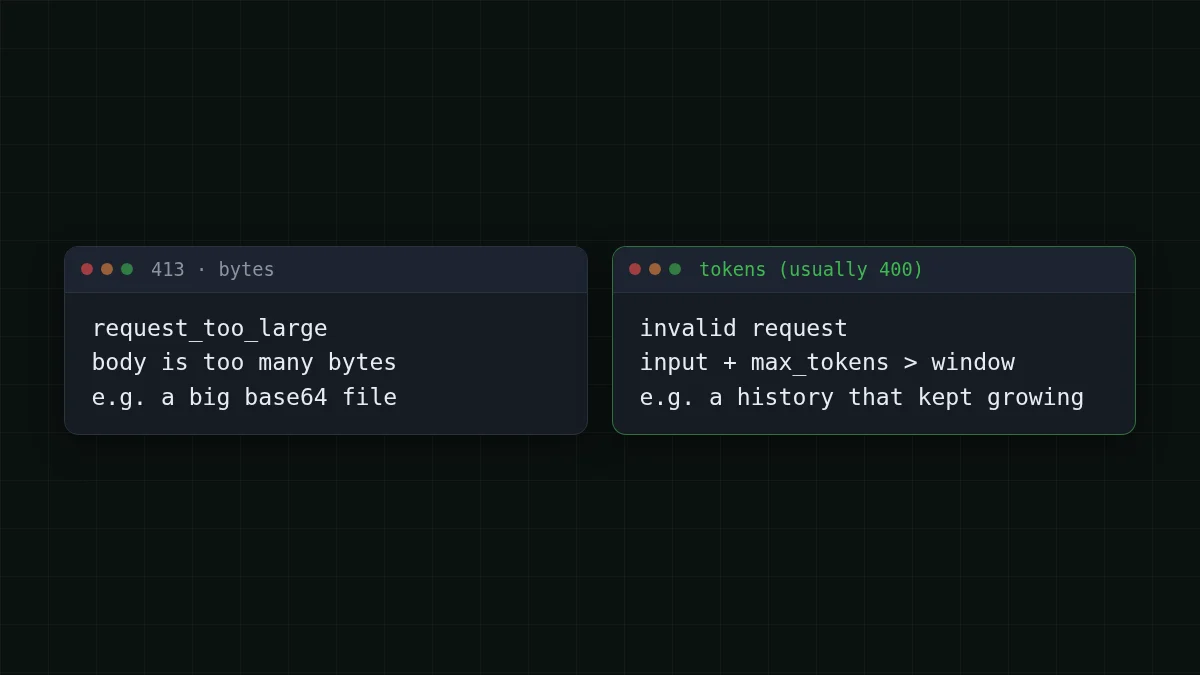
একটি 413 হলো ডাকঘর একটি পার্সেল প্রত্যাখ্যান করছে যা খুব বড়; একটি টোকেন ত্রুটি হলো মডেল বলছে চিঠিটি তার পড়ার জানালায় ফিট হবে না। তারা ভিন্ন জায়গায় ব্যর্থ হয় এবং ভিন্ন সমাধান প্রয়োজন।
Anthropic-এর API ত্রুটি পৃষ্ঠা (২৯ অক্টোবর ২০২৬-এ যাচাইকৃত) 413 request_-কে বর্ণনা করে এমন একটি রিকোয়েস্ট হিসেবে যা সর্বোচ্চ বাইট সংখ্যা অতিক্রম করে: Messages API-এর জন্য 128 MB, Batch API-এর জন্য 256 MB, Files API-এর জন্য 500 MB। একটি 400 invalid_ রিকোয়েস্টের ফরম্যাট বা বিষয়বস্তুর সমস্যাগুলি কভার করে। এগুলি Anthropic-এর সীমা। তাদের পৃষ্ঠা টোকেন-গণনার বার্তা তালিকাভুক্ত করে না, এবং OpenAI-এর ত্রুটি-কোড গাইডও করে না, তাই আপনি একটি ফোরাম থ্রেডে যে সঠিক শব্দচয়ন দেখেছেন তার উপর লজিক তৈরি করবেন না।
বাস্তবে, শুধুমাত্র টেক্সট চ্যাট সাধারণত বাইটের অনেক আগে টোকেনে বাড়ে। বাইট সমস্যা হয়ে ওঠে যখন আপনি base64 ছবি বা সম্পূর্ণ নথি সংযুক্ত করেন। টোকেন সমস্যা হয়ে ওঠে যখন ইতিহাস বাড়ে, এবং এটাই সাধারণ ক্ষেত্র।
জোড়া মেলান
প্রতিটি উপসর্গকে তার কারণের সাথে মেলান
বাম দিকের একটি আইটেমে ট্যাপ করুন, তারপর তার জোড়ায়
- 413 request_too_largeবডিতে অনেক বেশি বাইট, উদাহরণস্বরূপ একটি বড় base64 সংযুক্তি
- একটি বিশাল লগ পেস্ট করার ঠিক পরে একটি টোকেন-দৈর্ঘ্য ত্রুটিপ্রম্পট একাই কনটেক্সট উইন্ডোর চেয়ে বেশি টোকেন
- 380K মডেলে max_tokens=32768 সহ প্রায় 375K টোকেনের প্রম্পটের পরে 400একসাথে তারা উইন্ডো অতিক্রম করতে পারে
- একই ইতিহাস, ভিন্ন মডেলপ্রতিটি মডেলের উইন্ডো পরীক্ষা করুন: একটি যেটিতে ফিট হয় সেটি অন্যটিতে নাও ফিট হতে পারে
ত্রুটি বডি হলো JSON যাতে একটি শীর্ষ-স্তরের type: error, একটি error অবজেক্ট যার নিজস্ব type এবং message, এবং একটি রিকোয়েস্ট আইডি থাকে। error.message পড়ুন এবং রিকোয়েস্ট আইডি রাখুন; অফিসিয়াল SDK-গুলির সাথে, স্ট্রিং মেলানোর পরিবর্তে টাইপড এক্সেপশন ধরুন।
পাঠানোর আগে গণিত যাচাই করুন#
যে অভ্যাসটি সবচেয়ে বেশি সময় বাঁচায়: ত্রুটির জন্য অপেক্ষা করবেন না। প্রতিটি কলের আগে, তিনটি জিনিস যোগ করুন এবং সেগুলিকে উইন্ডোর সাথে তুলনা করুন।
- আপনার বার্তাগুলিতে টোকেন (সিস্টেম প্রম্পট, ইতিহাস, নতুন প্রশ্ন)।
- আপনি যে
max_tokensচাইছেন। - মডেলের কনটেক্সট উইন্ডো।
ইনপুট প্লাস অনুরোধকৃত উত্তর উইন্ডোর ভিতরে রাখুন। CheapTokens-এ উইন্ডোগুলি হলো GLM-5.3-Flash-এর জন্য 390K, DeepSeek-V4-Flash-এর জন্য 380K এবং MiniMax-M2.7-এর জন্য 180K; উত্তরগুলি GLM এবং MiniMax-এ 8,192 টোকেন পর্যন্ত এবং DeepSeek-V4-Flash-এ 32,768 পর্যন্ত যায়। বর্তমান তালিকার জন্য মূল্য এবং মডেল পৃষ্ঠা দেখুন।
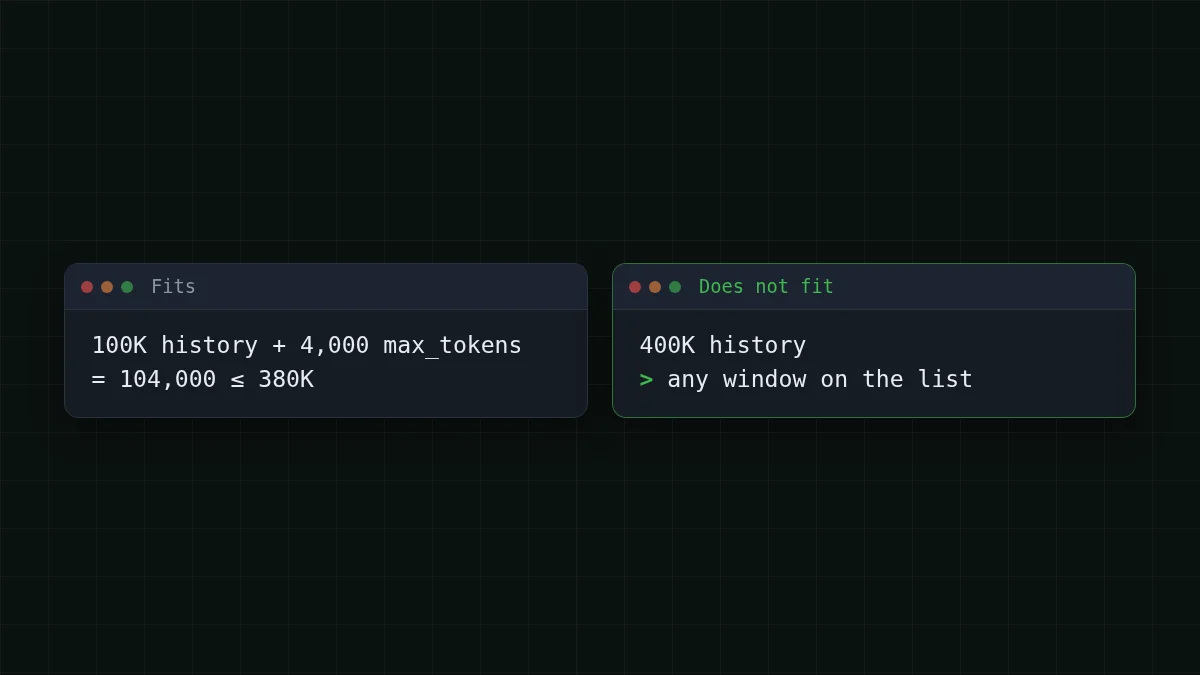
ধরুন আপনার এজেন্ট 100K-টোকেন ইতিহাস পাঠায় এবং 4,000 টোকেন ফেরত চায়। সেটি হলো 100,000 + 4,000 = 104,000 টোকেন, তিনটির যেকোনোটিতে আরামদায়ক। এখন আরও পঞ্চাশ ধাপ পরে একই এজেন্ট: 400K। তালিকার কোনো উইন্ডোই এটি নেয় না, আপনি যতই max_tokens সেট করুন না কেন। সেই মুহূর্তেই ত্রুটি দেখা যায়, এবং এটি হঠাৎ দেখায় কারণ প্রতিটি টার্নে ইতিহাস একটু একটু করে বেড়েছে।
একটি মোটামুটি কাউন্টার একটি গার্ডের জন্য যথেষ্ট। ইংরেজি টেক্সট প্রতি টোকেনে গড়ে প্রায় 4 অক্ষর; কোড এবং অ-ইংরেজি টেক্সট প্রতি অক্ষরে বেশি টোকেন ব্যবহার করে, তাই একটি মার্জিন রাখুন:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
শেষ লাইনটি আপনার ক্যালিব্রেশন: usage. হলো যা API আসলে গণনা করেছে। কয়েকবার rough_-এর সাথে তুলনা করুন এবং আপনার নিজের টেক্সট অনুযায়ী ভাজক এবং মার্জিন সামঞ্জস্য করুন।
একটি রিকোয়েস্ট ছোট করার চারটি উপায়#
এই ক্রমে, যে সস্তা সমাধান কাজ করে তা বেছে নিন।
1. max_tokens কমান। শুধু আপনার প্রয়োজনীয় উত্তর চান: ইনপুট প্লাস max_tokens হলো যা আপনাকে উইন্ডোর ভিতরে রাখতে হবে, এবং প্রতিটি মডেলের উত্তরের উপর নিজস্ব ক্যাপ রয়েছে (উপরে 8,192 বা 32,768 টোকেন)। max_tokens উত্তরের প্রয়োজনের চেয়ে বেশি সেট করবেন না, এবং মডেলের উত্তরের ক্যাপের উপরে নয়। যদি উত্তর আপনার সেট করা সীমায় থেমে যায়, এটি finish_ দিয়ে শেষ হয়, যার নিজস্ব সমাধান রয়েছে।
2. ইতিহাস ছাঁটুন। পুরোনো টার্নগুলি বাদ দিন, সিস্টেম প্রম্পট এবং শেষ কয়েকটি বিনিময় রাখুন। উপরের trim ফাংশনটি ঠিক এটাই করে। একটি এজেন্টের জন্য, বাল্কও কাটুন: 5,000 লাইনের টুল আউটপুট এজেন্ট সেগুলি ব্যবহার করার পরে সম্পূর্ণ রাখা খুব কমই প্রয়োজন।
3. বাদ দেওয়ার পরিবর্তে সারসংক্ষেপ করুন। যখন পুরোনো টার্নগুলি গুরুত্বপূর্ণ, মডেলকে একবার সেগুলি একটি সংক্ষিপ্ত নোটে সংকুচিত করতে বলুন, তারপর পুরোনো বার্তাগুলি সেই নোট দিয়ে প্রতিস্থাপন করুন। আপনি একটি অতিরিক্ত কলের জন্য অর্থ প্রদান করেন এবং থ্রেডটি রাখেন।
4. একটি বড় উইন্ডোতে স্যুইচ করুন। MiniMax-M2.7 (180K) থেকে GLM-5.3-Flash (390K) বা DeepSeek-V4-Flash (380K)-এ যাওয়া মডেল আইডির এক-লাইন পরিবর্তন। যদি আপনার দীর্ঘ উত্তরও প্রয়োজন হয়, DeepSeek-V4-Flash 32,768 আউটপুট টোকেন পর্যন্ত অনুমতি দেয়, এবং তিনটিই একটি ব্যালেন্স শেয়ার করে, তাই স্যুইচিংয়ে সেটআপে কিছু খরচ হয় না।
চেকলিস্ট
একটি ব্যর্থ রিকোয়েস্ট পুনরায় পাঠানোর আগে
একটি দীর্ঘ ইতিহাসের খরচ#
ছাঁটা শুধু ত্রুটি সম্পর্কে নয়। একটি এজেন্টের প্রতিটি ধাপ পুরো ইতিহাস পুনরায় পাঠায়, তাই একটি ফোলা ইতিহাসও বিলের ব্যয়বহুল অংশ। 30 ধাপের একটি কাজ নিন যেখানে প্রতিটি ধাপ প্রায় 100K টোকেন পাঠায় এবং প্রায় 1,500 ফেরত পায়:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ৩০টি অনুরোধ | OpenRouter, ৩০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
প্রতি অনুরোধে ১,০০,০০০ ইনপুট এবং ১,৫০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
টেবিলটি লাইভ রেট সহ প্রতিটি মডেলে একই কাজের মূল্য দেয়। ইতিহাস এক-চতুর্থাংশে কাটুন এবং ইনপুট দিক প্রায় তিন-চতুর্থাংশ কমে যায়। আপনার নিজের এজেন্ট কোথায় টোকেন ব্যয় করে তা দেখতে, Python-এ প্রতি রিকোয়েস্টে ব্যবহার ট্র্যাক করুন; প্রক্রিয়ার জন্য, কেন এজেন্টরা এত টোকেন ব্যবহার করে একটি 20-ধাপের উদাহরণের মধ্য দিয়ে যায়।
DeepSeek-V4-Flash বর্তমানে প্রতি 1M ইনপুট টোকেনে $0.015 এবং প্রতি 1M আউটপুট টোকেনে $0.10 খরচ করে, যেকোনো সময়ে একই মূল্য। আপনার নিজের সংখ্যা চেষ্টা করুন:
খরচ ক্যালকুলেটর
100K ইতিহাস সহ একটি 30-ধাপের এজেন্ট কাজ
প্রতি অনুরোধে ইনপুট টোকেন: ১,০০,০০০ · প্রতি অনুরোধে আউটপুট টোকেন: ১,৫০০ · প্রতিদিন অনুরোধ: ৩০
| মডেল | প্রতিদিন | প্রতি মাসে |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
যদি এটি এখনও ব্যর্থ হয়#
ধীর লিঙ্কে দীর্ঘ রিকোয়েস্টের একটি আলাদা ব্যর্থতা রয়েছে: Anthropic বড় max_tokens সহ দীর্ঘ রিকোয়েস্টের জন্য স্ট্রিমিং বা Batch API-এর পরামর্শ দেয়, কারণ নেটওয়ার্ক নিষ্ক্রিয় সংযোগ বাদ দিতে পারে, এবং এর SDK-গুলি অ-স্ট্রিমিং রিকোয়েস্ট 10 মিনিটের মধ্যে শেষ হওয়ার আশা করে। যদি ত্রুটিটি 400-এর পরিবর্তে টাইমআউট বা বাদ দেওয়া সংযোগ হয়, সংযোগ ত্রুটি দেখুন এবং stream=True সেট করুন।
যদি বার্তাটি 401 বা 404 হয়, সমস্যাটি পরিবর্তে কী, বেস URL বা মডেল আইডি: API 401 বা 404 ত্রুটি। সঠিক বেস URL, মডেল আইডি এবং উদাহরণের জন্য, CheapTokens ডক্স খুলুন।


