Решение проблемИнструкция
Запрос слишком длинный: 400 или 413, контекст и max_tokens
Как отличить 413 (слишком много байт) от ошибки длины в токенах (обычно 400), сверить вход и max_tokens с окном контекста и уменьшить запрос.
Содержание
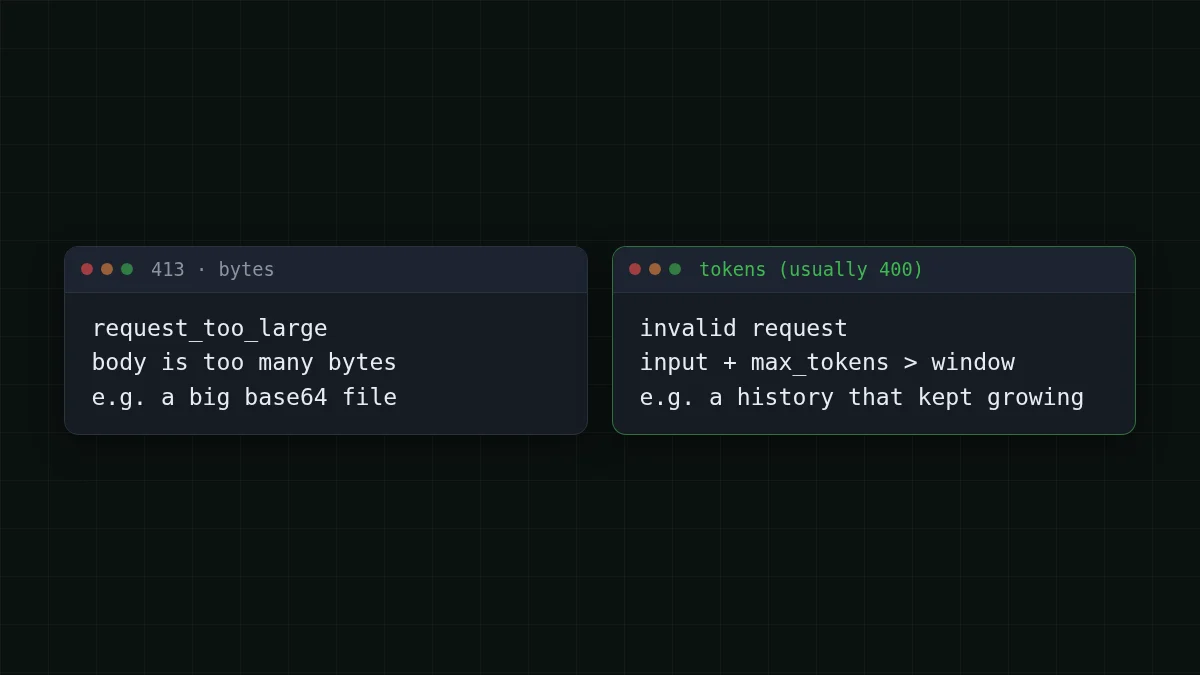
Чат сорок ходов работал без проблем, а потом каждый запрос стал падать. Короткий ответ: за словами «запрос слишком длинный» прячутся два разных лимита. 413 значит, что запрос слишком велик в байтах и его отклонили до того, как его увидела модель. Если же ошибка жалуется на длину в токенах (обычно это 400-я, неверный запрос), вход плюс ответ, который вы просите, не помещаются в окно контекста; какой случай ваш, видно в error.message. Лечится так: сначала измерить, потом сократить.
Ниже — как отличить одно от другого, как проверить арифметику до отправки и четыре способа уменьшить запрос. Если термин новый, что такое окно контекста объяснено простыми словами.
Два лимита — две ошибки#
413 — это почта, которая отказывается принять слишком большую посылку; ошибка по токенам — это модель, которая говорит, что письмо не поместится в её окно чтения. Ломаются они в разных местах и чинятся по-разному.
Страница ошибок API Anthropic (проверено 29 октября 2026) описывает 413 request_ как запрос, превысивший максимум байт: 128 МБ для Messages API, 256 МБ для Batch API, 500 МБ для Files API. 400 invalid_ — проблемы с форматом или содержимым запроса. Это лимиты Anthropic. Сообщения о числе токенов на этой странице нет, как и в руководстве OpenAI по кодам ошибок, поэтому не стройте логику на точной формулировке из ветки форума.
На практике текстовые чаты обычно упираются в токены задолго до байтов. Байты становятся проблемой, когда вы прикладываете картинки в base64 или целые документы. Токены — когда растёт история, и это самый частый случай.
Найдите пары
Сопоставьте симптом и причину
Нажмите на элемент слева, затем на его пару
- 413 request_too_largeТело запроса слишком большое в байтах, например огромное вложение в base64
- Ошибка длины в токенах сразу после вставки огромного логаОдин промпт уже длиннее окна контекста в токенах
- 400 после промпта около 375K токенов с max_tokens=32768 на модели с окном 380KВместе они могут выйти за окно
- Та же история, другая модельСверьте окно каждой модели: история, что влезает в одну, может не влезть в другую
Тело ошибки — JSON с верхним type: error, объектом error со своими type и message и идентификатором запроса. Читайте error.message и сохраняйте идентификатор; в официальных SDK ловите типизированное исключение, а не сравнивайте строки.
Проверьте арифметику до отправки#
Привычка, которая экономит больше всего времени: не ждать ошибки. Перед каждым вызовом сложите три вещи и сравните с окном.
- Токены в ваших сообщениях (системный промпт, история, новый вопрос).
max_tokens, который вы просите.- Окно контекста модели.
Держите вход плюс запрошенный ответ внутри окна. Окна в CheapTokens: 390K у GLM-5.3-Flash, 380K у DeepSeek-V4-Flash и 180K у MiniMax-M2.7; ответ — до 8 192 токенов у GLM и MiniMax и до 32 768 у DeepSeek-V4-Flash. Актуальный список — на страницах цен и моделей.
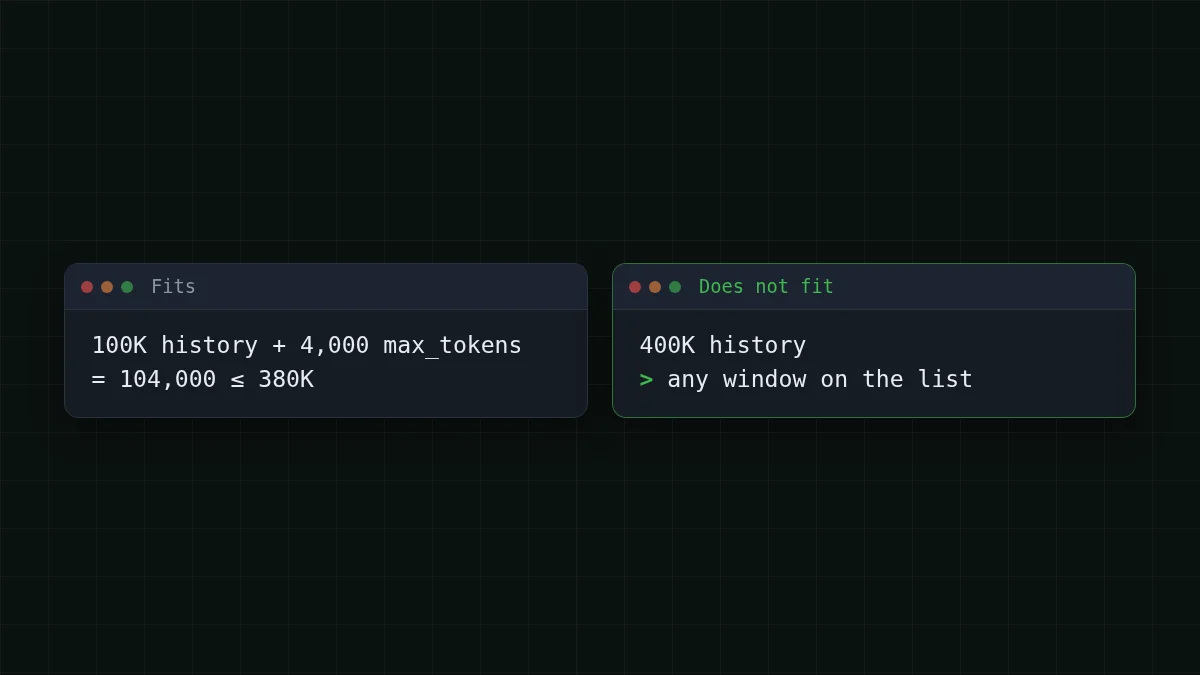
Допустим, агент шлёт историю в 100K токенов и просит в ответ 4 000. Это 100 000 + 4 000 = 104 000 токенов — спокойно для любой из трёх моделей. А теперь тот же агент ещё через пятьдесят шагов: 400K. Ни одно окно из списка его не вместит, какой бы max_tokens вы ни поставили. Ошибка появляется именно тогда, и кажется внезапной лишь потому, что история росла понемногу каждый ход.
Для защиты хватит грубого счётчика. В английском тексте в среднем около 4 символов на токен; код и не английский текст дают больше токенов на символ, так что оставляйте запас:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # окно DeepSeek-V4-Flash
MAX_OUT = 4_000        # ответ, который вы просите
MARGIN = 0.85          # грубый счётчик, держим 15% запаса

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # сначала выбрасываем самый старый ход
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system первым

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
Последняя строка — ваша калибровка: usage. — это то, сколько токенов насчитал API. Сравните его с rough_ пару раз и подберите делитель и запас под свой текст.
Четыре способа уменьшить запрос#
Выбирайте самый дешёвый способ, который работает, в таком порядке.
1. Снизьте max_tokens. Просите только тот ответ, который нужен: в окне должны уместиться вход плюс max_tokens, а у каждой модели свой потолок ответа (8 192 или 32 768 токенов выше). Не ставьте max_tokens больше, чем нужно ответу, и выше потолка ответа модели. Если ответ остановился на заданном вами лимите, он заканчивается finish_, и у этого есть своё решение.
2. Обрежьте историю. Выбросьте самые старые ходы, оставьте системный промпт и несколько последних реплик. Функция trim выше делает именно это. У агента ещё и режьте объём: вывод инструмента на 5 000 строк редко нужен целиком после того, как агент им воспользовался.
3. Сожмите вместо того, чтобы выбрасывать. Когда старые ходы важны, один раз попросите модель сжать их в короткую заметку и замените ими старые сообщения. Платите за один лишний вызов и сохраняете нить разговора.
4. Перейдите на окно побольше. С MiniMax-M2.7 (180K) на GLM-5.3-Flash (390K) или DeepSeek-V4-Flash (380K) — это правка одного id модели. Если нужны ещё и длинные ответы, DeepSeek-V4-Flash отдаёт до 32 768 токенов, а баланс у всех трёх общий, так что переключение не требует настройки.
Чек-лист
Перед повторной отправкой упавшего запроса
Сколько стоит длинная история#
Обрезка нужна не только из-за ошибок. Каждый шаг агента заново отправляет всю историю, так что раздутая история ещё и самая дорогая часть счёта. Возьмём задачу в 30 шагов, где на каждом шаге уходит около 100K токенов, а возвращается около 1 500:
| Модель | Вход $/1M | Выход $/1M | За запрос | 30 запросов | OpenRouter, 30 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100 000 входных и 1 500 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Таблица считает эту же задачу по каждой модели по живым тарифам. Сократите историю вчетверо — и входная часть упадёт примерно на три четверти. Где ваш агент тратит токены, поможет увидеть учёт расхода по запросам на Python; а как это устроено — в разборе почему агенты расходуют так много токенов на примере из 20 шагов.
DeepSeek-V4-Flash сейчас стоит $0.015 за 1M входных токенов и $0.10 за 1M выходных, одна цена в любое время суток. Подставьте свои числа:
Калькулятор стоимости
Задача агента в 30 шагов с историей 100K
Входные токены на запрос: 100 000 · Выходные токены на запрос: 1 500 · Запросов в день: 30
| Модель | В день | В месяц |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
Если всё равно падает#
У длинных запросов есть и отдельная беда — медленное соединение. Anthropic советует стриминг или Batch API для длинных запросов с большим max_tokens, потому что сети могут обрывать простаивающие соединения, а её SDK ждут, что запрос без стриминга уложится в 10 минут. Если ошибка — таймаут или обрыв, а не 400, смотрите ошибки соединения и включите stream=True.
Если пришла 401 или 404, дело в ключе, базовом адресе или id модели: ошибка API 401 или 404. Точный базовый адрес, id моделей и примеры — в документации CheapTokens.


