Sorun gidermeKılavuz
İstek çok uzun: 400 vs 413, bağlam penceresi ve max_tokens
Bir 413'ü (çok fazla bayt) token uzunluğu hatasından (genellikle 400) ayırt edin, girdi artı max_tokens'ı bağlam penceresine göre kontrol edin ve isteği küçültün.
Bu sayfada
Sohbetiniz kırk tur boyunca sorunsuz çalıştı, sonra her istek başarısız olmaya başladı. Kısa cevap: "request too long" iki farklı sınırı gizler. Bir 413, isteğin bayt cinsinden çok büyük olduğunu ve herhangi bir model görmeden reddedildiğini gösterir. Hata, token cinsinden uzunluktan şikayet ediyorsa (genellikle 400 sınıfı geçersiz istek), girdiniz artı istediğiniz yanıt bağlam penceresine sığmıyor demektir; hangisi olduğunu görmek için error.message okuyun. Çözüm ölçmek, sonra kırpmaktır.
Bu kılavuz ikisini nasıl ayırt edeceğinizi, göndermeden önce matematiği nasıl kontrol edeceğinizi ve bir isteği küçültmenin dört yolunu gösterir. Terim yeniyse, bağlam penceresi nedir bunu sade bir dille anlatır.
İki sınır, iki hata#
413, postanenin çok büyük bir koliye teslim etmeyi reddetmesidir; token hatası ise modelin mektubun okuma penceresine sığmayacağını söylemesidir. Farklı yerlerde başarısız olurlar ve farklı düzeltmeler gerektirirler.
Anthropic'in API hataları sayfası (29 Ekim 2026'da kontrol edildi) 413 request_'yi maksimum bayt sayısını aşan bir istek olarak tanımlar: Messages API için 128 MB, Batch API için 256 MB, Files API için 500 MB. Bir 400 invalid_, isteğin biçimi veya içeriğiyle ilgili sorunları kapsar. Bunlar Anthropic'in sınırlarıdır. Sayfaları bir token sayısı mesajı listelemez, OpenAI'nin hata kodları kılavuzu da listelemez, bu yüzden bir forum başlığında gördüğünüz tam ifadeye göre mantık kurmayın.
Pratikte, yalnızca metin içeren sohbetler genellikle baytlardan çok önce token cinsinden büyür. Baytlar, base64 görüntüler veya tüm belgeler eklediğinizde sorun olur. Tokenlar, geçmiş büyüdüğünde sorun olur ve bu yaygın durumdur.
Eşleştir
Her belirtiyi nedeniyle eşleştirin
Soldaki bir öğeye, ardından eşine dokun
- 413 request_too_largeGövde çok fazla bayt, örneğin büyük bir base64 eki
- Kocaman bir günlük yapıştırdıktan hemen sonra token uzunluğu hatasıİstem tek başına bağlam penceresinden daha fazla token
- 380K'lık bir modelde max_tokens=32768 ile yaklaşık 375K token'lık bir istemden sonra 400Birlikte pencereyi aşabilirler
- Aynı geçmiş, farklı modelHer modelin penceresini kontrol edin: birine sığan geçmiş diğerine sığmayabilir
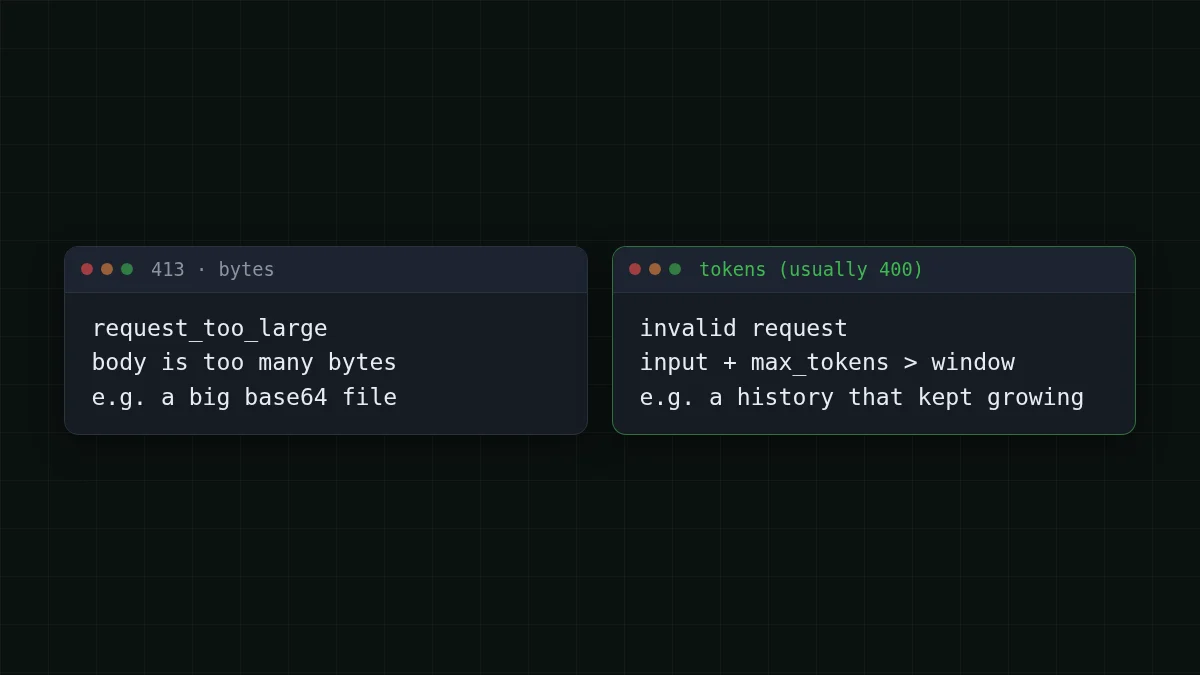
Hata gövdesi, üst düzey bir type: error, kendi type ve message'sine sahip bir error nesnesi ve bir istek kimliği içeren JSON'dur. error.message okuyun ve istek kimliğini saklayın; resmi SDK'larda dizeleri eşleştirmek yerine tipli istisnayı yakalayın.
Göndermeden önce matematiği kontrol edin#
En çok zaman kazandıran alışkanlık: hatayı beklemeyin. Her çağrıdan önce üç şeyi toplayın ve pencereyle karşılaştırın.
- Mesajlarınızdaki tokenlar (sistem istemi, geçmiş, yeni soru).
- İstediğiniz
max_tokens. - Modelin bağlam penceresi.
Girdi artı istenen yanıtı pencere içinde tutun. CheapTokens'teki pencereler GLM-5.3-Flash için 390K, DeepSeek-V4-Flash için 380K ve MiniMax-M2.7 için 180K'dır; yanıtlar GLM ve MiniMax'te 8.192 token'a, DeepSeek-V4-Flash'te 32.768 token'a kadar çıkar. Güncel liste için fiyatlandırma ve model sayfalarına bakın.
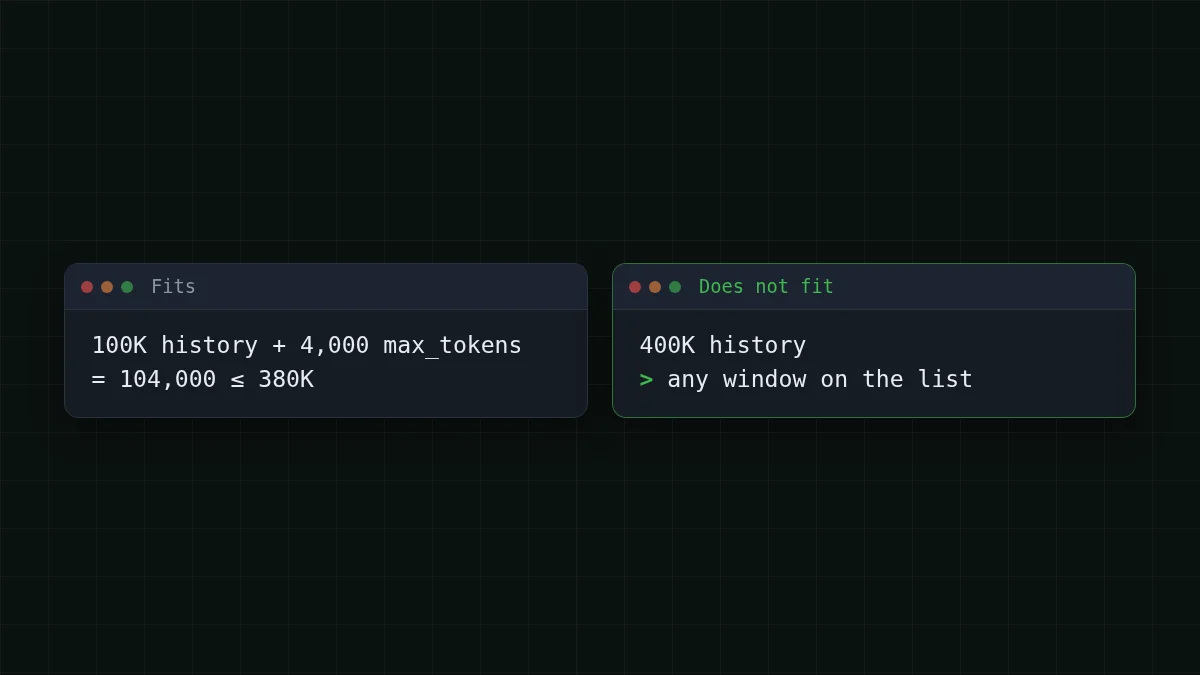
Ajanınızın 100K token'lık bir geçmiş gönderdiğini ve 4.000 token geri istediğini varsayalım. Bu 100.000 + 4.000 = 104.000 token'dır, üçünün herhangi birinde rahatça sığar. Şimdi aynı ajan elli adım daha sonra: 400K. Hangi max_tokens'yi ayarlarsanız ayarlayın, listedeki hiçbir pencere bunu almaz. Hata o anda ortaya çıkar ve ani görünmesinin tek nedeni geçmişin her turda biraz büyümesidir.
Kaba bir sayıcı bir koruma için yeterlidir. İngilizce metin token başına ortalama yaklaşık 4 karakterdir; kod ve İngilizce olmayan metin karakter başına daha fazla token kullanır, bu yüzden bir pay bırakın:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
Son satır kalibrasyonunuzdur: usage. API'nin gerçekte saydığıdır. Birkaç kez rough_ ile karşılaştırın ve böleni ve payı kendi metninize göre ayarlayın.
Bir isteği küçültmenin dört yolu#
İşe yarayan en ucuz düzeltmeyi bu sırayla seçin.
1. max_tokens'ı düşürün. Yalnızca ihtiyacınız olan yanıtı isteyin: girdi artı max_tokens pencere içinde tutmanız gereken şeydir ve her modelin yanıt üzerinde kendi üst sınırı vardır (yukarıda 8.192 veya 32.768 token). max_tokens'yi yanıtın ihtiyacından yüksek ve modelin yanıt üst sınırının üzerinde ayarlamayın. Yanıt belirlediğiniz sınırda durursa finish_ ile biter, bunun kendi çözümü vardır.
2. Geçmişi kırpın. En eski turları atın, sistem istemini ve son birkaç alışverişi tutun. Yukarıdaki trim işlevi tam olarak bunu yapar. Bir ajan için, hacmi de kesin: 5.000 satırlık araç çıktılarının ajan bunları kullandıktan sonra tam olarak kalması nadiren gerekir.
3. Atmak yerine özetleyin. Eski turlar önemli olduğunda, modelden bir kez bunları kısa bir nota sıkıştırmasını isteyin, sonra eski mesajları o notla değiştirin. Bir ekstra çağrı için ödeme yaparsınız ve konuyu korursunuz.
4. Daha büyük bir pencereye geçin. MiniMax-M2.7'den (180K) GLM-5.3-Flash'e (390K) veya DeepSeek-V4-Flash'e (380K) geçmek model kimliğinde tek satırlık bir değişikliktir. Uzun yanıtlara da ihtiyacınız varsa, DeepSeek-V4-Flash 32.768 çıktı token'ına kadar izin verir ve üçü de tek bir bakiyeyi paylaşır, bu yüzden geçiş kurulumda hiçbir maliyet getirmez.
Kontrol listesi
Başarısız bir isteği yeniden göndermeden önce
Uzun bir geçmişin maliyeti#
Kırpma yalnızca hatalarla ilgili değildir. Bir ajanın her adımı tüm geçmişi yeniden gönderir, bu yüzden şişkin bir geçmiş aynı zamanda faturanın pahalı kısmıdır. Her adımın yaklaşık 100K token gönderdiği ve yaklaşık 1.500 geri aldığı 30 adımlık bir görev alın:
| Model | Giriş $/1M | Çıkış $/1M | İstek başına | 30 istek | OpenRouter, 30 istek |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
İstek başına 100.000 giriş ve 1.500 çıkış token'ı. 1M token başına fiyatlar günceldir ve tarifelerimizle birlikte değişir; OpenRouter sütunu aynı iş yükü için referans fiyatları gösterir.
Tablo, aynı görevi canlı oranlarla her modelde fiyatlandırır. Geçmişi dörtte bire indirin, girdi tarafı yaklaşık dörtte üç düşer. Kendi ajanınızın tokenları nerede harcadığını görmek için Python'da istek başına kullanımı izleyin; mekanik için, ajanlar neden bu kadar çok token kullanır 20 adımlık bir örnek üzerinden geçer.
DeepSeek-V4-Flash şu anda 1M girdi token'ı başına $0.015 ve 1M çıktı token'ı başına $0.10 tutarındadır, her saatte tek fiyat. Kendi sayılarınızı deneyin:
Maliyet hesaplayıcı
100K geçmişli 30 adımlık bir ajan görevi
İstek başına giriş token'ı: 100.000 · İstek başına çıkış token'ı: 1.500 · Günlük istek sayısı: 30
| Model | Günlük | Aylık |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
Hâlâ başarısız olursa#
Yavaş bir bağlantı üzerinden uzun isteklerin ayrı bir başarısızlığı vardır: Anthropic, büyük bir max_tokens içeren uzun istekler için akış veya Batch API önerir, çünkü ağlar boşta bağlantıları düşürebilir ve SDK'ları akışsız isteklerin 10 dakika içinde tamamlanmasını bekler. Hata 400 yerine bir zaman aşımı veya düşen bir bağlantıysa, bağlantı hatalarına bakın ve stream=True ayarlayın.
Mesaj 401 veya 404 ise, sorun anahtar, temel URL veya model kimliğindedir: API 401 veya 404 hatası. Tam temel URL, model kimlikleri ve örnekler için CheapTokens belgelerini açın.


