Petición demasiado larga: 400 vs 413, ventana de contexto y max_tokens
Distingue un 413 (demasiados bytes) de un error de longitud de tokens (normalmente un 400), comprueba la entrada más max_tokens contra la ventana de contexto y reduce la petición.
En esta página
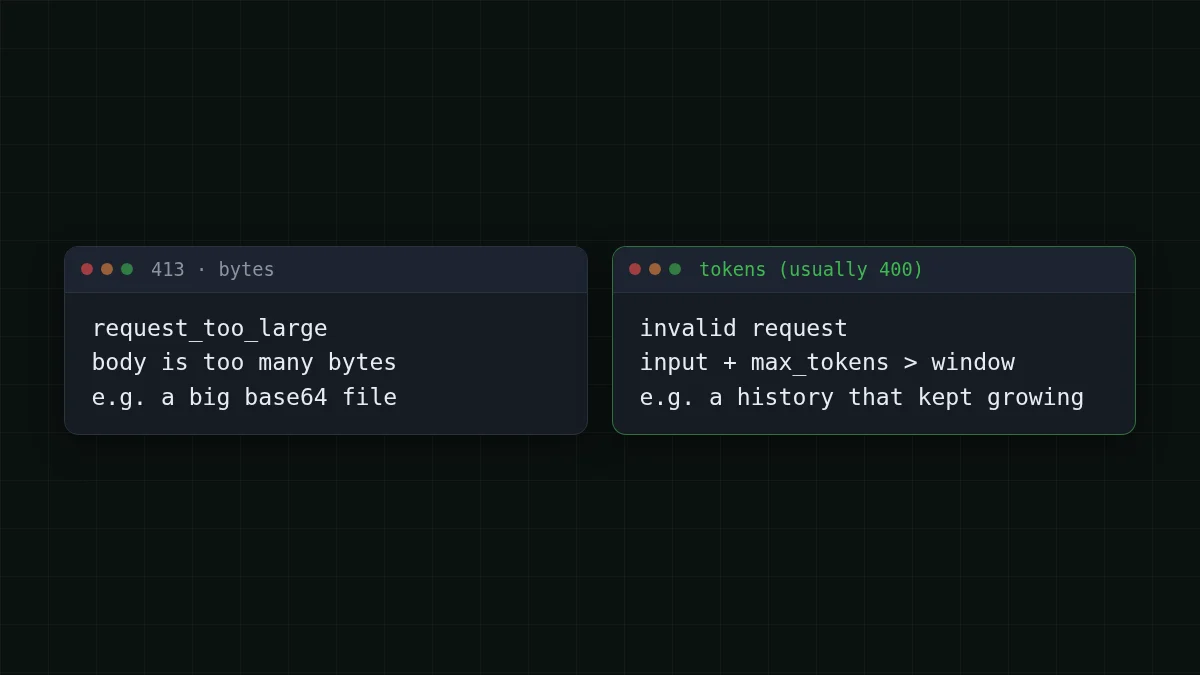
Tu chat funcionó bien durante cuarenta turnos y luego todas las peticiones empezaron a fallar. La respuesta corta: "request too long" oculta dos límites distintos. Un 413 significa que la petición es demasiado grande en bytes y fue rechazada antes de que ningún modelo la viera. Si el error se queja de la longitud en tokens (normalmente una petición inválida de la clase 400), tu entrada más la respuesta que pides no caben en la ventana de contexto; lee error.message para ver cuál es. La solución es medir y luego recortar.
Esta guía muestra cómo distinguir los dos, cómo comprobar las cuentas antes de enviar y cuatro formas de reducir una petición. Si el término es nuevo, qué es una ventana de contexto lo explica en palabras sencillas.
Dos límites, dos errores#
Un 413 es la oficina de correos rechazando un paquete demasiado grande; un error de tokens es el modelo diciendo que la carta no cabe en su ventana de lectura. Fallan en sitios distintos y necesitan soluciones distintas.
La página de errores de la API de Anthropic (consultada el 29 de octubre de 2026) describe 413 request_ como una petición que supera el número máximo de bytes: 128 MB para la Messages API, 256 MB para la Batch API, 500 MB para la Files API. Un 400 invalid_ cubre problemas con el formato o el contenido de la petición. Esos son los límites de Anthropic. Su página no enumera un mensaje de recuento de tokens, y la guía de códigos de error de OpenAI tampoco, así que no construyas lógica basándote en la redacción exacta que viste en un hilo de foro.
En la práctica, los chats solo de texto suelen crecer en tokens mucho antes que en bytes. Los bytes se convierten en el problema cuando adjuntas imágenes en base64 o documentos enteros. Los tokens se convierten en el problema cuando crece el historial, y ese es el caso habitual.
Emparejar los pares
Relaciona cada síntoma con su causa
Toca un elemento de la izquierda, luego su par
- 413 request_too_largeEl cuerpo tiene demasiados bytes, por ejemplo un adjunto base64 grande
- Un error de longitud de tokens justo después de pegar un log enormeEl prompt por sí solo tiene más tokens que la ventana de contexto
- 400 después de un prompt de unos 375K tokens con max_tokens=32768 en un modelo de 380KJuntos pueden superar la ventana
- Mismo historial, modelo distintoComprueba la ventana de cada modelo: un historial que cabe en uno puede no caber en otro
El cuerpo del error es JSON con un type: error de nivel superior, un objeto error con su propio type y message, y un id de petición. Lee error.message y guarda el id de petición; con los SDK oficiales, captura la excepción tipada en lugar de comparar cadenas.
Comprueba las cuentas antes de enviar#
El hábito que más tiempo ahorra: no esperes al error. Antes de cada llamada, suma tres cosas y compáralas con la ventana.
- Tokens en tus mensajes (prompt de sistema, historial, la nueva pregunta).
- El
max_tokensque pides. - La ventana de contexto del modelo.
Mantén la entrada más la respuesta solicitada dentro de la ventana. Las ventanas en CheapTokens son de 390K para GLM-5.3-Flash, 380K para DeepSeek-V4-Flash y 180K para MiniMax-M2.7; las respuestas llegan hasta 8.192 tokens en GLM y MiniMax y hasta 32.768 en DeepSeek-V4-Flash. Consulta precios y páginas de modelos para la lista actual.
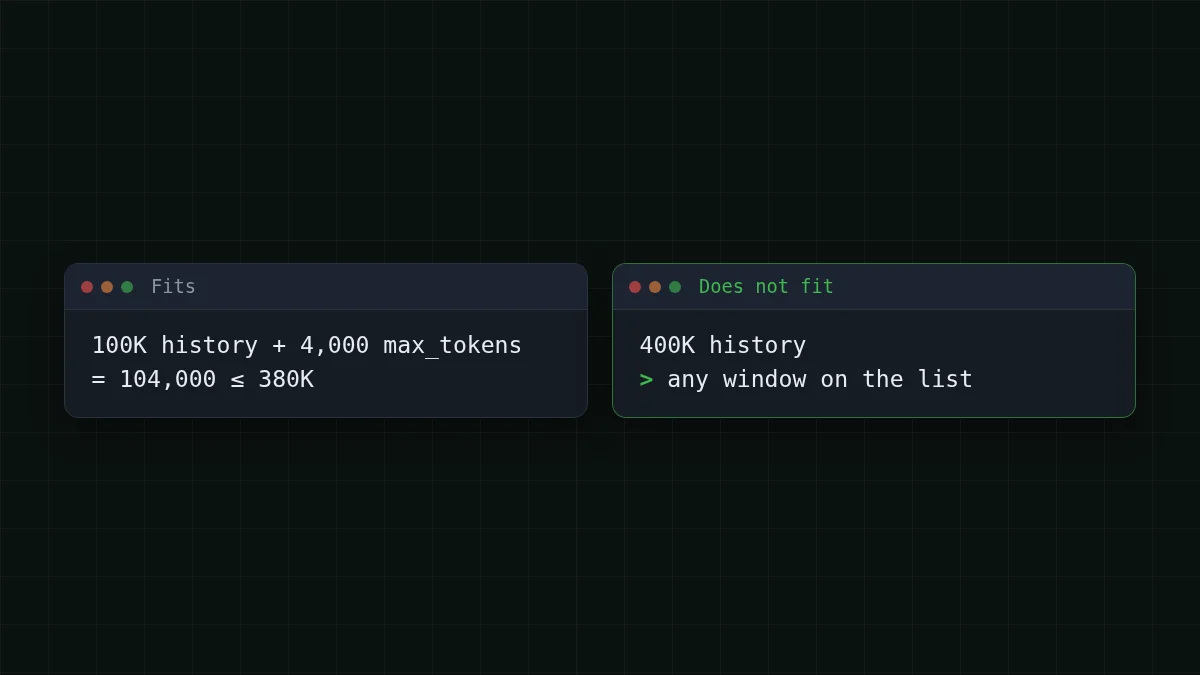
Digamos que tu agente envía un historial de 100K tokens y pide 4.000 tokens de vuelta. Eso es 100.000 + 4.000 = 104.000 tokens, cómodo en cualquiera de los tres. Ahora el mismo agente tras otros cincuenta pasos: 400K. Ninguna ventana de la lista lo admite, sea cual sea el max_tokens que pongas. Ese es el momento en que aparece el error, y parece repentino solo porque el historial creció un poco en cada turno.
Un contador aproximado basta para un guardián. El texto en inglés promedia unos 4 caracteres por token; el código y el texto no inglés usan más tokens por carácter, así que deja un margen:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
La última línea es tu calibración: usage. es lo que la API contó realmente. Compáralo con rough_ varias veces y ajusta el divisor y el margen a tu propio texto.
Cuatro formas de reducir una petición#
Elige la solución más barata que funcione, en este orden.
1. Baja max_tokens. Pide solo la respuesta que necesitas: la entrada más max_tokens es lo que tienes que mantener dentro de la ventana, y cada modelo tiene su propio tope para la respuesta (8.192 o 32.768 tokens arriba). No pongas max_tokens más alto de lo que necesita la respuesta, ni por encima del tope de respuestas del modelo. Si la respuesta se detiene en el límite que fijaste, termina con finish_, que tiene su propia solución.
2. Recorta el historial. Elimina los turnos más antiguos, conserva el prompt de sistema y los últimos intercambios. La función trim de arriba hace exactamente esto. Para un agente, recorta también el volumen: las salidas de herramientas de 5.000 líneas rara vez necesitan quedarse completas después de que el agente las haya usado.
3. Resume en lugar de descartar. Cuando los turnos antiguos importan, pide al modelo una vez que los comprima en una nota breve y luego sustituye los mensajes antiguos por esa nota. Pagas una llamada extra y conservas el hilo.
4. Cambia a una ventana más grande. Pasar de MiniMax-M2.7 (180K) a GLM-5.3-Flash (390K) o DeepSeek-V4-Flash (380K) es un cambio de una línea en el id del modelo. Si además necesitas respuestas largas, DeepSeek-V4-Flash permite hasta 32.768 tokens de salida, y los tres comparten un saldo, así que cambiar no cuesta nada en configuración.
Lista de verificación
Antes de reenviar una petición fallida
Lo que cuesta un historial largo#
Recortar no es solo cuestión de errores. Cada paso de un agente reenvía todo el historial, así que un historial inflado también es la parte cara de la factura. Toma una tarea de 30 pasos donde cada paso envía unos 100K tokens y recibe unos 1.500 de vuelta:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 30 solicitudes | OpenRouter, 30 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100.000 tokens de entrada y 1500 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
La tabla pone precio a esa misma tarea en cada modelo con tarifas en vivo. Reduce el historial a un cuarto y el lado de la entrada cae alrededor de tres cuartos. Para ver dónde gasta tokens tu propio agente, rastrea el uso por petición en Python; para los mecanismos, por qué los agentes usan tantos tokens recorre un ejemplo de 20 pasos.
DeepSeek-V4-Flash cuesta actualmente $0.015 por 1M de tokens de entrada y $0.10 por 1M de tokens de salida, un precio a cualquier hora. Prueba tus propios números:
Calculadora de costos
Una tarea de agente de 30 pasos con un historial de 100K
Tokens de entrada por solicitud: 100.000 · Tokens de salida por solicitud: 1500 · Solicitudes por día: 30
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
Si sigue fallando#
Las peticiones largas por un enlace lento tienen un fallo aparte: Anthropic aconseja streaming o la Batch API para peticiones largas con un max_tokens grande, porque las redes pueden cortar conexiones inactivas, y sus SDK esperan que las peticiones sin streaming terminen en 10 minutos. Si el error es un timeout o una conexión cortada en lugar de un 400, consulta errores de conexión y configura stream=True.
Si el mensaje es un 401 o 404, el problema es la clave, la URL base o el id del modelo: error 401 o 404 de la API. Para la URL base exacta, los ids de modelo y ejemplos, abre la documentación de CheapTokens.


