トラブルシューティングガイド
リクエストが長すぎる:400対413、コンテキストウィンドウとmax_tokens
413(バイト数が多すぎる)とトークン長エラー(通常は400)を区別し、入力とmax_tokensをコンテキストウィンドウと照合し、リクエストを縮める方法。
チャットが40ターン問題なく動いた後、すべてのリクエストが失敗し始めた。短い答えはこうだ。「リクエストが長すぎる」というエラーには、2つの異なる制限が隠れている。413 はリクエストがバイト数で大きすぎ、モデルが目にする前に拒否されたことを意味する。エラーがトークン数の長さについて文句を言っている場合(通常は400番台の無効なリクエスト)、入力と要求した回答がコンテキストウィンドウに収まっていない。どちらかを確認するには error.message を読んでほしい。修正方法は、計測してから削ることだ。
このガイドでは、2つの区別の仕方、送信前に計算を確認する方法、リクエストを縮める4つの方法を紹介する。用語が初めてなら、コンテキストウィンドウとは何かが平易な言葉で説明している。
2つの制限、2つのエラー#
413は郵便局が大きすぎる小包を拒否するようなもので、トークンエラーはモデルが「その手紙は読み取りウィンドウに収まらない」と言っているようなものだ。失敗する場所が異なり、必要な修正も異なる。
AnthropicのAPIエラーページ(2026年10月29日確認)では、413 request_ を最大バイト数を超えるリクエストと説明している。Messages APIでは128 MB、Batch APIでは256 MB、Files APIでは500 MBだ。400 invalid_ はリクエストの形式や内容の問題をカバーする。これらはAnthropicの制限だ。そのページにはトークン数のメッセージは記載されておらず、OpenAIのエラーコードガイドにもない。だからフォーラムのスレッドで見た正確な文言にロジックを組み立てないこと。
実際には、テキストのみのチャットはバイト数よりはるかに早くトークン数で増える。バイト数が問題になるのは、base64画像や文書全体を添付するときだ。トークン数が問題になるのは履歴が増えるときで、これが一般的なケースだ。
ペアを合わせる
各症状を原因と照合する
左の項目をタップしてから、そのペアをタップ
- 413 request_too_largeボディのバイト数が多すぎる。たとえば大きなbase64添付
- 巨大なログを貼り付けた直後のトークン長エラープロンプトだけでコンテキストウィンドウを超えるトークン数
- 380Kモデルでmax_tokens=32768、約375Kトークンのプロンプト後の400合計でウィンドウを超える可能性がある
- 同じ履歴で異なるモデル各モデルのウィンドウを確認する。一方に収まる履歴が他方に収まらないことがある
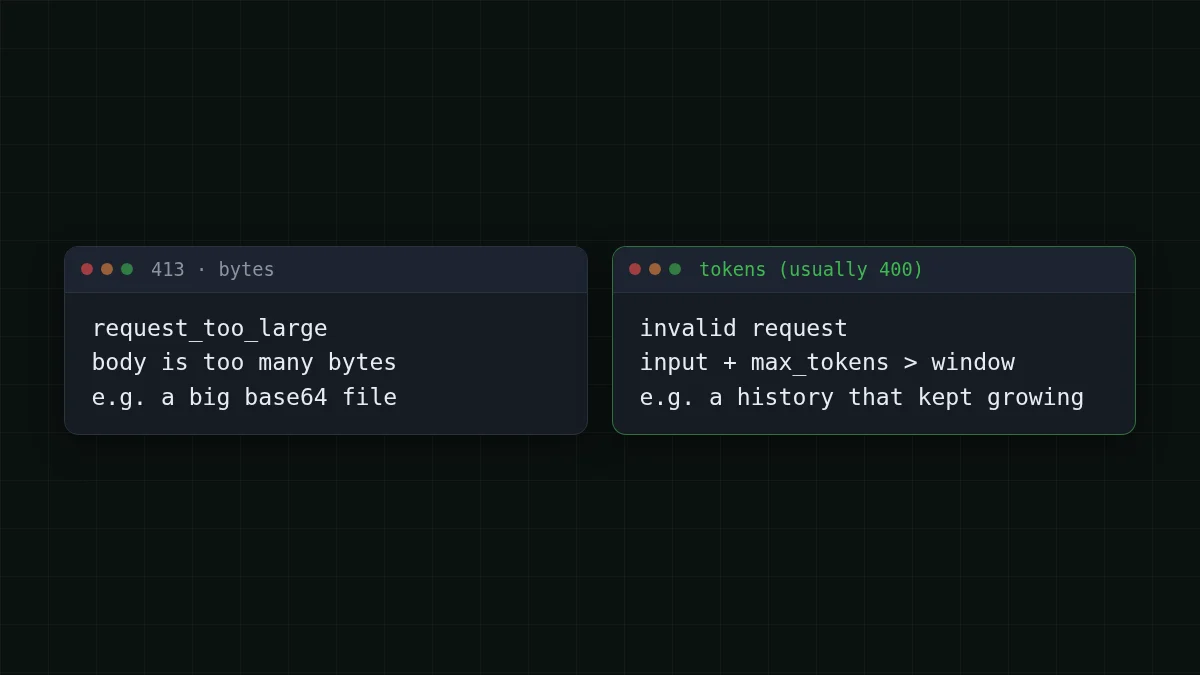
エラーボディはJSONで、トップレベルの type: error、独自の type と message を持つ error オブジェクト、そしてリクエストIDがある。error.message を読み、リクエストIDを保持する。公式SDKでは文字列照合ではなく型付き例外をキャッチする。
送信前に計算を確認する#
最も時間を節約する習慣:エラーを待たないこと。各呼び出しの前に3つを合計し、ウィンドウと比較する。
- メッセージ内のトークン数(システムプロンプト、履歴、新しい質問)。
- 要求している
max_tokens。 - モデルのコンテキストウィンドウ。
入力と要求した回答をウィンドウ内に保つ。CheapTokensのウィンドウはGLM-5.3-Flashが390K、DeepSeek-V4-Flashが380K、MiniMax-M2.7が180K。回答はGLMとMiniMaxで最大8,192トークン、DeepSeek-V4-Flashで最大32,768トークン。最新のリストは料金とモデルページを確認してほしい。
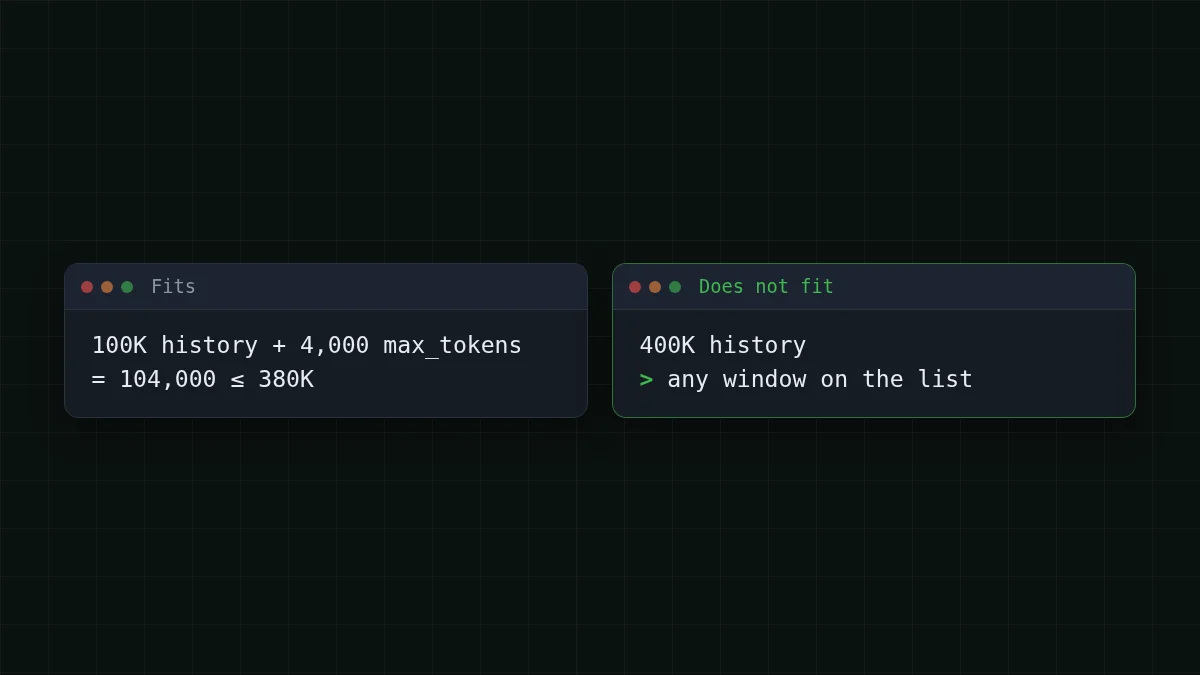
エージェントが100Kトークンの履歴を送り、4,000トークンの回答を要求するとしよう。100,000 + 4,000 = 104,000トークンで、3つのどれでも余裕がある。同じエージェントがさらに50ステップ後:400K。max_tokens を何に設定しても、リスト上のどのウィンドウにも収まらない。エラーが現れるのはその瞬間だが、履歴が毎ターン少しずつ増えたから突然に見えるだけだ。
ガードには大まかなカウンターで十分だ。英語テキストは平均約4文字で1トークン。コードや非英語テキストは1文字あたりより多くのトークンを使うので、余裕を残す:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)最後の行がキャリブレーションだ。usage. はAPIが実際に数えた値。これを rough_ と数回比較し、除数と余裕を自分のテキストに合わせて調整する。
リクエストを縮める4つの方法#
この順序で、最も安価に機能する修正を選ぶ。
1. max_tokensを下げる。 必要な回答だけを要求する。入力と max_tokens をウィンドウ内に保つ必要があり、各モデルには回答の上限がある(上記の8,192または32,768トークン)。max_tokens を回答に必要な量より高く設定せず、モデルの回答上限も超えないこと。設定した上限で回答が止まる場合、finish_ で終わり、独自の修正方法がある。
2. 履歴を削る。 最も古いターンを落とし、システムプロンプトと直近の数回のやり取りを残す。上記の trim 関数がまさにこれを行う。エージェントの場合、大量の部分も削る。5,000行のツール出力は、エージェントが使った後は全文を残す必要はほとんどない。
3. 削除ではなく要約する。 古いターンが重要な場合、モデルに一度短いメモに圧縮させ、古いメッセージをそのメモに置き換える。追加の呼び出し1回分を支払い、スレッドを保つ。
4. より大きなウィンドウに切り替える。 MiniMax-M2.7(180K)からGLM-5.3-Flash(390K)やDeepSeek-V4-Flash(380K)への変更はモデルIDの1行変更だ。長い回答も必要な場合、DeepSeek-V4-Flashは最大32,768出力トークンを許容し、3つとも1つの残高を共有するので、切り替えのセットアップコストはゼロだ。
チェックリスト
失敗したリクエストを再送する前に
長い履歴のコスト#
削ることはエラーだけの話ではない。エージェントの各ステップは履歴全体を再送するので、肥大化した履歴は請求の高価な部分でもある。各ステップが約100Kトークンを送り、約1,500トークンを受け取る30ステップのタスクを考えよう:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 30 リクエスト | OpenRouter、30 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
リクエストあたり 100,000 入力トークンと 1,500 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
表は同じタスクを各モデルでライブ料金で価格設定している。履歴を4分の1に削れば、入力側は約4分の3減る。自分のエージェントがどこでトークンを使うかを見るには、Pythonでリクエストごとの使用量を追跡する。仕組みについては、なぜエージェントはそんなに多くのトークンを使うのかが20ステップの例を解説している。
DeepSeek-V4-Flashは現在、100万入力トークンあたり $0.015、100万出力トークンあたり $0.10 で、時間帯に関係なく一律料金だ。自分の数字で試してみてほしい:
コスト計算機
100K履歴の30ステップエージェントタスク
リクエストあたりの入力トークン数: 100,000 · リクエストあたりの出力トークン数: 1,500 · 1日あたりのリクエスト数: 30
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
それでも失敗する場合#
遅い回線での長いリクエストには別の失敗がある。Anthropicは大きな max_tokens を持つ長いリクエストにはストリーミングまたはBatch APIを推奨している。ネットワークがアイドル接続を落とすことがあり、SDKは非ストリーミングリクエストが10分以内に完了することを期待するからだ。エラーが400ではなくタイムアウトや接続切断なら、接続エラーを見て stream=True を設定してほしい。
メッセージが401や404なら、問題はキー、ベースURL、モデルIDだ:API 401または404エラー。正確なベースURL、モデルID、例についてはCheapTokensドキュメントを開いてほしい。


