FehlerbehebungAnleitung
Anfrage zu lang: 400 vs 413, Kontextfenster und max_tokens
Unterscheide einen 413 (zu viele Bytes) von einem Token-Längenfehler (normalerweise ein 400), prüfe Eingabe plus max_tokens gegen das Kontextfenster und verkleinere die Anfrage.
Auf dieser Seite
Dein Chat lief vierzig Runden lang einwandfrei, dann begann jede Anfrage zu scheitern. Die kurze Antwort: "request too long" verbirgt zwei verschiedene Limits. Ein 413 bedeutet, dass die Anfrage in Bytes zu groß ist und abgelehnt wurde, bevor ein Modell sie gesehen hat. Wenn sich der Fehler über die Länge in Tokens beschwert (normalerweise eine ungültige Anfrage der 400er-Klasse), passen deine Eingabe plus die angeforderte Antwort nicht in das Kontextfenster; lies error.message, um zu sehen, welches. Die Lösung ist messen, dann kürzen.
Dieser Leitfaden zeigt, wie man die beiden unterscheidet, wie man die Rechnung vor dem Senden prüft und vier Wege, eine Anfrage zu verkleinern. Wenn der Begriff neu ist, erklärt was ein Kontextfenster ist ihn in einfachen Worten.
Zwei Limits, zwei Fehler#
Ein 413 ist das Postamt, das ein zu großes Paket ablehnt; ein Token-Fehler ist das Modell, das sagt, der Brief passt nicht in sein Lesefenster. Sie treten an verschiedenen Stellen auf und erfordern unterschiedliche Lösungen.
Die API-Fehlerseite von Anthropic (geprüft am 29. Oktober 2026) beschreibt 413 request_ als eine Anfrage, die die maximale Byte-Anzahl überschreitet: 128 MB für die Messages API, 256 MB für die Batch API, 500 MB für die Files API. Ein 400 invalid_ deckt Probleme mit dem Format oder Inhalt der Anfrage ab. Das sind Anthropics Limits. Ihre Seite listet keine Token-Zählungsnachricht auf, und die Fehlercode-Anleitung von OpenAI auch nicht, also baue keine Logik auf den genauen Wortlaut, den du in einem Forum-Thread gesehen hast.
In der Praxis wachsen reine Text-Chats meist lange vor den Bytes in Tokens. Bytes werden zum Problem, wenn du Base64-Bilder oder ganze Dokumente anhängst. Tokens werden zum Problem, wenn die Historie wächst, und das ist der häufige Fall.
Paare zuordnen
Ordne jedes Symptom seiner Ursache zu
Tippe auf ein Element links, dann auf sein Paar
- 413 request_too_largeDer Body hat zu viele Bytes, zum Beispiel ein großer Base64-Anhang
- Ein Token-Längenfehler direkt nach dem Einfügen eines riesigen LogsDer Prompt allein hat mehr Tokens als das Kontextfenster
- 400 nach einem Prompt von etwa 375K Tokens mit max_tokens=32768 bei einem 380K-ModellZusammen können sie das Fenster überschreiten
- Gleiche Historie, anderes ModellPrüfe das Fenster jedes Modells: Eine Historie, die in eines passt, passt nicht unbedingt in ein anderes
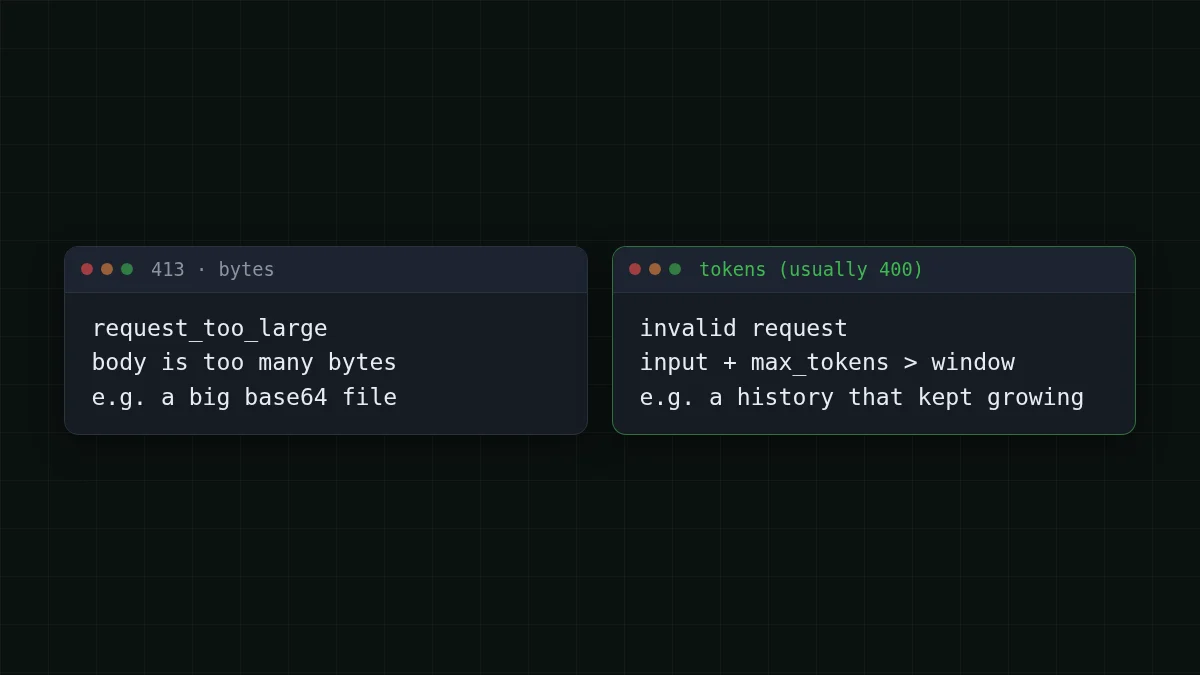
Der Fehler-Body ist JSON mit einem Top-Level-type: error, einem error-Objekt mit eigenem type und message sowie einer Request-ID. Lies error.message und behalte die Request-ID; fange bei den offiziellen SDKs die typisierte Exception ab, anstatt Strings zu vergleichen.
Prüfe die Rechnung vor dem Senden#
Die Gewohnheit, die am meisten Zeit spart: Warte nicht auf den Fehler. Addiere vor jedem Aufruf drei Dinge und vergleiche sie mit dem Fenster.
- Tokens in deinen Nachrichten (System-Prompt, Historie, die neue Frage).
- Die
max_tokens, die du anforderst. - Das Kontextfenster des Modells.
Halte Eingabe plus angeforderte Antwort innerhalb des Fensters. Die Fenster bei CheapTokens sind 390K für GLM-5.3-Flash, 380K für DeepSeek-V4-Flash und 180K für MiniMax-M2.7; Antworten gehen bis zu 8.192 Tokens bei GLM und MiniMax und bis zu 32.768 bei DeepSeek-V4-Flash. Prüfe Preis- und Modellseiten für die aktuelle Liste.
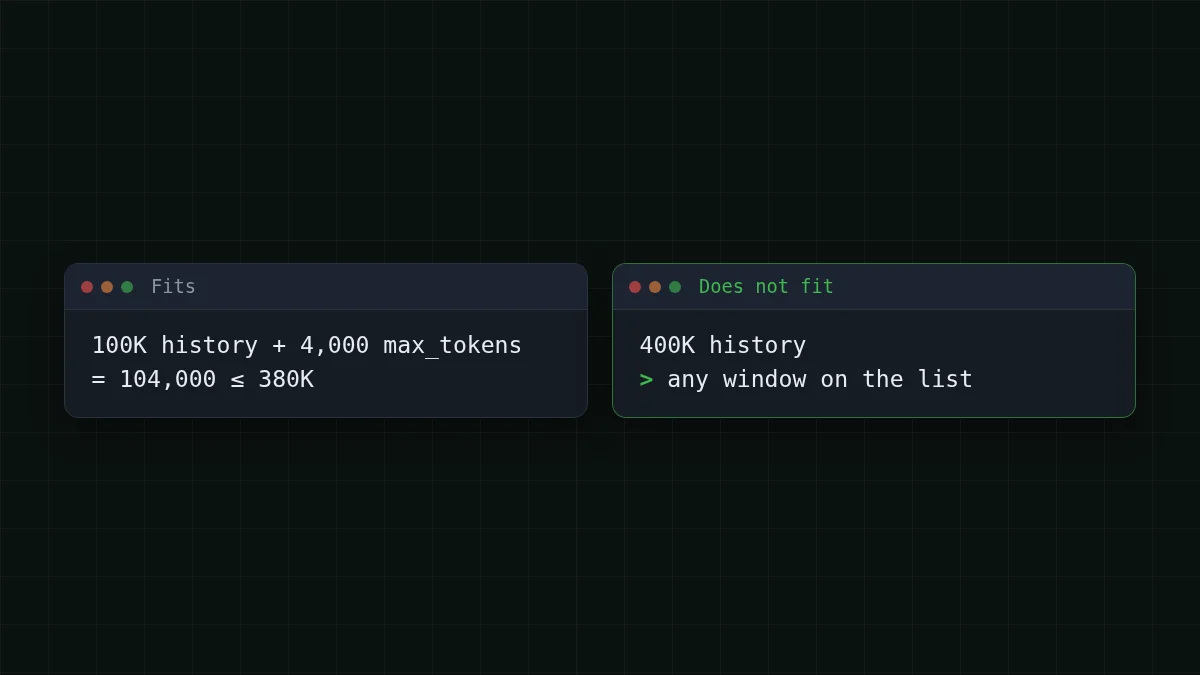
Sagen wir, dein Agent sendet eine 100K-Token-Historie und fordert 4.000 Tokens zurück an. Das sind 100.000 + 4.000 = 104.000 Tokens, bequem in jedem der drei. Jetzt derselbe Agent nach weiteren fünfzig Schritten: 400K. Kein Fenster auf der Liste nimmt das auf, egal welches max_tokens du setzt. Das ist der Moment, in dem der Fehler auftritt, und er wirkt nur plötzlich, weil die Historie mit jeder Runde ein wenig gewachsen ist.
Ein grober Zähler reicht für eine Absicherung. Englischer Text hat im Durchschnitt etwa 4 Zeichen pro Token; Code und nicht-englischer Text verwenden mehr Tokens pro Zeichen, also lass einen Puffer:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
Die letzte Zeile ist deine Kalibrierung: usage. ist das, was die API tatsächlich gezählt hat. Vergleiche es ein paar Mal mit rough_ und passe den Divisor und den Puffer an deinen eigenen Text an.
Vier Wege, eine Anfrage zu verkleinern#
Wähle die günstigste Lösung, die funktioniert, in dieser Reihenfolge.
1. Senke max_tokens. Fordere nur die Antwort an, die du brauchst: Eingabe plus max_tokens ist das, was du innerhalb des Fensters halten musst, und jedes Modell hat seine eigene Obergrenze für die Antwort (8.192 oder 32.768 Tokens oben). Setze max_tokens nicht höher als die Antwort benötigt und nicht über die Obergrenze des Modells für Antworten. Wenn die Antwort am gesetzten Limit stoppt, endet sie mit finish_, was seine eigene Lösung hat.
2. Kürze die Historie. Verwirf die ältesten Runden, behalte den System-Prompt und die letzten paar Austausche. Die Funktion trim oben macht genau das. Bei einem Agenten schneide auch die Masse weg: Tool-Ausgaben von 5.000 Zeilen müssen selten vollständig bleiben, nachdem der Agent sie verwendet hat.
3. Fasse zusammen, anstatt zu verwerfen. Wenn alte Runden wichtig sind, bitte das Modell einmal, sie zu einer kurzen Notiz zu komprimieren, und ersetze dann die alten Nachrichten durch diese Notiz. Du zahlst für einen zusätzlichen Aufruf und behältst den Thread.
4. Wechsle zu einem größeren Fenster. Von MiniMax-M2.7 (180K) zu GLM-5.3-Flash (390K) oder DeepSeek-V4-Flash (380K) zu wechseln, ist eine einzeilige Änderung der Modell-ID. Wenn du auch lange Antworten brauchst, erlaubt DeepSeek-V4-Flash bis zu 32.768 Ausgabe-Tokens, und alle drei teilen sich ein Guthaben, sodass der Wechsel keine Einrichtungskosten verursacht.
Checkliste
Bevor du eine fehlgeschlagene Anfrage erneut sendest
Was eine lange Historie kostet#
Kürzen geht nicht nur um Fehler. Jeder Schritt eines Agenten sendet die gesamte Historie erneut, also ist eine aufgeblähte Historie auch der teure Teil der Rechnung. Nimm eine Aufgabe mit 30 Schritten, bei der jeder Schritt etwa 100K Tokens sendet und etwa 1.500 zurückbekommt:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 30 Anfragen | OpenRouter, 30 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100.000 Input- und 1.500 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Die Tabelle bepreist dieselbe Aufgabe auf jedem Modell mit Live-Tarifen. Kürze die Historie auf ein Viertel und die Eingabeseite fällt um etwa drei Viertel. Um zu sehen, wo dein eigener Agent Tokens verbraucht, verfolge die Nutzung pro Anfrage in Python; für die Mechanik warum Agenten so viele Tokens verbrauchen wird ein 20-Schritte-Beispiel durchgegangen.
DeepSeek-V4-Flash kostet derzeit $0.015 pro 1M Eingabe-Tokens und $0.10 pro 1M Ausgabe-Tokens, ein Preis zu jeder Stunde. Probiere deine eigenen Zahlen aus:
Kostenrechner
Eine 30-Schritte-Agentenaufgabe mit einer 100K-Historie
Eingabe-Tokens pro Anfrage: 100.000 · Ausgabe-Tokens pro Anfrage: 1.500 · Anfragen pro Tag: 30
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
Wenn es immer noch fehlschlägt#
Lange Anfragen über eine langsame Verbindung haben einen separaten Fehler: Anthropic empfiehlt Streaming oder die Batch API für lange Anfragen mit einem großen max_tokens, weil Netzwerke inaktive Verbindungen trennen können, und seine SDKs erwarten, dass nicht-gestreamte Anfragen innerhalb von 10 Minuten abgeschlossen sind. Wenn der Fehler ein Timeout oder eine getrennte Verbindung statt eines 400 ist, siehe Verbindungsfehler und setze stream=True.
Wenn die Meldung ein 401 oder 404 ist, liegt das Problem stattdessen am Schlüssel, der Basis-URL oder der Modell-ID: API 401 oder 404 Fehler. Für die genaue Basis-URL, Modell-IDs und Beispiele öffne die CheapTokens-Dokumentation.


