समस्या निवारणगाइड
रिक्वेस्ट बहुत लंबी: 400 बनाम 413, कॉन्टेक्स्ट विंडो और max_tokens
413 (बहुत ज़्यादा बाइट्स) को टोकन-लंबाई एरर (आमतौर पर 400) से अलग पहचानें, इनपुट प्लस max_tokens को कॉन्टेक्स्ट विंडो से तुलना करें, और रिक्वेस्ट छोटी करें।
इस पृष्ठ पर
आपकी चैट चालीस टर्न तक ठीक चली, फिर हर रिक्वेस्ट फेल होने लगी। छोटा जवाब: "request too long" दो अलग-अलग सीमाओं को छिपाता है। 413 का मतलब है कि रिक्वेस्ट बाइट्स में बहुत बड़ी है और किसी भी मॉडल के देखने से पहले ही लौटा दी गई। अगर एरर टोकन में लंबाई की शिकायत करता है (आमतौर पर 400-क्लास अमान्य रिक्वेस्ट), तो आपका इनपुट प्लस मांगा गया जवाब कॉन्टेक्स्ट विंडो में नहीं आता; यह देखने के लिए error.message पढ़ें कि कौन सा है। समाधान है: मापें, फिर छाँटें।
यह गाइड दिखाती है कि दोनों में फर्क कैसे करें, भेजने से पहले गणित कैसे जाँचें, और रिक्वेस्ट छोटी करने के चार तरीके। अगर यह शब्द नया है, तो what a context window is इसे सरल शब्दों में समझाता है।
दो सीमाएँ, दो एरर#
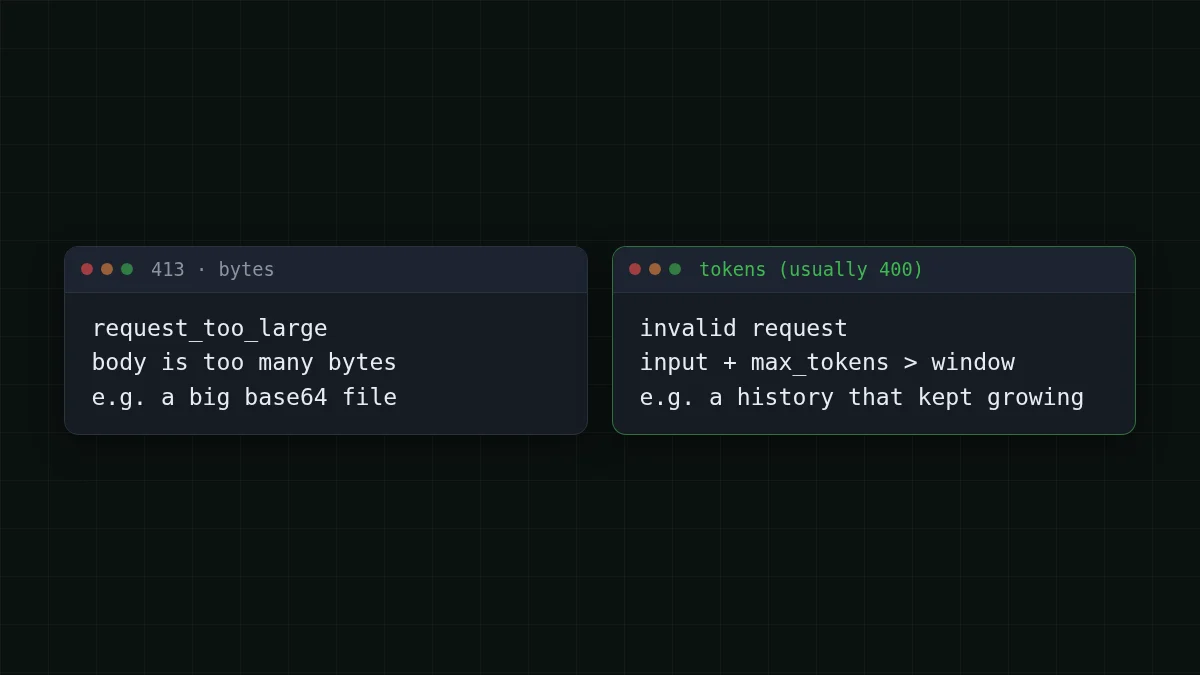
413 डाकघर का बहुत बड़ा पार्सल लौटाना है; टोकन एरर मॉडल का कहना है कि पत्र उसकी पढ़ने की खिड़की में नहीं आएगा। ये अलग जगहों पर फेल होते हैं और अलग समाधान चाहते हैं।
Anthropic का API errors पेज (29 अक्टूबर 2026 को जाँचा गया) 413 request_ को ऐसी रिक्वेस्ट बताता है जो अधिकतम बाइट्स से बढ़ जाती है: Messages API के लिए 128 MB, Batch API के लिए 256 MB, Files API के लिए 500 MB। 400 invalid_ रिक्वेस्ट के फॉर्मेट या कंटेंट की समस्याओं को कवर करता है। ये Anthropic की सीमाएँ हैं। उनका पेज टोकन-काउंट संदेश नहीं दिखाता, और OpenAI की error-codes गाइड भी नहीं, इसलिए किसी फोरम थ्रेड में देखे गए सटीक शब्दों पर लॉजिक न बनाएँ।
व्यवहार में, केवल-टेक्स्ट चैट बाइट्स से बहुत पहले टोकन में बढ़ती हैं। बाइट्स तब समस्या बनते हैं जब आप base64 इमेज या पूरे दस्तावेज़ अटैच करते हैं। टोकन तब समस्या बनते हैं जब हिस्ट्री बढ़ती है, और यही आम मामला है।
जोड़े मिलाएँ
हर लक्षण को उसके कारण से मिलाएँ
बाईं ओर एक आइटम पर टैप करें, फिर उसका जोड़ा
- 413 request_too_largeबॉडी में बहुत ज़्यादा बाइट्स हैं, जैसे बड़ा base64 अटैचमेंट
- बड़ा लॉग पेस्ट करते ही टोकन-लंबाई एररअकेला प्रॉम्प्ट ही कॉन्टेक्स्ट विंडो से ज़्यादा टोकन है
- 380K मॉडल पर max_tokens=32768 के साथ लगभग 375K टोकन के प्रॉम्प्ट के बाद 400दोनों मिलकर विंडो से बढ़ सकते हैं
- वही हिस्ट्री, अलग मॉडलहर मॉडल की विंडो जाँचें: जो हिस्ट्री एक में आती है, दूसरे में नहीं आ सकती
एरर बॉडी JSON है जिसमें टॉप-लेवल type: error, अपने type और message वाला error ऑब्जेक्ट, और एक request id होता है। error.message पढ़ें और request id रखें; आधिकारिक SDKs के साथ, स्ट्रिंग मिलाने के बजाय टाइप्ड एक्सेप्शन पकड़ें।
भेजने से पहले गणित जाँचें#
सबसे ज़्यादा समय बचाने वाली आदत: एरर का इंतज़ार न करें। हर कॉल से पहले तीन चीज़ें जोड़ें और उन्हें विंडो से तुलना करें।
- आपके संदेशों में टोकन (सिस्टम प्रॉम्प्ट, हिस्ट्री, नया सवाल)।
- आप जो
max_tokensमांग रहे हैं। - मॉडल की कॉन्टेक्स्ट विंडो।
इनपुट प्लस मांगा गया जवाब विंडो के अंदर रखें। CheapTokens पर विंडो GLM-5.3-Flash के लिए 390K, DeepSeek-V4-Flash के लिए 380K और MiniMax-M2.7 के लिए 180K हैं; जवाब GLM और MiniMax पर 8,192 टोकन तक और DeepSeek-V4-Flash पर 32,768 तक जाते हैं। मौजूदा सूची के लिए pricing and model pages देखें।
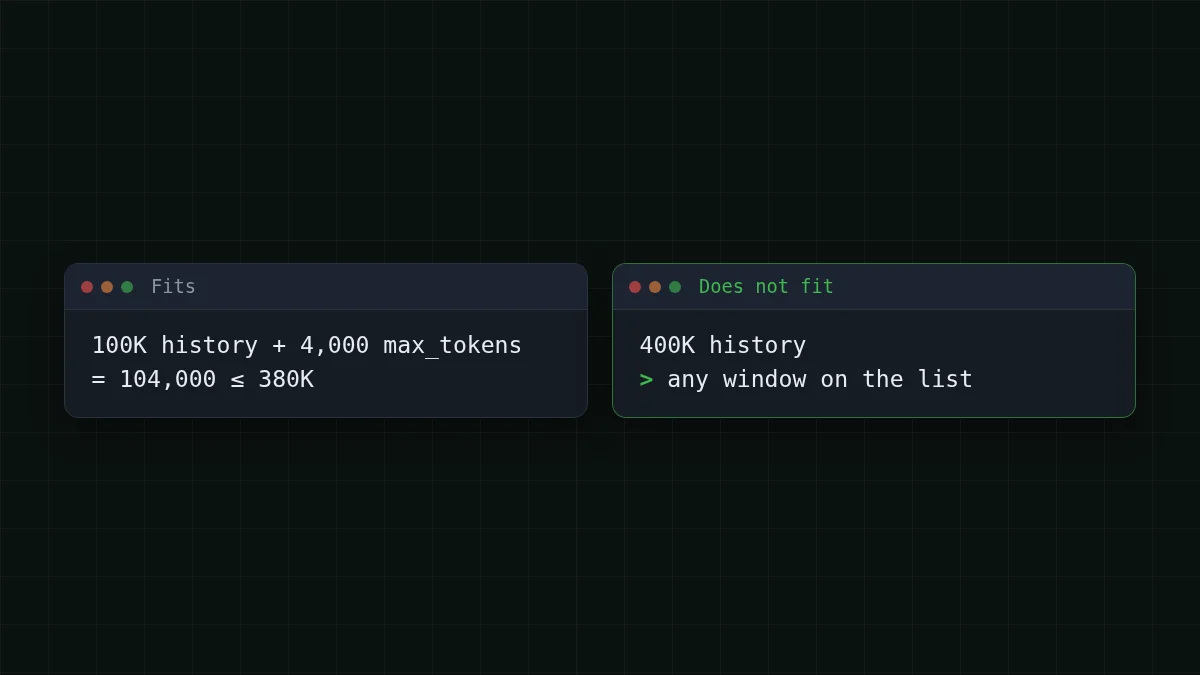
मान लें आपका एजेंट 100K-टोकन हिस्ट्री भेजता है और 4,000 टोकन वापस मांगता है। यह 100,000 + 4,000 = 104,000 टोकन है, तीनों में से किसी पर भी आराम से। अब वही एजेंट पचास और स्टेप्स के बाद: 400K। सूची में कोई विंडो इसे नहीं लेती, चाहे आप max_tokens कुछ भी सेट करें। यही वह क्षण है जब एरर दिखता है, और यह अचानक लगता है केवल इसलिए कि हिस्ट्री हर टर्न थोड़ी-थोड़ी बढ़ती रही।
गार्ड के लिए एक मोटा काउंटर काफी है। अंग्रेज़ी टेक्स्ट औसतन लगभग 4 अक्षर प्रति टोकन; कोड और गैर-अंग्रेज़ी टेक्स्ट प्रति अक्षर ज़्यादा टोकन लेते हैं, इसलिए मार्जिन छोड़ें:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
आखिरी लाइन आपका कैलिब्रेशन है: usage. वही है जो API ने वास्तव में गिना। इसे कुछ बार rough_ से तुलना करें और भाजक व मार्जिन को अपने टेक्स्ट के अनुसार समायोजित करें।
रिक्वेस्ट छोटी करने के चार तरीके#
इस क्रम में सबसे सस्ता काम करने वाला समाधान चुनें।
1. max_tokens घटाएँ। केवल वही जवाब मांगें जो आपको चाहिए: इनपुट प्लस max_tokens ही वह है जिसे विंडो के अंदर रखना है, और हर मॉडल की जवाब पर अपनी सीमा है (ऊपर 8,192 या 32,768 टोकन)। max_tokens को जवाब की ज़रूरत से ज़्यादा न सेट करें, और मॉडल की जवाब-सीमा से ऊपर नहीं। अगर जवाब आपकी सेट की सीमा पर रुकता है, तो वह finish_ पर खत्म होता है, जिसका अपना समाधान है।
2. हिस्ट्री छाँटें। सबसे पुराने टर्न हटाएँ, सिस्टम प्रॉम्प्ट और आखिरी कुछ एक्सचेंज रखें। ऊपर का trim फंक्शन ठीक यही करता है। एजेंट के लिए, भारी हिस्सा भी काटें: 5,000 लाइनों के टूल आउटपुट एजेंट द्वारा उपयोग के बाद पूरे रखने की शायद ही ज़रूरत होती है।
3. हटाने के बजाय सारांश बनाएँ। जब पुराने टर्न मायने रखते हैं, मॉडल से एक बार उन्हें छोटे नोट में संक्षिप्त करने को कहें, फिर पुराने संदेशों को उस नोट से बदल दें। आप एक अतिरिक्त कॉल का भुगतान करते हैं और थ्रेड बना रहता है।
4. बड़ी विंडो पर जाएँ। MiniMax-M2.7 (180K) से GLM-5.3-Flash (390K) या DeepSeek-V4-Flash (380K) पर जाना मॉडल id का एक-लाइन बदलाव है। अगर आपको लंबे जवाब भी चाहिए, DeepSeek-V4-Flash 32,768 आउटपुट टोकन तक देता है, और तीनों एक ही बैलेंस साझा करते हैं, इसलिए स्विच करने में सेटअप का कोई खर्च नहीं।
चेकलिस्ट
फेल रिक्वेस्ट दोबारा भेजने से पहले
लंबी हिस्ट्री की कीमत#
छँटाई केवल एरर के बारे में नहीं है। एजेंट का हर स्टेप पूरी हिस्ट्री दोबारा भेजता है, इसलिए फूली हुई हिस्ट्री बिल का महँगा हिस्सा भी है। 30 स्टेप का कार्य लें जहाँ हर स्टेप लगभग 100K टोकन भेजता है और लगभग 1,500 वापस पाता है:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 30 अनुरोध | OpenRouter, 30 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
प्रति अनुरोध 1,00,000 इनपुट और 1,500 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
तालिका उसी कार्य को हर मॉडल पर लाइव दरों से कीमत देती है। हिस्ट्री को चौथाई करें तो इनपुट पक्ष लगभग तीन-चौथाई गिर जाता है। यह देखने के लिए कि आपका अपना एजेंट टोकन कहाँ खर्च करता है, track usage per request in Python; यांत्रिकी के लिए, why agents use so many tokens 20-स्टेप उदाहरण से गुज़रता है।
DeepSeek-V4-Flash की कीमत अभी $0.015 प्रति 1M इनपुट टोकन और $0.10 प्रति 1M आउटपुट टोकन है, किसी भी घंटे एक ही दाम। अपने नंबर आज़माएँ:
लागत कैलकुलेटर
100K हिस्ट्री के साथ 30-स्टेप एजेंट कार्य
प्रति अनुरोध इनपुट टोकन: 1,00,000 · प्रति अनुरोध आउटपुट टोकन: 1,500 · प्रति दिन अनुरोध: 30
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
अगर फिर भी फेल हो#
धीमे लिंक पर लंबी रिक्वेस्ट की एक अलग विफलता है: Anthropic बड़े max_tokens वाली लंबी रिक्वेस्ट के लिए स्ट्रीमिंग या Batch API की सलाह देता है, क्योंकि नेटवर्क निष्क्रिय कनेक्शन गिरा सकते हैं, और उसके SDKs गैर-स्ट्रीमिंग रिक्वेस्ट के 10 मिनट में पूरा होने की अपेक्षा करते हैं। अगर एरर 400 के बजाय टाइमआउट या गिरा हुआ कनेक्शन है, तो connection errors देखें और stream=True सेट करें।
अगर संदेश 401 या 404 है, तो समस्या key, base URL या model id है: API 401 or 404 error। सटीक base URL, model ids और उदाहरणों के लिए, CheapTokens docs खोलें।


