การแก้ไขปัญหาคู่มือ
คำขอยาวเกินไป: 400 เทียบกับ 413 หน้าต่างบริบท และ max_tokens
แยกความแตกต่างระหว่าง 413 (ไบต์มากเกินไป) กับข้อผิดพลาดความยาวโทเค็น (โดยปกติคือ 400) ตรวจสอบอินพุตบวก max_tokens กับหน้าต่างบริบท และลดขนาดคำขอ
ในหน้านี้
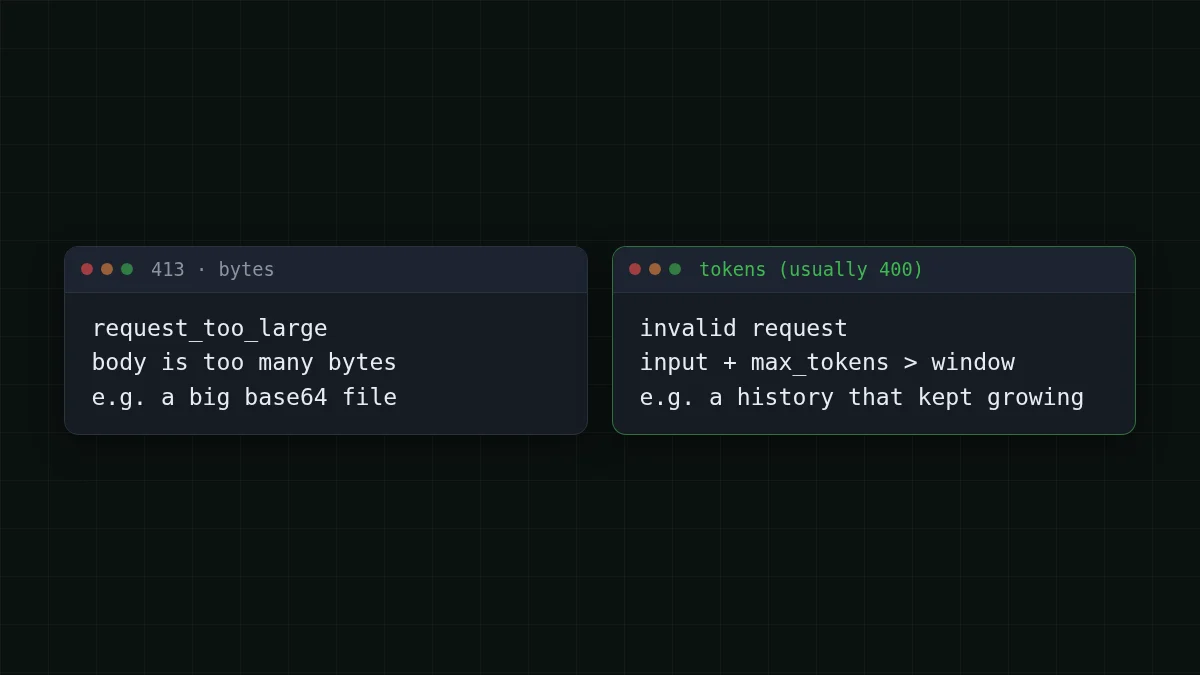
แชทของคุณทำงานได้ดีมาสี่สิบเทิร์น แล้วทุกคำขอเริ่มล้มเหลว คำตอบสั้น ๆ: "request too long" ซ่อนขีดจำกัดที่แตกต่างกันสองอย่าง 413 หมายความว่าคำขอใหญ่เกินไปในหน่วยไบต์และถูกปฏิเสธก่อนที่โมเดลใดจะได้เห็น หากข้อผิดพลาดบ่นเกี่ยวกับความยาวในหน่วยโทเค็น (โดยปกติคือคำขอไม่ถูกต้องระดับ 400) อินพุตของคุณบวกคำตอบที่คุณขอไม่พอดีกับหน้าต่างบริบท อ่าน error.message เพื่อดูว่าเป็นแบบไหน วิธีแก้คือวัด แล้วตัดทอน
คู่มือนี้แสดงวิธีแยกความแตกต่างระหว่างสองอย่าง วิธีตรวจสอบคณิตศาสตร์ก่อนส่ง และสี่วิธีลดขนาดคำขอ หากเป็นคำใหม่ หน้าต่างบริบทคืออะไร อธิบายไว้ด้วยคำง่าย ๆ
สองขีดจำกัด สองข้อผิดพลาด#
413 คือไปรษณีย์ปฏิเสธพัสดุที่ใหญ่เกินไป ส่วนข้อผิดพลาดโทเค็นคือโมเดลบอกว่าจดหมายไม่พอดีกับหน้าต่างการอ่านของมัน ทั้งสองล้มเหลวในที่ต่างกันและต้องการวิธีแก้ต่างกัน
หน้าข้อผิดพลาด API ของ Anthropic (ตรวจสอบเมื่อ 29 ตุลาคม 2026) อธิบาย 413 request_ ว่าเป็นคำขอที่เกินจำนวนไบต์สูงสุด: 128 MB สำหรับ Messages API, 256 MB สำหรับ Batch API, 500 MB สำหรับ Files API 400 invalid_ ครอบคลุมปัญหากับรูปแบบหรือเนื้อหาของคำขอ นั่นคือขีดจำกัดของ Anthropic หน้าของพวกเขาไม่ได้ระบุข้อความจำนวนโทเค็น และคู่มือรหัสข้อผิดพลาดของ OpenAI ก็เช่นกัน ดังนั้นอย่าสร้างตรรกะบนถ้อยคำที่แน่นอนที่คุณเห็นในกระทู้ฟอรัม
ในทางปฏิบัติ แชทข้อความล้วนมักเพิ่มขึ้นในโทเค็นนานก่อนไบต์ ไบต์กลายเป็นปัญหาเมื่อคุณแนบภาพ base64 หรือเอกสารทั้งฉบับ โทเค็นกลายเป็นปัญหาเมื่อประวัติยาวขึ้น และนั่นคือกรณีทั่วไป
จับคู่
จับคู่อาการกับสาเหตุ
แตะรายการทางซ้าย แล้วแตะคู่ของมัน
- 413 request_too_largeเนื้อหามีไบต์มากเกินไป เช่นไฟล์แนบ base64 ขนาดใหญ่
- ข้อผิดพลาดความยาวโทเค็นทันทีหลังวางบันทึกขนาดใหญ่พรอมต์อย่างเดียวมีโทเค็นมากกว่าหน้าต่างบริบท
- 400 หลังจากพรอมต์ประมาณ 375K โทเค็นด้วย max_tokens=32768 บนโมเดล 380Kรวมกันอาจเกินหน้าต่าง
- ประวัติเดียวกัน โมเดลต่างกันตรวจสอบหน้าต่างของแต่ละโมเดล: ประวัติที่พอดีกับโมเดลหนึ่งอาจไม่พอดีกับอีกโมเดล
เนื้อหาข้อผิดพลาดเป็น JSON ที่มี type: error ระดับบนสุด อ็อบเจกต์ error ที่มี type และ message ของตัวเอง และ request id อ่าน error.message และเก็บ request id ไว้ กับ SDK อย่างเป็นทางการ ให้จับข้อยกเว้นแบบมีชนิดแทนการจับคู่สตริง
ตรวจสอบคณิตศาสตร์ก่อนส่ง#
นิสัยที่ประหยัดเวลาที่สุด: อย่ารอให้เกิดข้อผิดพลาด ก่อนแต่ละครั้งให้บวกสามอย่างและเปรียบเทียบกับหน้าต่าง
- โทเค็นในข้อความของคุณ (system prompt, ประวัติ, คำถามใหม่)
max_tokensที่คุณขอ- หน้าต่างบริบทของโมเดล
ให้อินพุตบวกคำตอบที่ขออยู่ภายในหน้าต่าง หน้าต่างบน CheapTokens คือ 390K สำหรับ GLM-5.3-Flash, 380K สำหรับ DeepSeek-V4-Flash และ 180K สำหรับ MiniMax-M2.7; คำตอบสูงสุด 8,192 โทเค็นบน GLM และ MiniMax และสูงสุด 32,768 บน DeepSeek-V4-Flash ตรวจสอบราคาและหน้าโมเดลสำหรับรายการปัจจุบัน
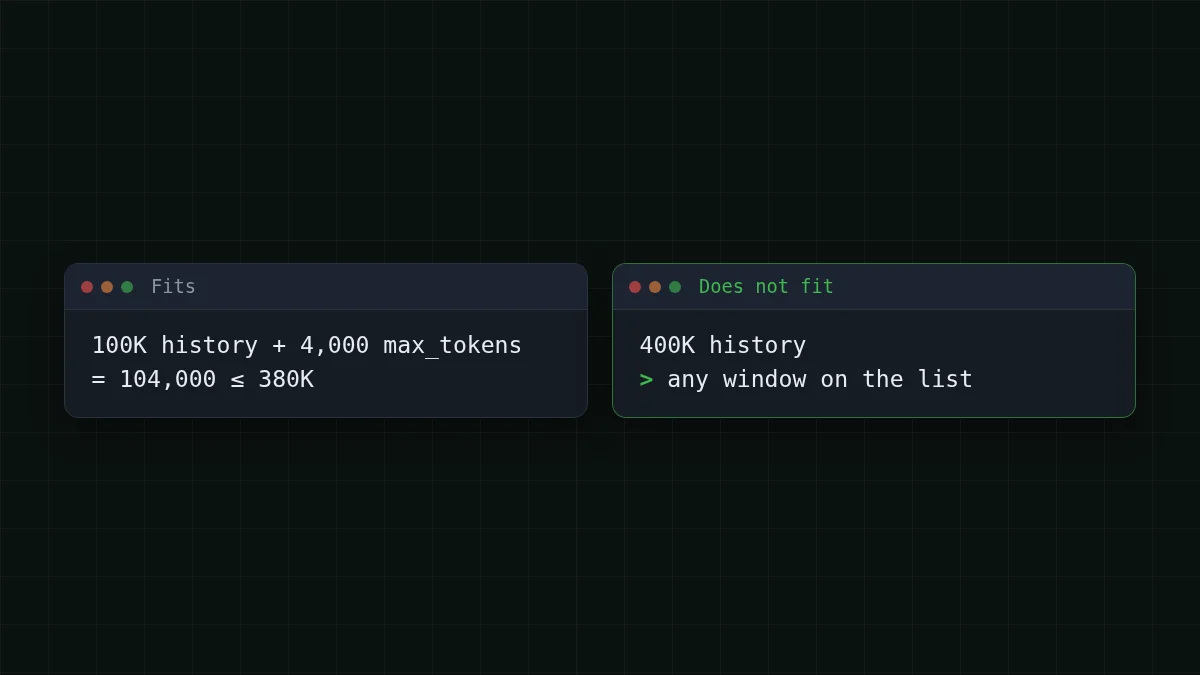
สมมติเอเจนต์ของคุณส่งประวัติ 100K โทเค็นและขอ 4,000 โทเค็นกลับ นั่นคือ 100,000 + 4,000 = 104,000 โทเค็น สบายบนทั้งสาม ตอนนี้เอเจนต์เดียวกันหลังจากอีกห้าสิบขั้น: 400K ไม่มีหน้าต่างใดในรายการรับได้ ไม่ว่าคุณจะตั้ง max_tokens เท่าไร นั่นคือช่วงเวลาที่ข้อผิดพลาดปรากฏ และดูเหมือนเกิดขึ้นทันทีเพียงเพราะประวัติเพิ่มขึ้นทีละน้อยในแต่ละเทิร์น
ตัวนับหยาบ ๆ ก็เพียงพอสำหรับการป้องกัน ข้อความภาษาอังกฤษเฉลี่ยประมาณ 4 ตัวอักษรต่อโทเค็น; โค้ดและข้อความที่ไม่ใช่ภาษาอังกฤษใช้โทเค็นต่อตัวอักษรมากกว่า ดังนั้นเผื่อระยะไว้:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
บรรทัดสุดท้ายคือการปรับเทียบของคุณ: usage. คือสิ่งที่ API นับจริง เปรียบเทียบกับ rough_ สองสามครั้งแล้วปรับตัวหารและระยะเผื่อให้เข้ากับข้อความของคุณเอง
สี่วิธีลดขนาดคำขอ#
เลือกวิธีแก้ที่ถูกที่สุดที่ได้ผลตามลำดับนี้
1. ลด max_tokens ขอเฉพาะคำตอบที่คุณต้องการ: อินพุตบวก max_tokens คือสิ่งที่คุณต้องเก็บไว้ในหน้าต่าง และแต่ละโมเดลมีเพดานคำตอบของตัวเอง (8,192 หรือ 32,768 โทเค็นข้างต้น) อย่าตั้ง max_tokens สูงกว่าที่คำตอบต้องการ และไม่เกินเพดานคำตอบของโมเดล หากคำตอบหยุดที่ขีดจำกัดที่คุณตั้ง มันจะลงท้ายด้วย finish_ ซึ่งมีวิธีแก้ของตัวเอง
2. ตัดทอนประวัติ ทิ้งเทิร์นเก่าสุด เก็บ system prompt และการแลกเปลี่ยนล่าสุดไม่กี่ครั้ง ฟังก์ชัน trim ข้างต้นทำแบบนี้ สำหรับเอเจนต์ ให้ตัดส่วนที่มากด้วย: เอาต์พุตเครื่องมือ 5,000 บรรทัดไม่ค่อยจำเป็นต้องเก็บไว้เต็มหลังเอเจนต์ใช้แล้ว
3. สรุปแทนการทิ้ง เมื่อเทิร์นเก่ามีความสำคัญ ให้ขอให้โมเดลบีบอัดเป็นบันทึกสั้น ๆ ครั้งเดียว แล้วแทนที่ข้อความเก่าด้วยบันทึกนั้น คุณจ่ายเพิ่มหนึ่งครั้งและเก็บเธรดไว้
4. เปลี่ยนไปหน้าต่างที่ใหญ่ขึ้น การเปลี่ยนจาก MiniMax-M2.7 (180K) เป็น GLM-5.3-Flash (390K) หรือ DeepSeek-V4-Flash (380K) คือการเปลี่ยน model id บรรทัดเดียว หากคุณต้องการคำตอบยาวด้วย DeepSeek-V4-Flash อนุญาตเอาต์พุตสูงสุด 32,768 โทเค็น และทั้งสามใช้ยอดคงเหลือร่วมกัน ดังนั้นการสลับไม่มีค่าใช้จ่ายในการตั้งค่า
เช็กลิสต์
ก่อนส่งคำขอที่ล้มเหลวอีกครั้ง
ประวัติยาวมีค่าใช้จ่ายเท่าไร#
การตัดทอนไม่ใช่แค่เรื่องข้อผิดพลาด แต่ละขั้นของเอเจนต์ส่งประวัติทั้งหมดซ้ำ ดังนั้นประวัติที่บวมยังเป็นส่วนที่แพงของบิลด้วย ใช้เวลางาน 30 ขั้นที่แต่ละขั้นส่งประมาณ 100K โทเค็นและได้กลับประมาณ 1,500:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 30 คำขอ | OpenRouter, 30 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100,000 โทเค็นอินพุตและ 1,500 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ตารางราคางานเดียวกันบนแต่ละโมเดลด้วยอัตราปัจจุบัน ตัดประวัติเหลือหนึ่งในสี่ ฝั่งอินพุตจะลดลงประมาณสามในสี่ หากต้องการดูว่าเอเจนต์ของคุณใช้โทเค็นที่ไหน ติดตามการใช้งานต่อคำขอใน Python; สำหรับกลไก ทำไมเอเจนต์ใช้โทเค็นมากมาย อธิบายผ่านตัวอย่าง 20 ขั้น
DeepSeek-V4-Flash ปัจจุบันมีค่าใช้จ่าย $0.015 ต่อ 1M อินพุตโทเค็นและ $0.10 ต่อ 1M เอาต์พุตโทเค็น ราคาเดียวทุกชั่วโมง ลองตัวเลขของคุณเอง:
เครื่องคำนวณค่าใช้จ่าย
งานเอเจนต์ 30 ขั้นพร้อมประวัติ 100K
โทเค็นอินพุตต่อคำขอ: 100,000 · โทเค็นเอาต์พุตต่อคำขอ: 1,500 · คำขอต่อวัน: 30
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
หากยังล้มเหลว#
คำขอยาวบนลิงก์ช้ามีความล้มเหลวแยกต่างหาก: Anthropic แนะนำให้ใช้สตรีมมิ่งหรือ Batch API สำหรับคำขอยาวที่มี max_tokens ขนาดใหญ่ เพราะเครือข่ายอาจตัดการเชื่อมต่อที่ไม่ได้ใช้งาน และ SDK ของพวกเขาคาดว่าคำขอที่ไม่สตรีมจะเสร็จภายใน 10 นาที หากข้อผิดพลาดเป็น timeout หรือการเชื่อมต่อหลุดแทนที่จะเป็น 400 ดูข้อผิดพลาดการเชื่อมต่อและตั้ง stream=True
หากข้อความเป็น 401 หรือ 404 ปัญหาคือคีย์ base URL หรือ model id แทน: ข้อผิดพลาด API 401 หรือ 404 สำหรับ base URL ที่แน่นอน model id และตัวอย่าง เปิดเอกสาร CheapTokens


