Khắc phục sự cốHướng dẫn
Yêu cầu quá dài: 400 so với 413, cửa sổ ngữ cảnh và max_tokens
Phân biệt lỗi 413 (quá nhiều byte) với lỗi độ dài token (thường là 400), kiểm tra đầu vào cộng max_tokens so với cửa sổ ngữ cảnh, và thu nhỏ yêu cầu.
Trên trang này
Chat của bạn chạy tốt trong bốn mươi lượt, rồi mọi yêu cầu bắt đầu thất bại. Câu trả lời ngắn gọn: "request too long" ẩn chứa hai giới hạn khác nhau. Lỗi 413 nghĩa là yêu cầu quá lớn tính theo byte và bị từ chối trước khi bất kỳ mô hình nào nhìn thấy nó. Nếu lỗi phàn nàn về độ dài tính bằng token (thường là lỗi yêu cầu không hợp lệ thuộc nhóm 400), thì đầu vào của bạn cộng với câu trả lời bạn yêu cầu không vừa cửa sổ ngữ cảnh; đọc error.message để biết là trường hợp nào. Cách khắc phục là đo, rồi cắt bớt.
Hướng dẫn này chỉ cách phân biệt hai loại lỗi, cách kiểm tra phép tính trước khi gửi, và bốn cách thu nhỏ yêu cầu. Nếu thuật ngữ còn mới, cửa sổ ngữ cảnh là gì giải thích bằng lời đơn giản.
Hai giới hạn, hai lỗi#
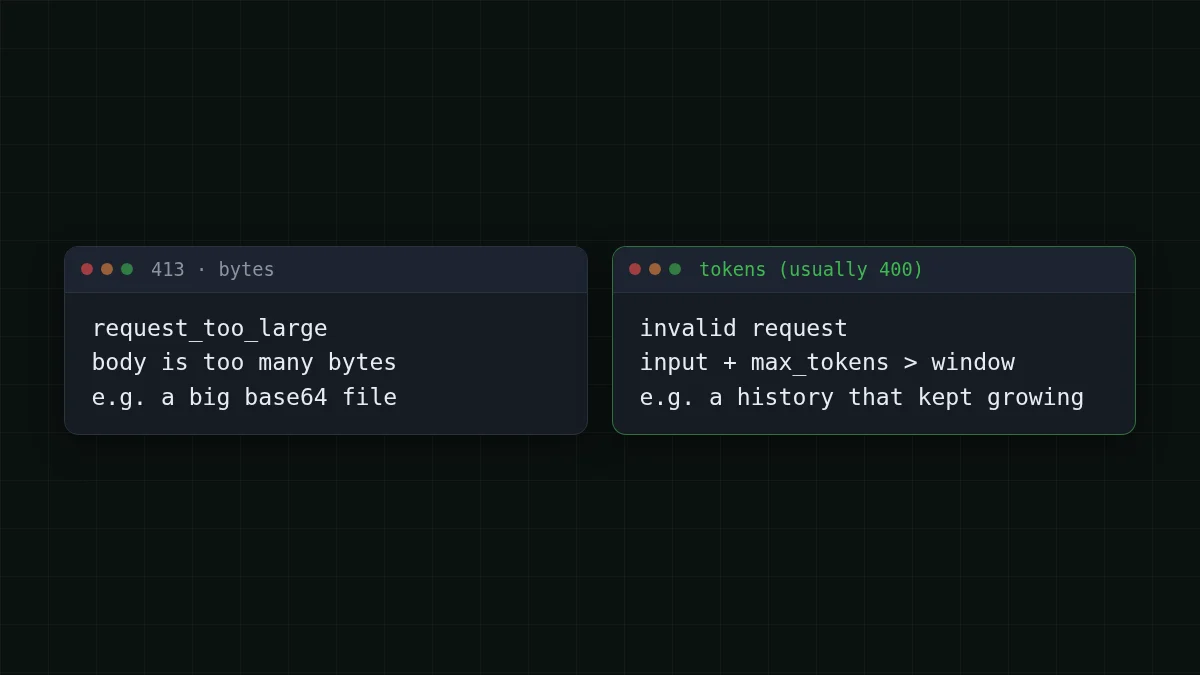
Lỗi 413 giống như bưu điện từ chối một bưu kiện quá lớn; lỗi token là mô hình nói rằng lá thư không vừa cửa sổ đọc của nó. Chúng thất bại ở những nơi khác nhau và cần cách khắc phục khác nhau.
Trang lỗi API của Anthropic (kiểm tra ngày 29 tháng 10 năm 2026) mô tả 413 request_ là yêu cầu vượt quá số byte tối đa: 128 MB cho Messages API, 256 MB cho Batch API, 500 MB cho Files API. Lỗi 400 invalid_ bao gồm các vấn đề về định dạng hoặc nội dung của yêu cầu. Đó là các giới hạn của Anthropic. Trang của họ không liệt kê thông báo đếm token, và hướng dẫn mã lỗi của OpenAI cũng vậy, nên đừng xây dựng logic dựa trên từ ngữ chính xác bạn thấy trong một chủ đề diễn đàn.
Trên thực tế, các cuộc trò chuyện chỉ có văn bản thường tăng token lâu trước khi tăng byte. Byte trở thành vấn đề khi bạn đính kèm hình ảnh base64 hoặc toàn bộ tài liệu. Token trở thành vấn đề khi lịch sử tăng lên, và đó là trường hợp phổ biến.
Ghép cặp
Ghép mỗi triệu chứng với nguyên nhân
Nhấn vào một mục bên trái, rồi đến cặp của nó
- 413 request_too_largePhần thân có quá nhiều byte, ví dụ tệp đính kèm base64 lớn
- Lỗi độ dài token ngay sau khi dán một nhật ký khổng lồChỉ riêng lời nhắc đã có nhiều token hơn cửa sổ ngữ cảnh
- 400 sau một lời nhắc khoảng 375K token với max_tokens=32768 trên mô hình 380KCộng lại có thể vượt cửa sổ
- Cùng lịch sử, mô hình khácKiểm tra cửa sổ của từng mô hình: lịch sử vừa với mô hình này có thể không vừa mô hình khác
Phần thân lỗi là JSON với một type: error ở cấp cao nhất, một đối tượng error có type và message riêng, và một id yêu cầu. Đọc error.message và giữ lại id yêu cầu; với các SDK chính thức, hãy bắt ngoại lệ có kiểu thay vì so khớp chuỗi.
Kiểm tra phép tính trước khi gửi#
Thói quen tiết kiệm thời gian nhất: đừng đợi lỗi. Trước mỗi lần gọi, hãy cộng ba thứ và so sánh với cửa sổ.
- Token trong các tin nhắn của bạn (lời nhắc hệ thống, lịch sử, câu hỏi mới).
max_tokensbạn đang yêu cầu.- Cửa sổ ngữ cảnh của mô hình.
Giữ đầu vào cộng câu trả lời yêu cầu nằm trong cửa sổ. Các cửa sổ trên CheapTokens là 390K cho GLM-5.3-Flash, 380K cho DeepSeek-V4-Flash và 180K cho MiniMax-M2.7; câu trả lời lên tới 8.192 token trên GLM và MiniMax và tới 32.768 trên DeepSeek-V4-Flash. Xem trang giá và mô hình để biết danh sách hiện tại.
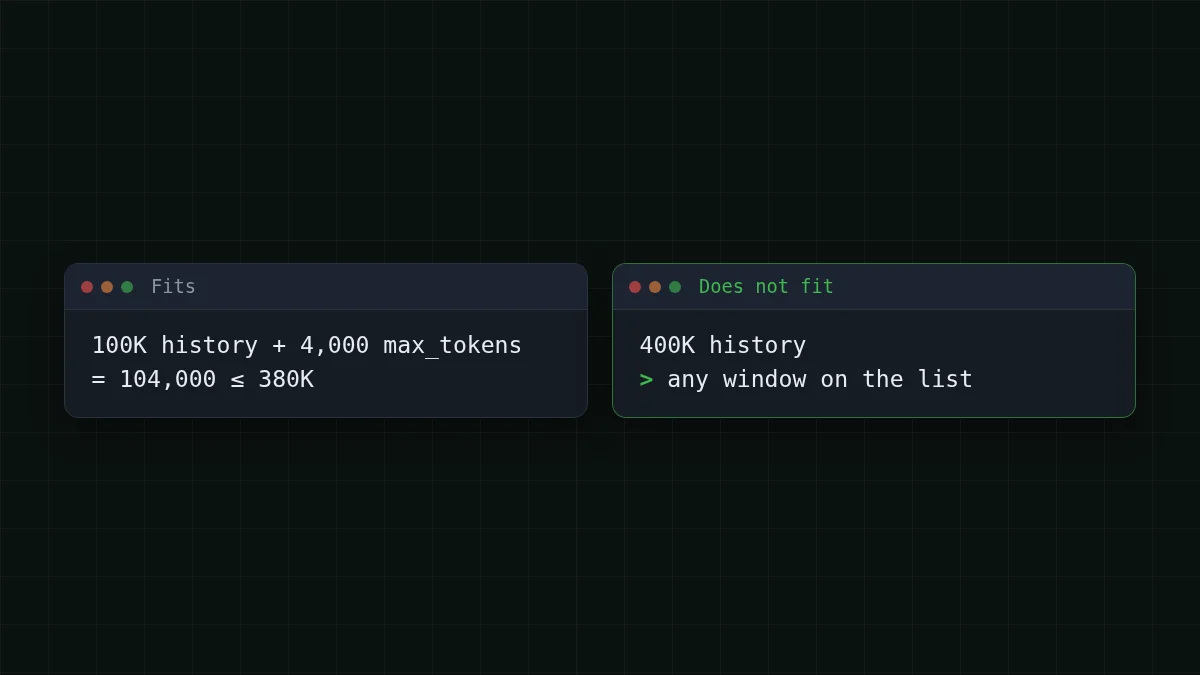
Giả sử agent của bạn gửi lịch sử 100K token và yêu cầu trả về 4.000 token. Đó là 100.000 + 4.000 = 104.000 token, thoải mái trên cả ba. Bây giờ cùng agent đó sau thêm năm mươi bước: 400K. Không cửa sổ nào trong danh sách chứa được, bất kể bạn đặt max_tokens là bao nhiêu. Đó là thời điểm lỗi xuất hiện, và nó có vẻ đột ngột chỉ vì lịch sử tăng dần mỗi lượt.
Một bộ đếm thô là đủ để làm chốt chặn. Văn bản tiếng Anh trung bình khoảng 4 ký tự mỗi token; mã và văn bản không phải tiếng Anh dùng nhiều token hơn mỗi ký tự, nên để dư một biên:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
Dòng cuối là hiệu chuẩn của bạn: usage. là những gì API thực sự đếm. So sánh nó với rough_ vài lần và điều chỉnh ước số và biên cho văn bản của riêng bạn.
Bốn cách thu nhỏ yêu cầu#
Chọn cách khắc phục rẻ nhất hiệu quả, theo thứ tự này.
1. Giảm max_tokens. Chỉ yêu cầu câu trả lời bạn cần: đầu vào cộng max_tokens là thứ bạn phải giữ trong cửa sổ, và mỗi mô hình có giới hạn riêng cho câu trả lời (8.192 hoặc 32.768 token ở trên). Đừng đặt max_tokens cao hơn nhu cầu câu trả lời, và không vượt giới hạn câu trả lời của mô hình. Nếu câu trả lời dừng ở giới hạn bạn đặt, nó kết thúc bằng finish_, thứ có cách khắc phục riêng.
2. Cắt bớt lịch sử. Bỏ các lượt cũ nhất, giữ lời nhắc hệ thống và vài trao đổi cuối. Hàm trim ở trên làm đúng điều này. Với agent, cũng cắt phần cồng kềnh: đầu ra công cụ 5.000 dòng hiếm khi cần giữ nguyên sau khi agent đã dùng chúng.
3. Tóm tắt thay vì bỏ. Khi các lượt cũ quan trọng, hãy nhờ mô hình một lần nén chúng thành một ghi chú ngắn, rồi thay các tin nhắn cũ bằng ghi chú đó. Bạn trả cho một lần gọi thêm và giữ được mạch hội thoại.
4. Chuyển sang cửa sổ lớn hơn. Chuyển từ MiniMax-M2.7 (180K) sang GLM-5.3-Flash (390K) hoặc DeepSeek-V4-Flash (380K) chỉ là đổi id mô hình một dòng. Nếu bạn cũng cần câu trả lời dài, DeepSeek-V4-Flash cho phép tới 32.768 token đầu ra, và cả ba dùng chung một số dư, nên chuyển đổi không tốn gì về thiết lập.
Danh sách kiểm tra
Trước khi gửi lại một yêu cầu thất bại
Lịch sử dài tốn kém thế nào#
Cắt bớt không chỉ để tránh lỗi. Mỗi bước của agent gửi lại toàn bộ lịch sử, nên lịch sử phình to cũng là phần tốn kém của hóa đơn. Lấy một tác vụ 30 bước, mỗi bước gửi khoảng 100K token và nhận về khoảng 1.500:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 30 yêu cầu | OpenRouter, 30 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100.000 token đầu vào và 1.500 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Bảng định giá cùng tác vụ đó trên từng mô hình với mức giá hiện hành. Cắt lịch sử xuống một phần tư thì phía đầu vào giảm khoảng ba phần tư. Để xem agent của bạn tiêu token ở đâu, theo dõi mức sử dụng theo từng yêu cầu trong Python; về cơ chế, tại sao agent dùng nhiều token đến vậy đi qua một ví dụ 20 bước.
DeepSeek-V4-Flash hiện có giá $0.015 mỗi 1M token đầu vào và $0.10 mỗi 1M token đầu ra, một mức giá bất kể giờ nào. Thử với số liệu của riêng bạn:
Máy tính chi phí
Một tác vụ agent 30 bước với lịch sử 100K
Token đầu vào mỗi yêu cầu: 100.000 · Token đầu ra mỗi yêu cầu: 1.500 · Số yêu cầu mỗi ngày: 30
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
Nếu vẫn thất bại#
Các yêu cầu dài trên đường truyền chậm có một lỗi riêng: Anthropic khuyên dùng streaming hoặc Batch API cho các yêu cầu dài với max_tokens lớn, vì mạng có thể ngắt kết nối nhàn rỗi, và các SDK của họ kỳ vọng yêu cầu không streaming hoàn thành trong vòng 10 phút. Nếu lỗi là hết thời gian chờ hoặc mất kết nối chứ không phải 400, xem lỗi kết nối và đặt stream=True.
Nếu thông báo là 401 hoặc 404, vấn đề là khóa, URL cơ sở hoặc id mô hình: lỗi API 401 hoặc 404. Để biết URL cơ sở chính xác, id mô hình và ví dụ, mở tài liệu CheapTokens.


