AI cho người mớiHướng dẫn
Cửa sổ ngữ cảnh trong AI là gì? Điều gì lấp đầy nó và cần làm gì
Cửa sổ ngữ cảnh là bộ nhớ làm việc của mô hình cho một yêu cầu: lời nhắc của bạn, lịch sử trò chuyện và câu trả lời. Xem điều gì lấp đầy nó, cách ước lượng nó, và ba thói quen.
Trên trang này
Cuộc trò chuyện của bạn chạy tốt trong hai mươi tin nhắn, và giờ câu trả lời trở nên mơ hồ. Một thứ tăng lên theo từng tin nhắn là cửa sổ ngữ cảnh: bộ nhớ làm việc của mô hình cho một yêu cầu. Nó chứa mọi thứ bạn gửi cộng với câu trả lời mà mô hình viết, và nó có kích thước cố định, ví dụ 380K token cho DeepSeek-V4-Flash.
Cửa sổ ngữ cảnh là gì#
Hãy nghĩ đến một cái bàn. Mô hình chỉ có thể làm việc với những gì đang ở trên bàn ngay lúc này: hướng dẫn của bạn, cuộc trò chuyện đến giờ, một tài liệu được dán vào và câu trả lời nó đang viết. Bất cứ thứ gì không ở trên bàn đều không tồn tại với nó. Tài liệu của Anthropic về cửa sổ ngữ cảnh (kiểm tra ngày 27 tháng 10 năm 2026) nói điều tương tự: cửa sổ là toàn bộ văn bản mà mô hình có thể tham chiếu khi nó tạo ra phản hồi, bao gồm cả phản hồi đó, và nó tách biệt với dữ liệu mà mô hình được huấn luyện.
Cái bàn có kích thước cố định, tính bằng token. Một token là một mẩu văn bản, xấp xỉ ¾ của một từ tiếng Anh; token trong AI là gì đi sâu hơn. Đây là ba mô hình trên CheapTokens và cửa sổ của chúng:
- GLM-5.3-Flash: 390K token
- DeepSeek-V4-Flash: 380K token
- MiniMax-M2.7: 180K token
K nghĩa là nghìn. Cửa sổ 380K khoảng 285.000 từ tiếng Anh: 380.000 × 0,75 = 285.000. Đó là vài cuốn tiểu thuyết trên một cái bàn, và nó vẫn cạn nhanh hơn bạn tưởng.
Những gì được tính vào đó#
Mọi thứ trong yêu cầu đều được tính, không chỉ tin nhắn cuối của bạn:
- lời nhắc hệ thống (các hướng dẫn thường trực);
- mọi tin nhắn trước đó, của bạn và của mô hình;
- định nghĩa công cụ và kết quả công cụ, nếu bạn dùng tác nhân hoặc plugin trình soạn thảo;
- tài liệu và hình ảnh bạn đính kèm;
- chính câu trả lời, bao gồm mọi suy nghĩ mà mô hình thực hiện.
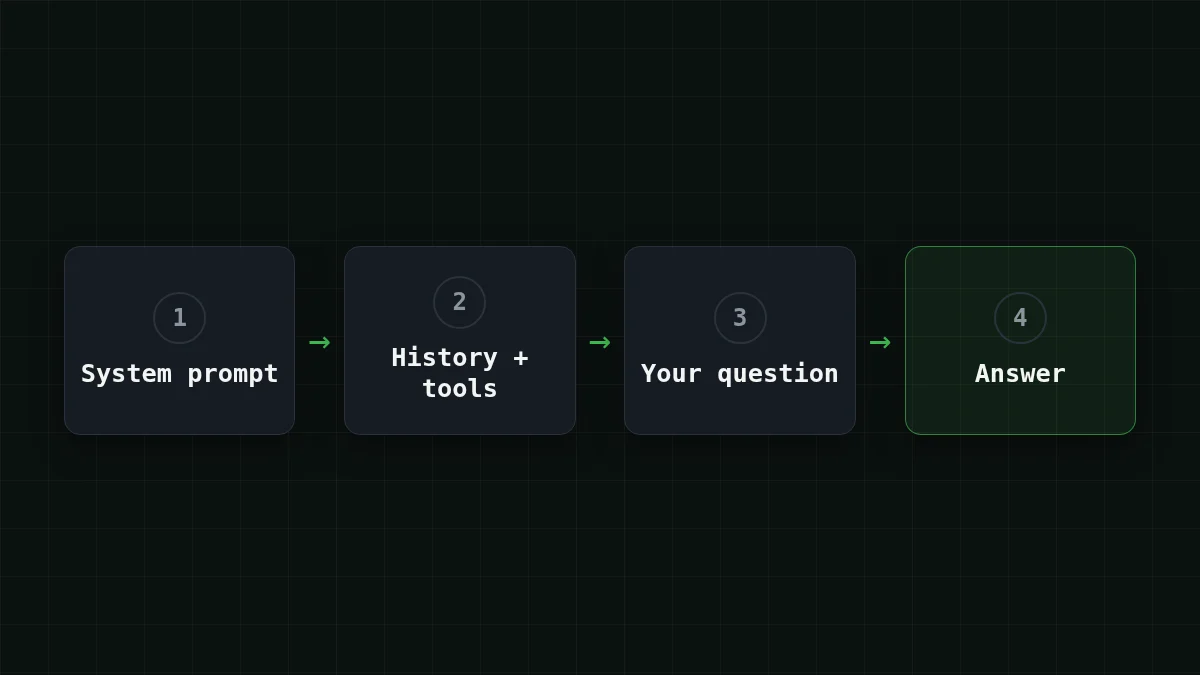
Một tác nhân trình soạn thảo là trường hợp âm thầm. Ở mỗi bước, nó gửi lại danh sách công cụ cộng với mọi thứ nó đã đọc đến giờ. Bạn gõ một câu; cửa sổ thấy nhiều hơn thế.
Bạn không phải đoán kích thước. Mỗi phản hồi mang một trường usage với số lượng token. Vòng lặp trò chuyện tối giản này (API tương thích OpenAI, id mô hình từ tài liệu CheapTokens) cho thấy cả hai điều cùng lúc: toàn bộ lịch sử được gửi đi ở mỗi lượt, và số lượng được trả về.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
Gọi ask() mười lần và xem con số đầu tiên leo lên. Sự leo thang đó là toàn bộ câu chuyện của bài viết này.
Cửa sổ so với đầu ra tối đa: hai con số khác nhau#
Mỗi trang mô hình liệt kê hai kích thước, và người mới thường nhầm lẫn chúng. Cửa sổ là toàn bộ cái bàn, đầu vào và đầu ra cùng nhau. Giới hạn đầu ra là độ dài tối đa của một câu trả lời: lên đến 32.768 token cho DeepSeek-V4-Flash, lên đến 8.192 cho GLM-5.3-Flash và MiniMax-M2.7.
Chúng chia sẻ cùng một không gian. Đầu vào của bạn chiếm bao nhiêu, câu trả lời phải vừa với phần còn lại. Nếu bạn muốn xem câu trả lời bị cắt trông như thế nào, vì sao câu trả lời AI dừng giữa câu đi qua điều đó.
Kiểm tra nhanh
DeepSeek-V4-Flash có cửa sổ 380K và giới hạn đầu ra 32.768 token. Bạn gửi 375K token đầu vào. Câu trả lời có thể dài khoảng bao nhiêu?
Hiện đáp án
Trả lời: Khoảng 5K token, phần còn lại trong cửa sổ
Cửa sổ bao gồm đầu vào và đầu ra cùng nhau: 380K − 375K còn lại khoảng 5K, thấp hơn mức trần 32.768.
Vì sao một cuộc trò chuyện dài làm đầy cửa sổ (và hóa đơn)#
Mô hình không nhớ tin nhắn cuối của bạn. Để duy trì cuộc trò chuyện, API nhận lại toàn bộ lịch sử ở mỗi lượt: các lượt trước được giữ nguyên vẹn, và câu trả lời của mô hình trở thành một phần của đầu vào tiếp theo. (Các ứng dụng trò chuyện đôi khi âm thầm bỏ những tin nhắn cũ nhất; API không làm điều đó thay bạn.)
Giả sử bạn trò chuyện với một trợ lý hỗ trợ trong 30 lượt. Giả định lời nhắc hệ thống 400 token, 150 token mỗi câu hỏi và 450 mỗi câu trả lời, vậy mỗi lần trao đổi thêm 600 token vào lịch sử.
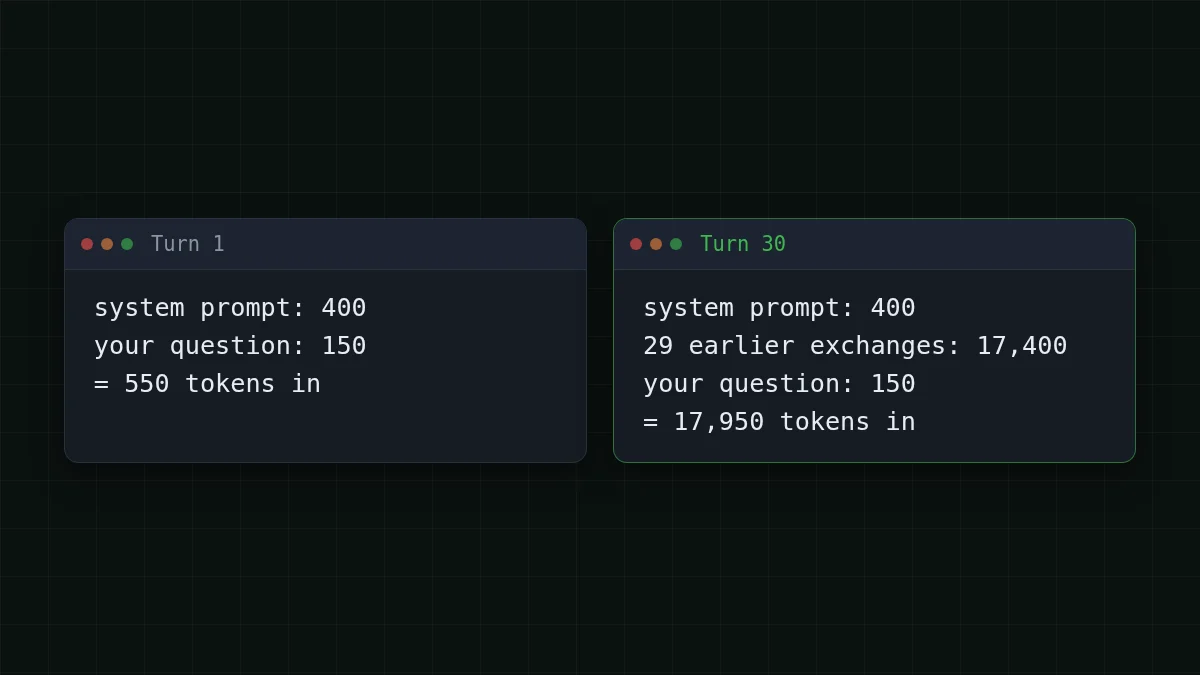
Lượt 1 gửi khoảng 550 token. Lượt 30 gửi 400 + 150 + 29 × 600 = 17.950. Cộng dồn qua toàn bộ cuộc trò chuyện, mỗi lượt mang theo 550 token của điểm khởi đầu riêng, vậy 30 × 550 = 16.500. Trên đó, lượt n gửi lại n − 1 lần trao đổi trước đó, mỗi lần 600 token: 600 × 435 = 261.000, trong đó 435 = 1 + 2 + … + 29. Đầu vào của toàn bộ cuộc trò chuyện là 16.500 + 261.000 = 277.500 token, và các câu trả lời thêm 30 × 450 = 13.500.
Trên DeepSeek-V4-Flash, toàn bộ cuộc trò chuyện đó tốn $0.0055. Đây là cả ba mô hình, với giá tham chiếu OpenRouter bên cạnh; tính cả đầu vào và đầu ra, mỗi mô hình đều rẻ hơn OpenRouter cho cuộc trò chuyện này:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Chi phí | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
Tổng cộng 277.500 token đầu vào và 13.500 token đầu ra. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Tính trung bình, cuộc trò chuyện đó là 277.500 ÷ 30 = 9.250 token vào mỗi yêu cầu và 450 ra.
Muốn có cuộc trò chuyện của riêng bạn? Thay đổi các con số bên dưới, ví dụ thành 100 lượt, và xem tổng tăng nhanh thế nào.
Máy tính chi phí
Cùng cuộc trò chuyện 30 lượt, tính trung bình
Token đầu vào mỗi yêu cầu: 9.250 · Token đầu ra mỗi yêu cầu: 450 · Số yêu cầu mỗi ngày: 30
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
Giờ đến phần trung thực. 17.950 token chưa đến 5% của cửa sổ 380K, nên một cuộc trò chuyện thông thường hiếm khi chạm tường. Thứ tăng lên là hóa đơn và nhiễu. Tài liệu của Anthropic lưu ý rằng độ chính xác và khả năng hồi tưởng giảm khi số token tăng (họ gọi đây là mục nát ngữ cảnh), nên cửa sổ lớn hơn không tự động tốt hơn: thứ bạn đưa vào quan trọng không kém gì lượng vừa. Nơi bức tường thực sự xuất hiện là tài liệu và tác nhân. Trên API của chính Anthropic, một yêu cầu mà chỉ đầu vào đã lớn hơn cửa sổ sẽ nhận lỗi 400, lời nhắc quá dài. Về khía cạnh chi phí của cùng hiệu ứng này, xem vì sao một cuộc trò chuyện AI dài tốn hơn.
Tài liệu của tôi có vừa không?#
Một quy tắc thô cho văn bản tiếng Anh: một token khoảng ¾ của một từ, nên token ≈ từ ÷ 0,75. Các ngôn ngữ khác thường tốn nhiều token hơn mỗi từ, nên để thêm biên. Hãy thử trước khi đọc tiếp.
Đoán số
Một cuốn sách 90.000 từ là bao nhiêu token?
Dự đoán của bạn
0300.000
Hiện đáp án
Trả lời: 120.000
Khoảng 120.000: 90.000 ÷ 0,75 = 120.000. Nó vừa trong bất kỳ cửa sổ nào của ba mô hình với chỗ dư.
Giờ một trường hợp lớn hơn. Giả sử bạn có một kho lưu trữ 150.000 từ gồm email hỗ trợ và muốn một bản tóm tắt: 150.000 ÷ 0,75 = 200.000 token. 200.000 token nhiều hơn cửa sổ 180K, nên với kho lưu trữ này hãy chọn GLM-5.3-Flash (390K) hoặc DeepSeek-V4-Flash (380K). DeepSeek-V4-Flash vẫn còn 380.000 − 200.000 = 180.000 token chỗ trống trên DeepSeek-V4-Flash, quá đủ cho một bản tóm tắt dưới giới hạn trả lời 32.768 token của nó. Đọc 200.000 token đó và viết một bản tóm tắt 2.000 token tốn $0.0032.
Một trường hợp nhỏ hơn: một báo cáo 60.000 từ là 60.000 ÷ 0,75 = 80.000 token. MiniMax-M2.7 xử lý nó với 100K dư, khiến cửa sổ 180K của nó đủ cho trò chuyện và tài liệu cỡ trung.
Ba thói quen cho một cửa sổ gần đầy#
1. Tóm tắt và khởi động lại. Ở lượt 30, yêu cầu mang 17.950 token. Yêu cầu mô hình viết một bản tóm tắt 200 token về các quyết định đến giờ, rồi bắt đầu một cuộc trò chuyện mới với nó. Yêu cầu tiếp theo là 400 + 200 + 150 = 750 token vào, và mô hình vẫn biết điều gì quan trọng.
2. Chỉ gửi phần bạn cần. Dán chương bạn đang hỏi, không phải cả cuốn sách; hàm, không phải cả kho mã. Ít hơn trên bàn nghĩa là hóa đơn nhỏ hơn, và, theo ghi chú về mục nát ngữ cảnh của Anthropic, một mô hình có ít thứ để lạc lối hơn.
3. Giữ các phần cố định gọn gàng và theo dõi usage. Lời nhắc hệ thống, định nghĩa công cụ và kết quả công cụ dài đi kèm ở mỗi bước. Cắt bớt những gì bạn không dùng, in số lượng token sau mỗi phản hồi như trong vòng lặp trên, và đặt max_tokens thành độ dài bạn thực sự cần.
Khi bạn muốn thử điều này trên một mô hình thật, tài liệu CheapTokens chỉ yêu cầu đầu tiên trong vài dòng, và trang giá liệt kê giá trực tiếp của từng mô hình. Với tài liệu dài và vòng lặp tác nhân, DeepSeek-V4-Flash (ngữ cảnh 380K, lên đến 32.768 token đầu ra, một mức giá cố định không có giờ cao điểm) và GLM-5.3-Flash (390K, cửa sổ lớn nhất trong ba mô hình) là những mô hình nên xem xét trước tiên.


