Yeni başlayanlar için AIKılavuz
AI'da bağlam penceresi nedir? Neler doldurur ve ne yapmalı
Bağlam penceresi bir modelin tek bir istek için çalışma belleğidir: isteminiz, sohbet geçmişi ve yanıt. Neler doldurduğunu, nasıl tahmin edileceğini ve üç alışkanlığı görün.
Bu sayfada
Sohbetiniz yirmi mesaj boyunca sorunsuz çalıştı ve şimdi yanıtlar belirsizleşiyor. Her mesajla birlikte büyüyen tek şey bağlam penceresidir: modelin tek bir istek için çalışma belleği. Gönderdiğiniz her şeyi ve modelin yazdığı yanıtı tutar ve sabit bir boyutu vardır, örneğin DeepSeek-V4-Flash için 380K token.
Bağlam penceresi nedir#
Bir masa düşünün. Model yalnızca şu anda masada olanlarla çalışabilir: talimatlarınız, şimdiye kadarki konuşma, yapıştırılmış bir belge ve yazmakta olduğu yanıt. Masada olmayan hiçbir şey onun için var olmaz. Anthropic'in bağlam pencereleri hakkındaki belgeleri (27 Ekim 2026'da kontrol edildi) bunu aynı şekilde ifade eder: pencere, bir modelin yanıt üretirken başvurabileceği tüm metindir, yanıtın kendisi dahil, ve modelin eğitildiği verilerden ayrıdır.
Masanın sabit bir boyutu vardır ve token cinsinden sayılır. Token bir metin parçasıdır, kabaca bir İngilizce kelimenin ¾'ü; AI'da token nedir daha derine iner. İşte CheapTokens üzerindeki üç model ve pencereleri:
- GLM-5.3-Flash: 390K token
- DeepSeek-V4-Flash: 380K token
- MiniMax-M2.7: 180K token
K bin anlamına gelir. 380K'lık bir pencere yaklaşık 285.000 İngilizce kelimedir: 380.000 × 0.75 = 285.000. Bu tek bir masada birkaç roman demektir ve yine de düşündüğünüzden daha hızlı dolar.
Neler pencereye sayılır#
İstekteki her şey sayılır, yalnızca son mesajınız değil:
- sistem istemi (sürekli talimatlar);
- sizin ve modelin önceki her mesajı;
- bir ajan veya editör eklentisi kullanıyorsanız araç tanımları ve araç sonuçları;
- eklediğiniz belgeler ve görseller;
- yanıtın kendisi, modelin yaptığı her türlü düşünme dahil.
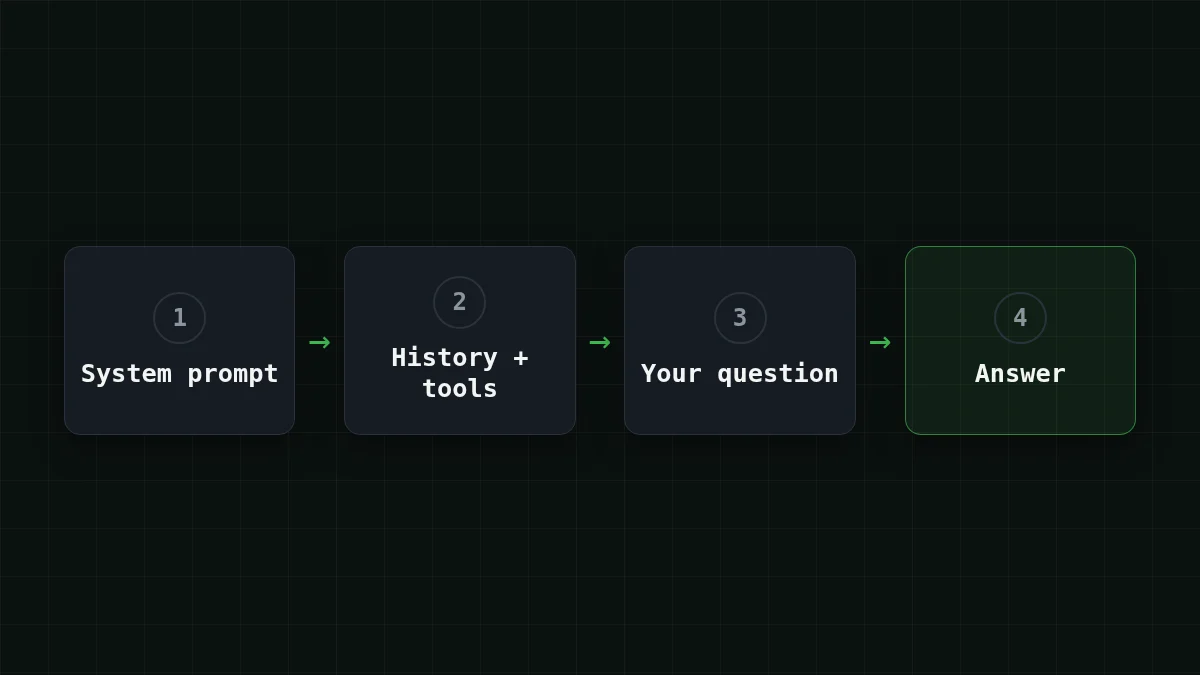
Bir editör ajanı sinsi durumdur. Her adımda araç listesini yeniden ve o ana kadar okuduğu her şeyi gönderir. Siz bir cümle yazdınız; pencere çok daha fazlasını görür.
Boyutu tahmin etmek zorunda değilsiniz. Her yanıt, token sayılarını içeren bir usage alanı taşır. Bu minimal sohbet döngüsü (OpenAI uyumlu API, model kimliği CheapTokens belgelerinden) her iki şeyi aynı anda gösterir: tüm geçmiş her turda gönderilir ve sayılar geri gelir.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
ask() on kez çağırın ve ilk sayının tırmandığını izleyin. Bu tırmanış bu makalenin tüm hikayesidir.
Pencere ile maksimum çıktı: iki farklı sayı#
Her model sayfası iki boyut listeler ve yeni başlayanlar bunları sık sık karıştırır. Pencere tüm masadır, girdi ve çıktı birlikte. Çıktı sınırı bir yanıtın ne kadar uzun olabileceğidir: DeepSeek-V4-Flash için 32.768 token'a kadar, GLM-5.3-Flash ve MiniMax-M2.7 için 8.192'ye kadar.
Aynı alanı paylaşırlar. Girdiniz ne kadar yer alırsa, yanıt kalan kısma sığmak zorundadır. Kesilmiş bir yanıtın nasıl göründüğünü görmek isterseniz, bir AI yanıtı neden cümle ortasında durur bunu adım adım anlatır.
Hızlı kontrol
DeepSeek-V4-Flash'in 380K penceresi ve 32.768 token'lık çıktı sınırı vardır. 375K token girdi gönderiyorsunuz. Yanıt yaklaşık ne kadar uzun olabilir?
Cevabı göster
Cevap: Yaklaşık 5K token, pencerede kalan kadar
Pencere girdi ve çıktıyı birlikte kapsar: 380K − 375K yaklaşık 5K bırakır, bu da 32.768 sınırının altındadır.
Uzun bir sohbet pencereyi (ve faturayı) neden doldurur#
Bir model son mesajınızı hatırlamaz. Bir konuşmayı sürdürmek için API her turda tüm geçmişi yeniden alır: önceki turlar tamamen saklanır ve modelin yanıtı bir sonraki girdinin parçası olur. (Sohbet uygulamaları bazen en eski mesajları sessizce düşürür; API bunu sizin için yapmaz.)
Bir destek asistanıyla 30 tur sohbet ettiğinizi varsayalım. 400 token'lık bir sistem istemi, soru başına 150 token ve yanıt başına 450 token varsayın, böylece her alışveriş geçmişe 600 token ekler.
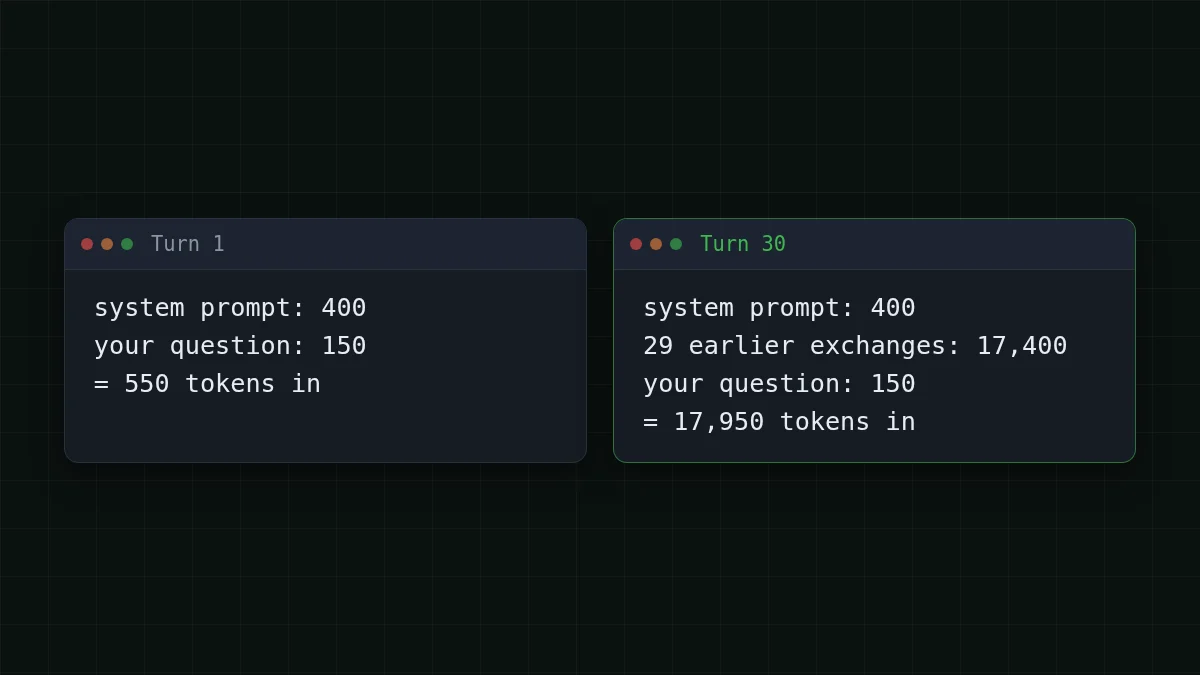
1. tur yaklaşık 550 token gönderir. 30. tur 400 + 150 + 29 × 600 = 17.950 gönderir. Tüm sohbet boyunca toplandığında, her tur kendi başlangıcının 550 token'ını taşır, yani 30 × 550 = 16.500. Bunun üzerine, n. tur her biri 600 token'lık n − 1 önceki alışverişi yeniden gönderir: 600 × 435 = 261.000, burada 435 = 1 + 2 + … + 29. Tüm sohbetin girdisi 16.500 + 261.000 = 277.500 token'dır ve yanıtlar 30 × 450 = 13.500 ekler.
DeepSeek-V4-Flash'te tüm bu sohbet $0.0055 tutar. İşte üç modelin tümü, yanlarında OpenRouter referans fiyatıyla; girdi ve çıktı birlikte sayıldığında, her biri bu sohbet için OpenRouter'dan daha ucuzdur:
| Model | Giriş $/1M | Çıkış $/1M | Maliyet | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
Toplamda 277.500 giriş ve 13.500 çıkış token'ı. 1M token başına fiyatlar günceldir ve tarifelerimizle birlikte değişir; OpenRouter sütunu aynı iş yükü için referans fiyatları gösterir.
Ortalamada, bu sohbet istek başına 277.500 ÷ 30 = 9.250 token girdi ve 450 çıktıdır.
Kendi sohbetinizi mi istiyorsunuz? Aşağıdaki sayıları değiştirin, örneğin 100 tura, ve toplamın ne kadar hızlı büyüdüğünü izleyin.
Maliyet hesaplayıcı
Aynı 30 turluk sohbet, ortalamada
İstek başına giriş token'ı: 9.250 · İstek başına çıkış token'ı: 450 · Günlük istek sayısı: 30
| Model | Günlük | Aylık |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
Şimdi dürüst kısım. 17.950 token, 380K'lık bir pencerenin %5'inin altındadır, bu yüzden sıradan bir sohbet duvara nadiren çarpar. Büyüyen şey fatura ve gürültüdür. Anthropic'in belgeleri, token sayısı arttıkça doğruluk ve hatırlamanın bozulduğunu belirtir (buna bağlam çürümesi der), bu yüzden daha büyük bir pencere otomatik olarak daha iyi değildir: ne koyduğunuz, ne kadarının sığdığı kadar önemlidir. Duvarla gerçekten karşılaştığınız yer belgeler ve ajanlardır. Anthropic'in kendi API'sinde, yalnızca girdisi pencereden büyük olan bir istek 400 hatası alır, istem çok uzun. Aynı etkinin maliyet tarafı için, uzun bir AI sohbeti neden daha pahalıdır bölümüne bakın.
Belgem sığar mı?#
İngilizce metin için kaba bir kural: bir token yaklaşık bir kelimenin ¾'üdür, yani token ≈ kelime ÷ 0.75. Diğer diller genellikle kelime başına daha fazla token alır, bu yüzden ekstra pay bırakın. Okumaya devam etmeden önce deneyin.
Sayıyı tahmin et
90.000 kelimelik bir kitap kaç token'dır?
Tahminin
0300.000
Cevabı göster
Cevap: 120.000
Yaklaşık 120.000: 90.000 ÷ 0.75 = 120.000. Üç pencereden herhangi birine bolca sığar.
Şimdi daha büyük bir durum. 150.000 kelimelik bir destek e-postası arşiviniz olduğunu ve bir özet istediğinizi varsayalım: 150.000 ÷ 0.75 = 200.000 token. 200.000 token, 180K'lık bir pencereden daha fazladır, bu yüzden bu arşiv için GLM-5.3-Flash (390K) veya DeepSeek-V4-Flash (380K) seçin. DeepSeek-V4-Flash, DeepSeek-V4-Flash'te hâlâ 380.000 − 200.000 = 180.000 token yer bırakır, bu da 32.768 token'lık yanıt sınırının altındaki bir özet için fazlasıyla yeterlidir. Bu 200.000 token'ı okumak ve 2.000 token'lık bir özet yazmak $0.0032 tutar.
Daha küçük bir durum: 60.000 kelimelik bir rapor 60.000 ÷ 0.75 = 80.000 token'dır. MiniMax-M2.7 bunu 100K boşlukla halleder, bu da 180K'lık penceresini sohbetler ve orta boy belgeler için yeterli kılar.
Neredeyse dolu bir pencere için üç alışkanlık#
1. Özetleyin ve yeniden başlatın. 30. turda istek 17.950 token taşır. Modelden şimdiye kadarki kararların 200 token'lık bir özetini yazmasını isteyin, sonra onunla yeni bir sohbet başlatın. Sonraki istek 400 + 200 + 150 = 750 token girdidir ve model hâlâ neyin önemli olduğunu bilir.
2. Yalnızca ihtiyacınız olan kısmı gönderin. Hakkında soru sorduğunuz bölümü yapıştırın, tüm kitabı değil; fonksiyonu, tüm depoyu değil. Masada daha az şey olması daha küçük bir fatura ve Anthropic'in bağlam çürümesi notuna göre, kaybolacak daha az şeyi olan bir model demektir.
3. Sabit kısımları yalın tutun ve usage'yi izleyin. Sistem istemi, araç tanımları ve uzun araç sonuçları her adımda birlikte taşınır. Kullanmadığınız şeyleri kırpın, yukarıdaki döngüde olduğu gibi her yanıttan sonra token sayılarını yazdırın ve max_tokens'yi gerçekten ihtiyacınız olan uzunluğa ayarlayın.
Bunu gerçek bir modelde denemek istediğinizde, CheapTokens belgeleri ilk isteği birkaç satırda gösterir ve fiyatlandırma sayfası her modelin canlı fiyatını listeler. Uzun belgeler ve ajan döngüleri için, önce DeepSeek-V4-Flash (380K bağlam, 32.768 çıktı token'ına kadar, yoğun saatler olmadan tek sabit fiyat) ve GLM-5.3-Flash (390K, üçünün en büyük penceresi) bakılacak modellerdir.


