نئے سیکھنے والوں کے لیے AIگائیڈ
AI میں سیاق و سباق کی ونڈو کیا ہے؟ اسے کیا بھرتا ہے اور کیا کرنا چاہیے
سیاق و سباق کی ونڈو ایک درخواست کے لیے ماڈل کی کام کرنے والی یادداشت ہے: آپ کا پرامپٹ، چیٹ کی ہسٹری اور جواب۔ دیکھیں کہ اسے کیا بھرتا ہے، اس کا اندازہ کیسے لگائیں، اور تین عادات۔
اس صفحہ پر
آپ کی چیٹ بیس پیغامات تک ٹھیک چلتی رہی، اور اب جوابات مبہم ہونے لگے ہیں۔ ایک چیز جو ہر پیغام کے ساتھ بڑھتی ہے وہ سیاق و سباق کی ونڈو ہے: ایک درخواست کے لیے ماڈل کی کام کرنے والی یادداشت۔ یہ وہ سب کچھ رکھتی ہے جو آپ بھیجتے ہیں اور ساتھ ہی ماڈل کا لکھا ہوا جواب بھی، اور اس کا سائز مقرر ہوتا ہے، مثلاً DeepSeek-V4-Flash کے لیے 380K ٹوکنز۔
سیاق و سباق کی ونڈو کیا ہے#
ایک میز کا تصور کریں۔ ماڈل صرف اسی چیز پر کام کر سکتا ہے جو اس وقت میز پر موجود ہے: آپ کی ہدایات، اب تک کی گفتگو، ایک پیسٹ کیا گیا دستاویز اور وہ جواب جو وہ لکھ رہا ہے۔ جو چیز میز پر نہیں ہے وہ اس کے لیے وجود نہیں رکھتی۔ Anthropic کی سیاق و سباق کی ونڈوز سے متعلق دستاویزات (27 اکتوبر 2026 کو دیکھی گئی) بھی یہی کہتی ہیں: ونڈو وہ تمام متن ہے جس کا ماڈل جواب تیار کرتے وقت حوالہ دے سکتا ہے، بشمول خود جواب کے، اور یہ اس ڈیٹا سے الگ ہے جس پر ماڈل کو تربیت دی گئی تھی۔
میز کا سائز مقرر ہوتا ہے، جسے ٹوکنز میں شمار کیا جاتا ہے۔ ٹوکن متن کا ایک ٹکڑا ہے، تقریباً انگریزی کے ایک لفظ کا ¾ حصہ؛ AI میں ٹوکن کیا ہے اس پر مزید گہرائی سے بات کرتا ہے۔ یہاں CheapTokens پر تین ماڈلز اور ان کی ونڈوز ہیں:
- GLM-5.3-Flash: 390K ٹوکنز
- DeepSeek-V4-Flash: 380K ٹوکنز
- MiniMax-M2.7: 180K ٹوکنز
K کا مطلب ہزار ہے۔ 380K ونڈو تقریباً 285,000 انگریزی الفاظ ہے: 380,000 × 0.75 = 285,000۔ یہ ایک میز پر کئی ناول ہیں، اور پھر بھی یہ آپ کی توقع سے زیادہ تیزی سے ختم ہو جاتی ہے۔
اس میں کیا شمار ہوتا ہے#
درخواست میں موجود ہر چیز شمار ہوتی ہے، صرف آپ کا آخری پیغام نہیں:
- سسٹم پرامپٹ (مستقل ہدایات)؛
- ہر پچھلا پیغام، آپ کا اور ماڈل کا؛
- ٹول کی تعریفیں اور ٹول کے نتائج، اگر آپ ایجنٹ یا ایڈیٹر پلگ ان استعمال کرتے ہیں؛
- وہ دستاویزات اور تصاویر جو آپ منسلک کرتے ہیں؛
- خود جواب، بشمول ماڈل کی کوئی بھی سوچ۔
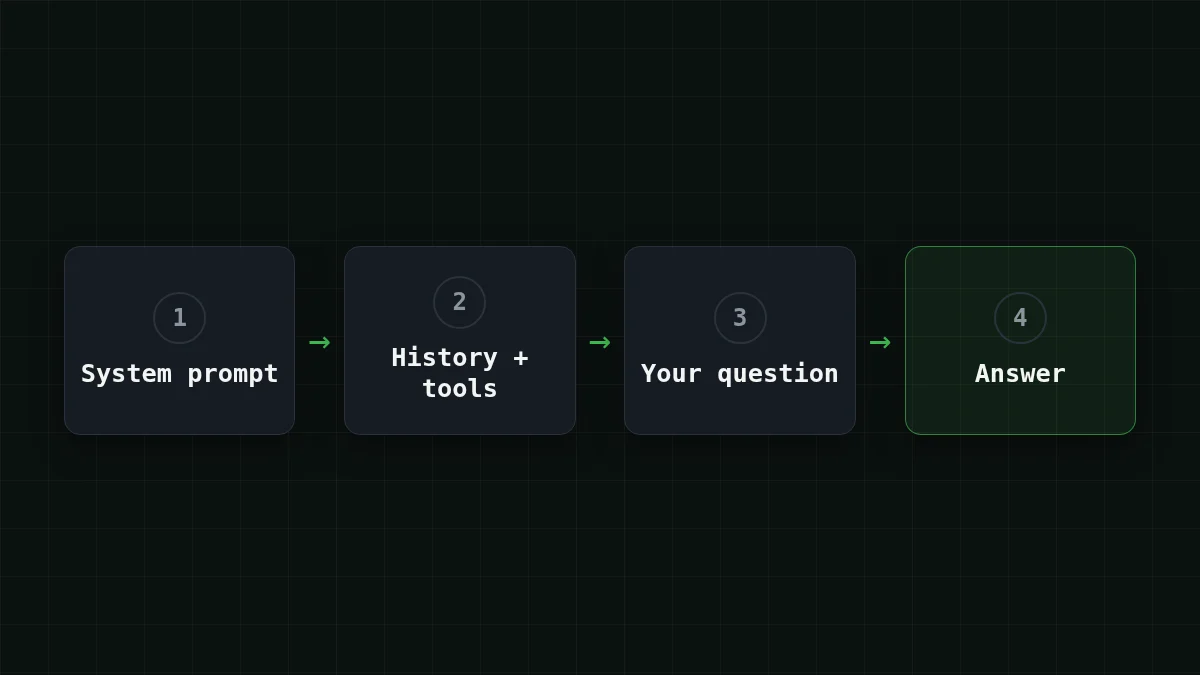
ایڈیٹر ایجنٹ خفیہ معاملہ ہے۔ ہر قدم پر یہ ٹول کی فہرست دوبارہ بھیجتا ہے اور ساتھ ہی وہ سب کچھ جو اس نے اب تک پڑھا ہے۔ آپ نے ایک جملہ ٹائپ کیا؛ ونڈو اس سے کہیں زیادہ دیکھتی ہے۔
آپ کو سائز کا اندازہ لگانے کی ضرورت نہیں۔ ہر جواب میں ٹوکن کی گنتی کے ساتھ usage فیلڈ ہوتی ہے۔ یہ کم سے کم چیٹ لوپ (OpenAI-کمپیٹیبل API، ماڈل آئی ڈی CheapTokens دستاویزات سے) دونوں چیزیں ایک ساتھ دکھاتا ہے: پوری ہسٹری ہر بار باہر جاتی ہے، اور گنتی واپس آتی ہے۔
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
ask() کو دس بار کال کریں اور پہلے نمبر کو بڑھتے ہوئے دیکھیں۔ یہی بڑھوتری اس مضمون کی پوری کہانی ہے۔
ونڈو بمقابلہ زیادہ سے زیادہ آؤٹ پٹ: دو مختلف نمبر#
ہر ماڈل صفحہ دو سائز دکھاتا ہے، اور نئے لوگ اکثر انہیں آپس میں ملا دیتے ہیں۔ ونڈو پوری میز ہے، ان پٹ اور آؤٹ پٹ ایک ساتھ۔ آؤٹ پٹ کی حد یہ ہے کہ ایک جواب کتنا لمبا ہو سکتا ہے: DeepSeek-V4-Flash کے لیے 32,768 ٹوکنز تک، GLM-5.3-Flash اور MiniMax-M2.7 کے لیے 8,192 تک۔
وہ ایک ہی جگہ شیئر کرتے ہیں۔ آپ کا ان پٹ جو بھی لے، جواب کو باقی میں فٹ ہونا پڑتا ہے۔ اگر آپ دیکھنا چاہتے ہیں کہ کٹا ہوا جواب کیسا لگتا ہے، AI کا جواب درمیان جملے میں کیوں رک جاتا ہے اس پر روشنی ڈالتا ہے۔
فوری جانچ
DeepSeek-V4-Flash کی ونڈو 380K اور آؤٹ پٹ کی حد 32,768 ٹوکنز ہے۔ آپ 375K ٹوکنز ان پٹ بھیجتے ہیں۔ جواب تقریباً کتنا لمبا ہو سکتا ہے؟
جواب دکھائیں
جواب: تقریباً 5K ٹوکنز، جو ونڈو میں بچا ہے
ونڈو ان پٹ اور آؤٹ پٹ دونوں کو ملا کر محیط ہے: 380K − 375K تقریباً 5K چھوڑتا ہے، جو 32,768 کی حد سے کم ہے۔
لمبی چیٹ ونڈو (اور بل) کیوں بھرتی ہے#
ماڈل آپ کا آخری پیغام یاد نہیں رکھتا۔ گفتگو جاری رکھنے کے لیے، API کو ہر بار پوری ہسٹری دوبارہ ملتی ہے: پچھلے موڑ مکمل طور پر رکھے جاتے ہیں، اور ماڈل کا جواب اگلے ان پٹ کا حصہ بن جاتا ہے۔ (چیٹ ایپس کبھی کبھی سب سے پرانے پیغامات خاموشی سے گرا دیتی ہیں؛ API آپ کے لیے ایسا نہیں کرتا۔)
فرض کریں آپ سپورٹ اسسٹنٹ سے 30 موڑ تک چیٹ کرتے ہیں۔ فرض کریں 400 ٹوکنز کا سسٹم پرامپٹ، ہر سوال پر 150 ٹوکنز اور ہر جواب پر 450، تو ہر تبادلہ ہسٹری میں 600 ٹوکنز کا اضافہ کرتا ہے۔
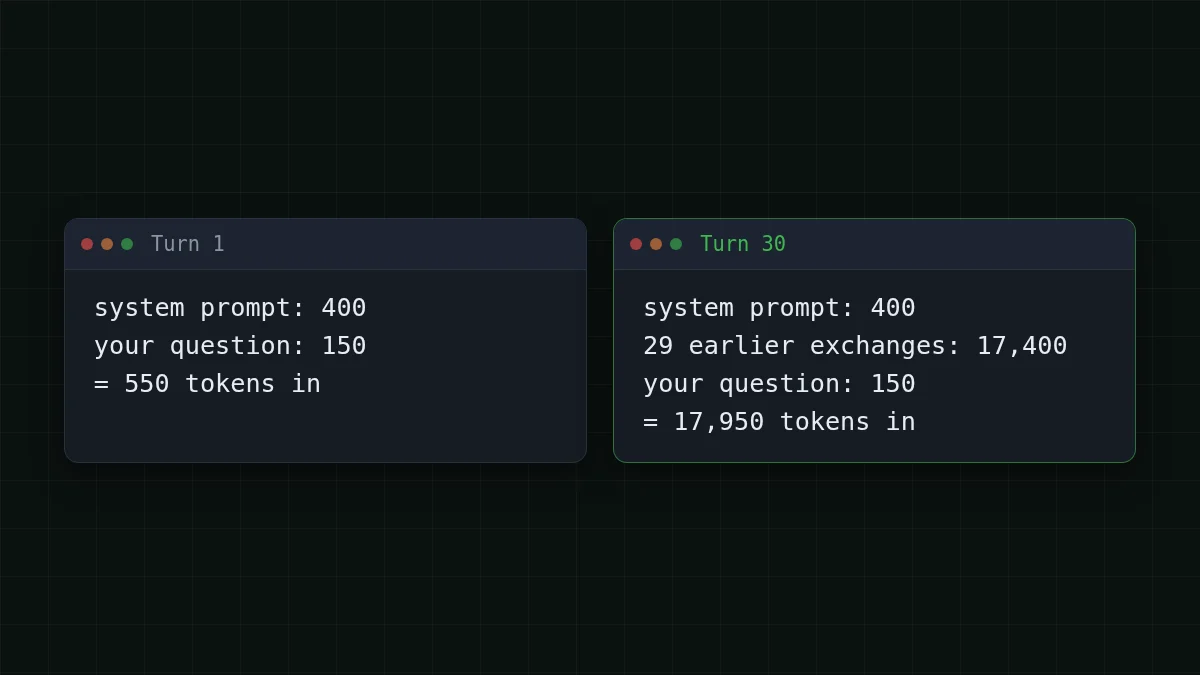
موڑ 1 تقریباً 550 ٹوکنز بھیجتا ہے۔ موڑ 30 بھیجتا ہے 400 + 150 + 29 × 600 = 17,950۔ پوری چیٹ میں جمع کرنے پر، ہر موڑ اپنے آغاز کے 550 ٹوکنز ساتھ لے جاتا ہے، تو 30 × 550 = 16,500۔ اس کے اوپر، موڑ n پچھلے n − 1 تبادلے ہر ایک 600 ٹوکنز کے دوبارہ بھیجتا ہے: 600 × 435 = 261,000، جہاں 435 = 1 + 2 + … + 29۔ پوری چیٹ کا ان پٹ 16,500 + 261,000 = 277,500 ٹوکنز ہے، اور جوابات 30 × 450 = 13,500 کا اضافہ کرتے ہیں۔
DeepSeek-V4-Flash پر اس پوری چیٹ کی لاگت $0.0055 ہے۔ یہاں تینوں ماڈلز ہیں، ساتھ میں OpenRouter کا حوالہ قیمت؛ ان پٹ اور آؤٹ پٹ ملا کر شمار کرنے پر، اس چیٹ کے لیے ہر ایک OpenRouter سے سستا ہے:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | لاگت | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
کل 277,500 ان پٹ اور 13,500 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
اوسطاً، وہ چیٹ فی درخواست 277,500 ÷ 30 = 9,250 ٹوکنز ان پٹ اور 450 آؤٹ پٹ ہے۔
اپنی چیٹ چاہتے ہیں؟ نیچے دیے گئے نمبر بدلیں، مثلاً 100 موڑ تک، اور دیکھیں کہ کل کتنی تیزی سے بڑھتا ہے۔
لاگت کیلکولیٹر
وہی 30-موڑ کی چیٹ، اوسطاً
فی درخواست ان پٹ ٹوکنز: 9,250 · فی درخواست آؤٹ پٹ ٹوکنز: 450 · فی دن درخواستیں: 30
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
اب ایماندار حصہ۔ 17,950 ٹوکنز 380K ونڈو کے 5% سے کم ہیں، تو ایک سادہ چیٹ شاذ و نادر ہی دیوار سے ٹکراتی ہے۔ جو بڑھتا ہے وہ بل اور شور ہے۔ Anthropic کی دستاویزات نوٹ کرتی ہیں کہ ٹوکن کی تعداد بڑھنے کے ساتھ درستگی اور یاد آوری کم ہوتی جاتی ہے (اسے یہ سیاق و سباق کی سڑاند کہتی ہے)، تو بڑی ونڈو خود بخود بہتر نہیں ہوتی: آپ کیا ڈالتے ہیں اس سے اتنا ہی فرق پڑتا ہے جتنا کہ کتنا فٹ ہوتا ہے۔ جہاں دیوار واقعی ظاہر ہوتی ہے وہ دستاویزات اور ایجنٹ ہیں۔ Anthropic کے اپنے API پر، ایسی درخواست جس کا صرف ان پٹ ہی ونڈو سے بڑا ہو، 400 ایرر، پرامپٹ بہت لمبا ہے، وصول کرتی ہے۔ اسی اثر کے لاگت کے پہلو کے لیے، لمبی AI چیٹ زیادہ مہنگی کیوں ہوتی ہے دیکھیں۔
کیا میری دستاویز فٹ ہوگی؟#
انگریزی متن کے لیے ایک موٹا اصول: ایک ٹوکن تقریباً ایک لفظ کا ¾ ہے، تو ٹوکنز ≈ الفاظ ÷ 0.75۔ دوسری زبانیں عام طور پر فی لفظ زیادہ ٹوکنز لیتی ہیں، تو اضافی گنجائش رکھیں۔ آگے پڑھنے سے پہلے آزمائیں۔
نمبر کا اندازہ لگائیں
90,000 الفاظ کی کتاب کتنے ٹوکنز ہے؟
آپ کا اندازہ
0300,000
جواب دکھائیں
جواب: 120,000
تقریباً 120,000: 90,000 ÷ 0.75 = 120,000۔ یہ تینوں ونڈوز میں کافی جگہ کے ساتھ فٹ ہو جاتی ہے۔
اب ایک بڑا معاملہ۔ فرض کریں آپ کے پاس سپورٹ ای میلز کا 150,000 الفاظ کا آرکائیو ہے اور آپ خلاصہ چاہتے ہیں: 150,000 ÷ 0.75 = 200,000 ٹوکنز۔ 200,000 ٹوکنز 180K ونڈو سے زیادہ ہیں، تو اس آرکائیو کے لیے GLM-5.3-Flash (390K) یا DeepSeek-V4-Flash (380K) منتخب کریں۔ DeepSeek-V4-Flash پر اب بھی 380,000 − 200,000 = 180,000 ٹوکنز کی جگہ بچتی ہے، جو اس کی 32,768-ٹوکنز جواب کی حد کے تحت خلاصے کے لیے کافی سے زیادہ ہے۔ ان 200,000 ٹوکنز کو پڑھنے اور 2,000-ٹوکنز کا خلاصہ لکھنے کی لاگت $0.0032 ہے۔
ایک چھوٹا معاملہ: 60,000 الفاظ کی رپورٹ 60,000 ÷ 0.75 = 80,000 ٹوکنز ہے۔ MiniMax-M2.7 اسے 100K بچت کے ساتھ سنبھال لیتا ہے، جو اس کی 180K ونڈو کو چیٹس اور درمیانے سائز کی دستاویزات کے لیے کافی بناتا ہے۔
تقریباً بھری ونڈو کے لیے تین عادات#
1. خلاصہ کریں اور دوبارہ شروع کریں۔ موڑ 30 پر درخواست 17,950 ٹوکنز اٹھاتی ہے۔ ماڈل سے کہیں کہ اب تک کے فیصلوں کا 200-ٹوکنز خلاصہ لکھے، پھر اس کے ساتھ نئی چیٹ شروع کریں۔ اگلی درخواست 400 + 200 + 150 = 750 ٹوکنز ان پٹ ہے، اور ماڈل پھر بھی جانتا ہے کہ کیا اہم ہے۔
2. صرف وہی حصہ بھیجیں جس کی آپ کو ضرورت ہے۔ جس باب کے بارے میں پوچھ رہے ہیں وہ پیسٹ کریں، پوری کتاب نہیں؛ فنکشن، پورا ریپوزٹری نہیں۔ میز پر کم رکھنے کا مطلب چھوٹا بل، اور Anthropic کے سیاق و سباق کی سڑاند والے نوٹ کے مطابق، ایسا ماڈل جس میں کھونے کے لیے کم ہو۔
3. مقررہ حصوں کو کم رکھیں اور usage پر نظر رکھیں۔ سسٹم پرامپٹ، ٹول کی تعریفیں اور لمبے ٹول نتائج ہر قدم پر ساتھ چلتے ہیں۔ جو استعمال نہیں کرتے اسے تراشیں، اوپر والے لوپ کی طرح ہر جواب کے بعد ٹوکن کی گنتی پرنٹ کریں، اور max_tokens کو اسی لمبائی پر سیٹ کریں جس کی آپ کو واقعی ضرورت ہے۔
جب آپ یہ کسی حقیقی ماڈل پر آزمانا چاہیں، تو CheapTokens دستاویزات چند سطروں میں پہلی درخواست دکھاتی ہیں، اور قیمتوں کا صفحہ ہر ماڈل کی لائیو قیمت درج کرتا ہے۔ لمبی دستاویزات اور ایجنٹ لوپس کے لیے، DeepSeek-V4-Flash (380K سیاق و سباق، 32,768 آؤٹ پٹ ٹوکنز تک، ایک مقررہ قیمت بغیر مصروف اوقات) اور GLM-5.3-Flash (390K، تینوں میں سب سے بڑی ونڈو) پہلے دیکھنے والے ماڈلز ہیں۔


