AI для новичковИнструкция
Что такое окно контекста в ИИ: что его заполняет и что делать
Окно контекста — рабочая память модели на один запрос: ваш промпт, история чата и ответ. Что его заполняет, как оценить в токенах и три привычки для полного окна.
Содержание
Чат отлично шёл двадцать сообщений, а теперь ответы расплывчатые. С каждым сообщением растёт окно контекста — рабочая память модели на один запрос. В неё входит всё, что вы отправили, плюс ответ, который пишет модель, а размер у неё фиксированный: например, 380K токенов у DeepSeek-V4-Flash.
Что такое окно контекста#
Представьте рабочий стол. Модель работает только с тем, что лежит на столе прямо сейчас: ваши инструкции, переписка до этого момента, вставленный документ и ответ, который она пишет. Чего на столе нет, того для неё не существует. Документация Anthropic об окнах контекста (сверено 27 октября 2026) говорит то же самое: окно — это весь текст, на который модель может опираться при генерации ответа, включая сам ответ, и оно не имеет отношения к данным, на которых модель обучали.
Размер стола считается в токенах. Токен — кусочек текста, примерно ¾ английского слова; подробнее в статье что такое токен в ИИ. Вот три модели CheapTokens и их окна:
- GLM-5.3-Flash: 390K токенов
- DeepSeek-V4-Flash: 380K токенов
- MiniMax-M2.7: 180K токенов
K — это тысяча. Окно в 380K — около 285 000 английских слов: 380 000 × 0.75 = 285 000. Это несколько романов на одном столе, и всё равно места уходит быстрее, чем кажется.
Что входит в окно#
Считается всё содержимое запроса, а не только ваше последнее сообщение:
- системный промпт (постоянные инструкции);
- все прошлые сообщения — ваши и модели;
- описания инструментов и их результаты, если вы работаете с агентом или плагином редактора;
- документы и картинки, которые вы приложили;
- сам ответ, включая рассуждения модели, если они есть.
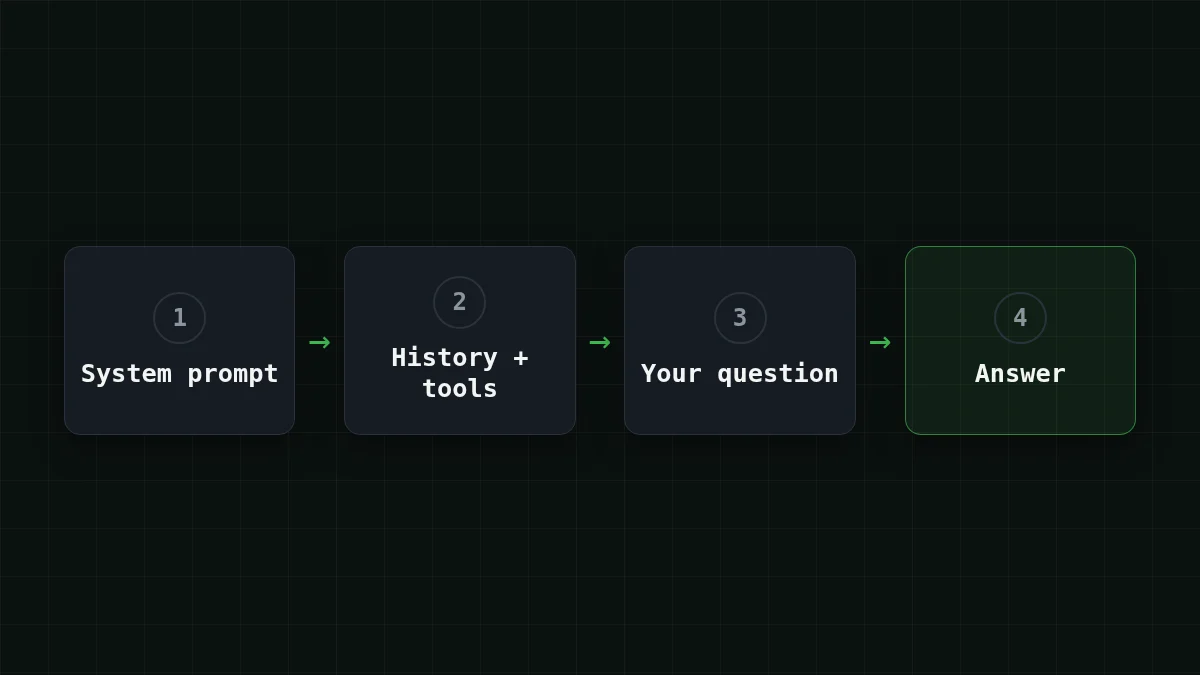
Коварнее всего ведёт себя агент в редакторе. На каждом шаге он снова отправляет список инструментов и всё, что уже прочитал. Вы написали одну фразу, а окно видит намного больше.
Гадать с размером не нужно: в каждом ответе есть поле usage с числом токенов. Этот минимальный цикл чата (OpenAI-совместимый API, id модели — из документации CheapTokens) показывает сразу две вещи: вся история уходит на каждом ходу, а счётчики возвращаются.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
Вызовите ask() десять раз и смотрите, как растёт первое число. Вся эта статья — про этот рост.
Окно и максимум ответа — два разных числа#
На странице любой модели указаны два размера, и новички их путают. Окно — это весь стол, вход и выход вместе. Лимит ответа — это длина одного ответа: до 32 768 токенов у DeepSeek-V4-Flash, до 8 192 у GLM-5.3-Flash и MiniMax-M2.7.
Место у них общее. Сколько займёт вход, столько и вычтется: ответ должен поместиться в остаток. Как выглядит оборвавшийся ответ, разобрано в статье почему ответ ИИ обрывается на полуслове.
Быстрая проверка
У DeepSeek-V4-Flash окно 380K и лимит ответа 32 768 токенов. Вы отправили 375K токенов входа. Какой длины может быть ответ?
Показать ответ
Ответ: Около 5K токенов — сколько осталось в окне
Окно покрывает вход и выход вместе: 380K − 375K оставляет около 5K, а это меньше лимита 32 768.
Почему длинный чат заполняет окно (и счёт)#
Модель не помнит ваше прошлое сообщение. Чтобы разговор продолжался, API на каждом ходу получает всю историю заново: прошлые реплики сохраняются целиком, а ответ модели становится частью следующего входа. (Приложения-чаты иногда молча выбрасывают самые старые сообщения; API за вас этого не делает.)
Допустим, вы 30 ходов говорите с ассистентом поддержки. Примем системный промпт в 400 токенов, 150 токенов на вопрос и 450 на ответ — значит, каждая пара реплик добавляет в историю 600 токенов.
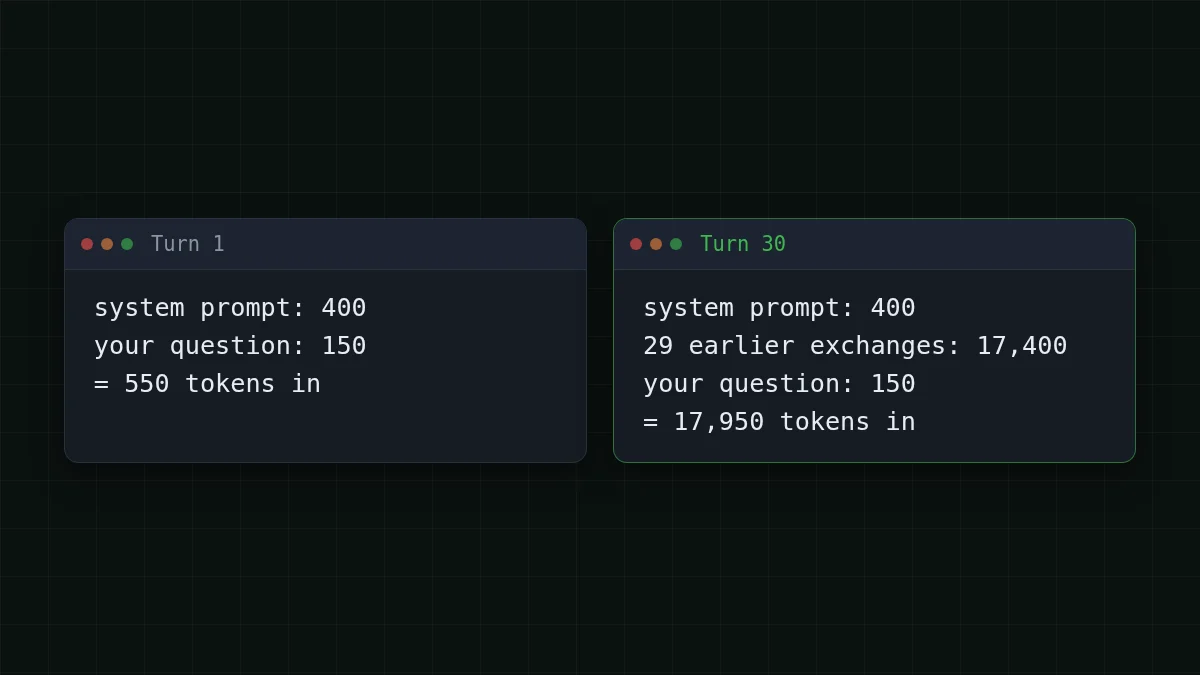
Ход 1 отправляет около 550 токенов. Ход 30 отправляет 400 + 150 + 29 × 600 = 17 950. Теперь сложим весь чат. Каждый ход несёт свои 550 токенов начала, поэтому 30 × 550 = 16 500. Сверху ход n заново отправляет n − 1 прошлых пар реплик по 600 токенов: 600 × 435 = 261 000, где 435 = 1 + 2 + … + 29. Вход всего чата — 16 500 + 261 000 = 277 500 токенов, а ответы добавляют 30 × 450 = 13 500.
На DeepSeek-V4-Flash весь этот чат стоит $0.0055. Ниже все три модели, рядом — справочная цена OpenRouter; если считать вход и выход вместе, для этого чата каждая из них дешевле OpenRouter:
| Модель | Вход $/1M | Выход $/1M | Стоимость | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
277 500 входных и 13 500 выходных токенов всего. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
В среднем этот чат — это 277 500 ÷ 30 = 9 250 токенов входа на запрос и 450 выхода.
Хотите свой чат? Поменяйте числа ниже, например на 100 ходов, и посмотрите, как быстро растёт итог.
Калькулятор стоимости
Тот же чат из 30 ходов, в среднем
Входные токены на запрос: 9 250 · Выходные токены на запрос: 450 · Запросов в день: 30
| Модель | В день | В месяц |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
Теперь честно. 17 950 токенов — меньше 5% окна в 380K, так что обычный чат редко упирается в стену. Растут счёт и шум. Anthropic в документации отмечает, что с ростом числа токенов точность и полнота вспоминания падают (это называют context rot), поэтому большое окно не всегда лучше: важно не только сколько влезает, но и что вы туда кладёте. Стена появляется там, где документы и агенты. В API самой Anthropic запрос, у которого один только вход больше окна, получает ошибку 400 prompt is too long. А про денежную сторону того же эффекта — в статье почему длинный чат с ИИ стоит дороже.
Поместится ли мой документ#
Грубое правило для английского текста: один токен — около ¾ слова, то есть токены ≈ слова ÷ 0.75. В других языках на слово обычно уходит больше токенов, так что берите запас. Прикиньте сами, прежде чем читать дальше.
Угадайте число
Сколько токенов в книге на 90 000 слов?
Ваш вариант
0300 000
Показать ответ
Ответ: 120 000
Около 120 000: 90 000 ÷ 0.75 = 120 000. Это помещается в любое из трёх окон с большим запасом.
Теперь случай покрупнее. Допустим, у вас архив писем в поддержку на 150 000 слов и нужна сводка: 150 000 ÷ 0.75 = 200 000 токенов. 200 000 токенов больше окна в 180K, так что для этого архива берите GLM-5.3-Flash (390K) или DeepSeek-V4-Flash (380K). На DeepSeek-V4-Flash ещё останется 380 000 − 200 000 = 180 000 токенов — с запасом хватит на сводку в пределах лимита ответа 32 768. Прочитать эти 200 000 токенов и написать сводку на 2 000 стоит $0.0032.
И случай поменьше: отчёт на 60 000 слов — это 60 000 ÷ 0.75 = 80 000 токенов. MiniMax-M2.7 справится с запасом в 100K, так что окна в 180K хватает на чаты и документы среднего размера.
Три привычки для почти полного окна#
1. Сожмите и начните заново. На ходу 30 запрос несёт 17 950 токенов. Попросите модель написать сводку принятых решений на 200 токенов и откройте новый чат с ней. Следующий запрос — уже 400 + 200 + 150 = 750 токенов входа, а модель по-прежнему знает главное.
2. Отправляйте только нужный кусок. Вставьте главу, о которой спрашиваете, а не всю книгу; функцию, а не весь репозиторий. Меньше на столе — меньше счёт, а если верить заметке Anthropic о context rot, ещё и модели меньше в чём теряться.
3. Держите постоянные части короткими и смотрите на usage. Системный промпт, описания инструментов и длинные результаты инструментов едут с каждым шагом. Уберите то, чем не пользуетесь, печатайте счётчики токенов после каждого ответа, как в цикле выше, и ставьте max_tokens по реально нужной длине.
Когда захотите попробовать на настоящей модели, документация CheapTokens покажет первый запрос в нескольких строках, а на странице цен — живая цена каждой модели. Для длинных документов и агентных циклов первыми стоит посмотреть DeepSeek-V4-Flash (контекст 380K, до 32 768 токенов в ответе, одна цена без пиковых часов) и GLM-5.3-Flash (390K — самое большое окно из трёх).


