AI 入门指南
AI 中的上下文窗口是什么?什么会填满它以及该怎么办
上下文窗口是模型针对单次请求的工作记忆:你的提示词、聊天历史和答案。了解什么会填满它、如何估算它,以及三个习惯。
你的聊天在前二十条消息时运行良好,现在答案却变得含糊不清。随着每条消息不断增长的一个东西就是上下文窗口:模型针对单次请求的工作记忆。它容纳你发送的所有内容以及模型写出的答案,并且它有固定的大小,例如 DeepSeek-V4-Flash 为 380K tokens。
什么是上下文窗口#
把上下文窗口想象成一张书桌。模型只能处理此刻放在桌面上的东西:你的指令、到目前为止的对话、粘贴的文档以及它正在写的答案。任何不在桌面上的东西对它来说都不存在。Anthropic 关于上下文窗口的文档(2026 年 10 月 27 日查阅)也是这么说的:窗口是模型在生成响应时可以引用的所有文本,包括响应本身,并且它与模型训练所用的数据是分开的。
这张书桌有固定的大小,以 tokens 计算。一个 token 是一段文本,大约相当于 ¾ 个英文单词;AI 中的 token 是什么有更深入的讲解。以下是 CheapTokens 上的三个模型及其窗口:
- GLM-5.3-Flash:390K tokens
- DeepSeek-V4-Flash:380K tokens
- MiniMax-M2.7:180K tokens
K 表示千。380K 的窗口大约相当于 285,000 个英文单词:380,000 × 0.75 = 285,000。这相当于一张书桌上放几本小说,而且它耗尽的速度比你想象的要快。
什么会计入其中#
请求中的所有内容都会计入,而不仅仅是你最后一条消息:
- 系统提示词(常驻指令);
- 每一条更早的消息,包括你的和模型的;
- 工具定义和工具结果,如果你使用 agent 或编辑器插件的话;
- 你附加的文档和图片;
- 答案本身,包括模型进行的任何思考。
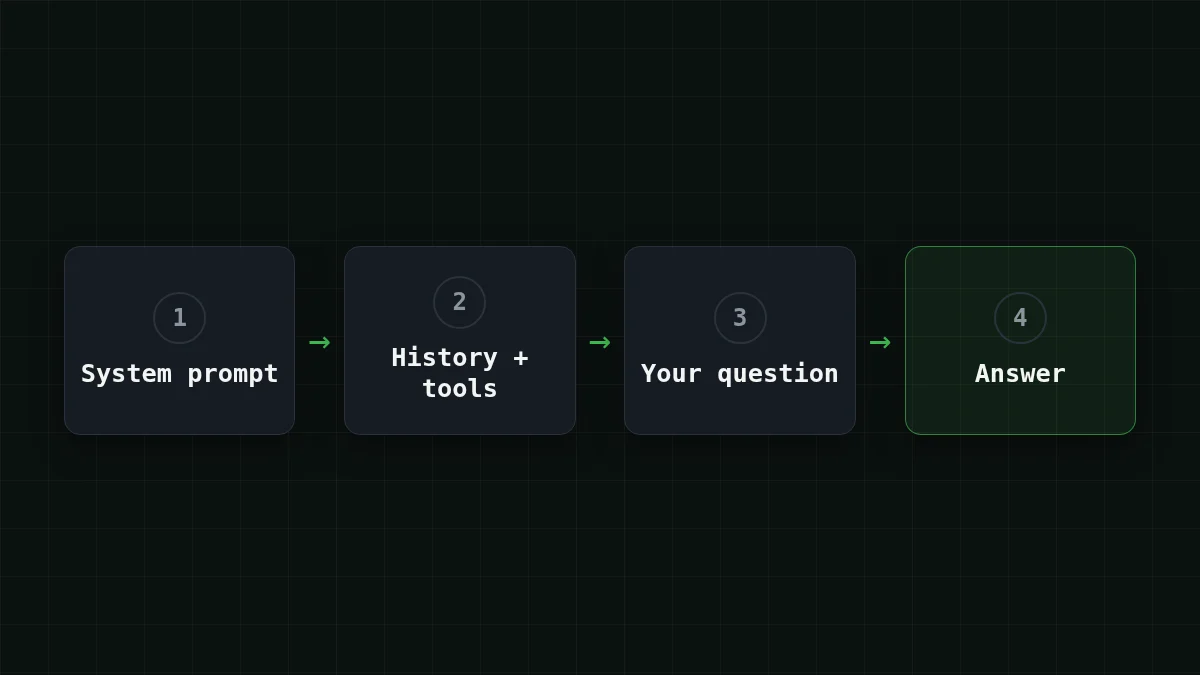
编辑器 agent 是那个隐蔽的情况。每一步它都会再次发送工具列表,加上它到目前为止读取的所有内容。你只输入了一句话;窗口看到的却多得多。
你不必猜测大小。每个响应都带有一个 usage 字段,其中包含 token 计数。这个最小聊天循环(OpenAI 兼容 API,模型 id 来自 CheapTokens 文档)同时展示了这两件事:每一轮都会发送完整历史记录,并且计数会返回。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
调用 ask() 十次,看着第一个数字攀升。这种攀升就是本文的全部故事。
窗口与最大输出:两个不同的数字#
每个模型页面都会列出两个大小,初学者常常把它们弄混。窗口是整张书桌,输入和输出加在一起。输出限制是一条答案可以有多长:DeepSeek-V4-Flash 最多 32,768 tokens,GLM-5.3-Flash 和 MiniMax-M2.7 最多 8,192。
它们共享同一空间。无论你的输入占用多少,答案都必须能放进剩余的部分。如果你想看看被截断的答案是什么样子,为什么 AI 答案会在句子中间停止对此进行了讲解。
快速检查
DeepSeek-V4-Flash 有 380K 的窗口和 32,768-token 的输出限制。你发送了 375K tokens 的输入。答案大约可以有多长?
显示答案
答案: 大约 5K tokens,即窗口中剩余的部分
窗口同时涵盖输入和输出:380K − 375K 剩下大约 5K,低于 32,768 的上限。
为什么长聊天会填满窗口(以及账单)#
模型不会记住你的上一条消息。为了让对话继续,API 每一轮都会再次接收完整的历史记录:之前的轮次被完整保留,模型的答案成为下一次输入的一部分。(聊天应用有时会悄悄丢弃最旧的消息;API 不会替你这样做。)
假设你与一个支持助手聊了 30 轮。假设系统提示词为 400 tokens,每个问题 150 tokens,每个答案 450 tokens,因此每次交流会给历史记录增加 600 tokens。
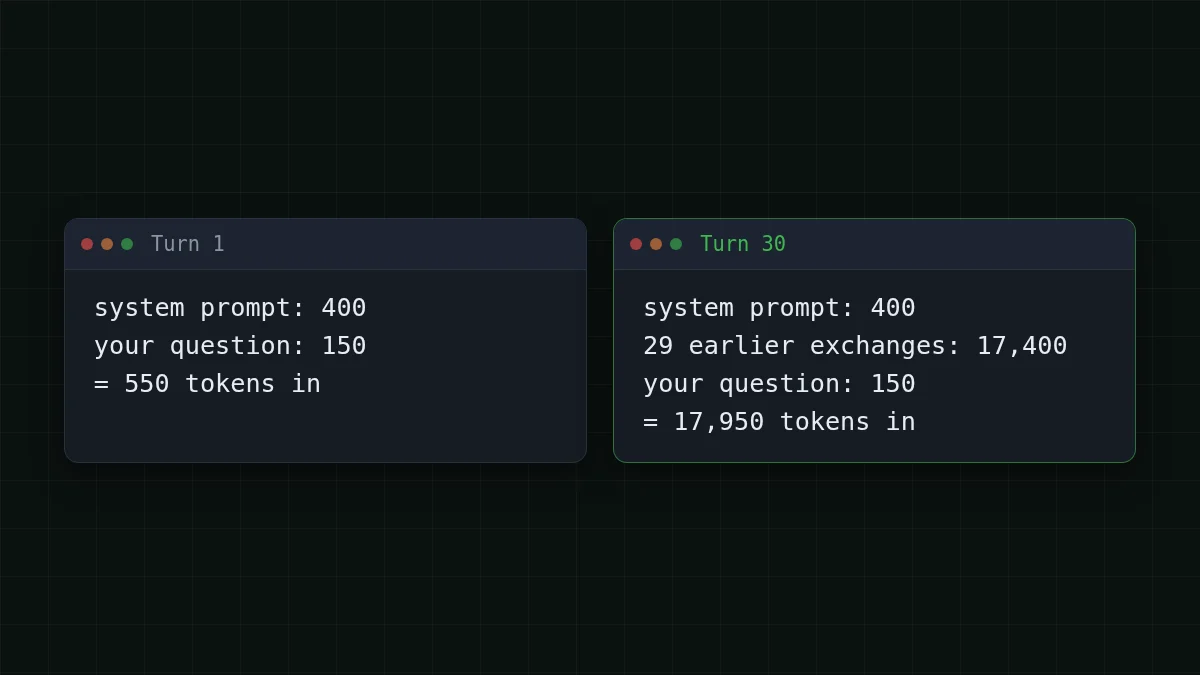
第 1 轮发送大约 550 tokens。第 30 轮发送 400 + 150 + 29 × 600 = 17,950。在整个聊天中累加起来,每一轮都带有其自身起点的 550 tokens,所以 30 × 550 = 16,500。在此之上,第 n 轮会重新发送 n − 1 次更早的交流,每次 600 tokens:600 × 435 = 261,000,其中 435 = 1 + 2 + … + 29。整个聊天的输入为 16,500 + 261,000 = 277,500 tokens,答案则增加 30 × 450 = 13,500。
在 DeepSeek-V4-Flash 上,整个聊天花费 $0.0055。以下是全部三个模型,旁边是 OpenRouter 参考价格;把输入和输出加在一起,对于这次聊天每一个都比 OpenRouter 便宜:
| 模型 | 输入 $/1M | 输出 $/1M | 费用 | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
总计 277,500 个输入 token 和 13,500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
平均下来,这次聊天每次请求输入 277,500 ÷ 30 = 9,250 tokens,输出 450。
想要你自己的聊天?修改下面的数字,例如改成 100 轮,看看总数增长得有多快。
成本计算器
同一个 30 轮聊天,取平均值
每次请求的输入 token 数: 9,250 · 每次请求的输出 token 数: 450 · 每日请求数: 30
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
现在说点实在的。17,950 tokens 不到 380K 窗口的 5%,所以普通聊天很少会撞到墙。增长的是账单和噪声。Anthropic 的文档指出,随着 token 数量增长,准确性和召回率会下降(它称之为上下文腐烂),所以更大的窗口并不自动更好:你放进去什么,和能装下多少同样重要。墙真正出现的地方是文档和 agent。在 Anthropic 自己的 API 上,仅输入就大于窗口的请求会收到 400 错误,提示 prompt 过长。关于同一效应在成本方面的情况,参见为什么长 AI 聊天花费更多。
我的文档能装下吗?#
对于英文文本,一个粗略的规则:一个 token 大约是 ¾ 个单词,所以 tokens ≈ 单词数 ÷ 0.75。其他语言通常每个单词需要更多 tokens,所以要留出额外余量。在继续阅读之前先试试。
猜数字
一本 90,000 词的书有多少 tokens?
你的猜测
0300,000
显示答案
答案: 120,000
大约 120,000:90,000 ÷ 0.75 = 120,000。它能装进三个窗口中的任何一个,还有富余。
现在看一个更大的情况。假设你有一个 150,000 词的支持邮件存档,想要一份摘要:150,000 ÷ 0.75 = 200,000 tokens。200,000 tokens 超过了 180K 的窗口,所以对于这个存档,选择 GLM-5.3-Flash(390K)或 DeepSeek-V4-Flash(380K)。DeepSeek-V4-Flash 在 DeepSeek-V4-Flash 上仍然留下 380,000 − 200,000 = 180,000 tokens 的空间,对于在其 32,768-token 答案限制内的摘要来说绰绰有余。读取这 200,000 tokens 并写出 2,000-token 的摘要花费 $0.0032。
一个更小的情况:一份 60,000 词的报告是 60,000 ÷ 0.75 = 80,000 tokens。MiniMax-M2.7 处理它还有 100K 的富余,这使其 180K 窗口足以应对聊天和中等大小的文档。
窗口快满时的三个习惯#
1. 总结并重新开始。 在第 30 轮,请求携带 17,950 tokens。让模型写一份到目前为止决策的 200-token 摘要,然后用它开始一个新聊天。下一次请求输入为 400 + 200 + 150 = 750 tokens,而模型仍然知道什么重要。
2. 只发送你需要的部分。 粘贴你正在询问的那一章,而不是整本书;粘贴那个函数,而不是整个仓库。桌面上东西更少意味着账单更小,而且根据 Anthropic 关于上下文腐烂的说明,模型也更不容易迷失。
3. 让固定部分保持精简,并留意 usage。 系统提示词、工具定义和冗长的工具结果会在每一步都随行。精简你不用的部分,像上面的循环那样在每次响应后打印 token 计数,并把 max_tokens 设置为你实际需要的长度。
当你想在真实模型上尝试时,CheapTokens 文档用几行展示了第一次请求,定价页面列出了每个模型的实时价格。对于长文档和 agent 循环,DeepSeek-V4-Flash(380K 上下文,最多 32,768 输出 tokens,固定价格,无高峰时段)和 GLM-5.3-Flash(390K,三者中最大的窗口)是首先应该考虑的。


