AI สำหรับผู้เริ่มต้นคู่มือ
context window ใน AI คืออะไร? อะไรเติมเต็มและควรทำอย่างไร
context window คือหน่วยความจำทำงานของโมเดลสำหรับหนึ่งคำขอ: prompt ของคุณ ประวัติแชท และคำตอบ ดูว่าอะไรเติมเต็ม วิธีประมาณ และสามนิสัย
ในหน้านี้
แชทของคุณทำงานได้ดีมาสักยี่สิบข้อความ และตอนนี้คำตอบก็เริ่มคลุมเครือ สิ่งหนึ่งที่เติบโตขึ้นทุกข้อความคือ context window ซึ่งเป็นหน่วยความจำทำงานของโมเดลสำหรับหนึ่งคำขอ มันเก็บทุกอย่างที่คุณส่งไปบวกกับคำตอบที่โมเดลเขียน และมีขนาดคงที่ เช่น 380K tokens สำหรับ DeepSeek-V4-Flash
context window คืออะไร#
ลองนึกถึงโต๊ะทำงาน โมเดลสามารถทำงานได้เฉพาะกับสิ่งที่อยู่บนโต๊ะในขณะนั้นเท่านั้น: คำสั่งของคุณ บทสนทนาที่ผ่านมา เอกสารที่วางไว้ และคำตอบที่กำลังเขียน สิ่งใดที่ไม่อยู่บนโต๊ะก็ไม่มีอยู่สำหรับมัน เอกสารของ Anthropic เกี่ยวกับ context window (ตรวจสอบเมื่อ 27 ตุลาคม 2026) อธิบายไว้เช่นเดียวกัน: window คือข้อความทั้งหมดที่โมเดลสามารถอ้างอิงได้เมื่อสร้างคำตอบ รวมถึงตัวคำตอบเอง และแยกจากข้อมูลที่โมเดลถูกฝึกมา
โต๊ะมีขนาดคงที่ นับเป็น tokens token คือชิ้นส่วนของข้อความ ประมาณ ¾ ของคำภาษาอังกฤษหนึ่งคำ; token ใน AI คืออะไร อธิบายลึกกว่า นี่คือสามโมเดลบน CheapTokens และ window ของ它们:
- GLM-5.3-Flash: 390K tokens
- DeepSeek-V4-Flash: 380K tokens
- MiniMax-M2.7: 180K tokens
K หมายถึงพัน window 380K ประมาณ 285,000 คำภาษาอังกฤษ: 380,000 × 0.75 = 285,000 นั่นคือนิยายหลายเล่มบนโต๊ะเดียว และมันยังหมดเร็วกว่าที่คุณคิด
อะไรที่นับรวมใน window#
ทุกอย่างในคำขอนับรวม ไม่ใช่แค่ข้อความล่าสุดของคุณ:
- system prompt (คำสั่งถาวร);
- ทุกข้อความก่อนหน้า ทั้งของคุณและของโมเดล;
- นิยามเครื่องมือและผลลัพธ์เครื่องมือ ถ้าคุณใช้ agent หรือปลั๊กอิน editor;
- เอกสารและรูปภาพที่คุณแนบ;
- ตัวคำตอบเอง รวมถึงการคิดใดๆ ที่โมเดลทำ
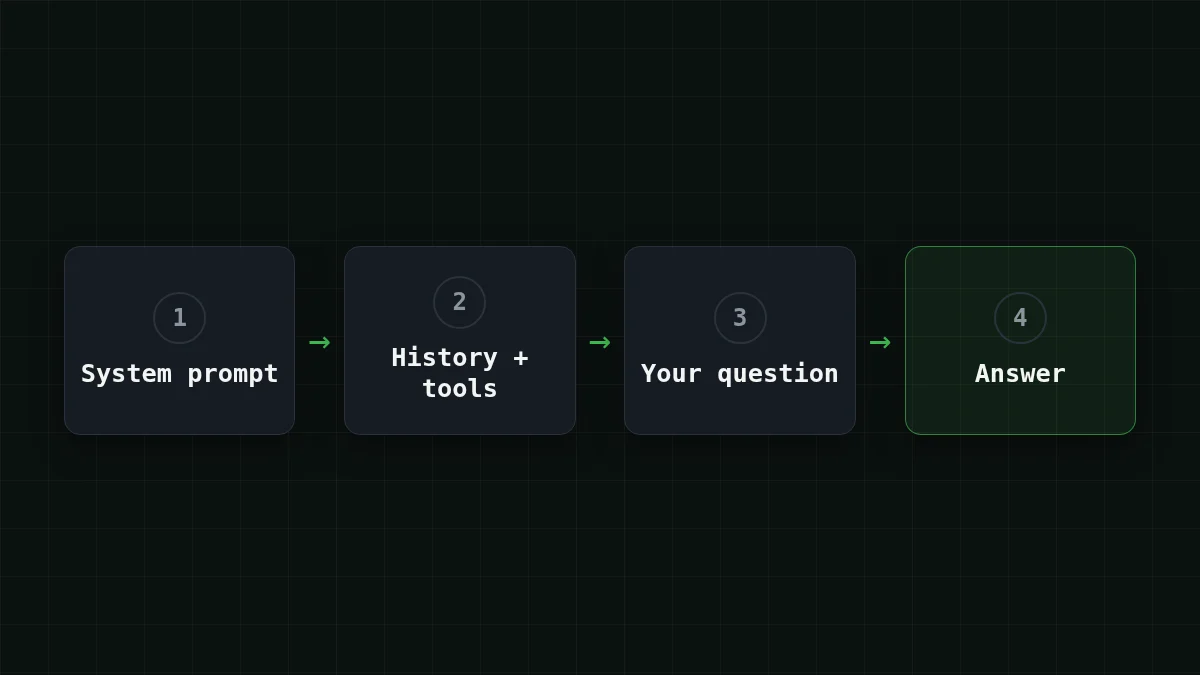
agent ใน editor คือกรณีที่แอบแฝง ในทุกขั้นตอนมันส่งรายการเครื่องมืออีกครั้งบวกกับทุกอย่างที่มันอ่านมาแล้ว คุณพิมพ์หนึ่งประโยค; window เห็นมากกว่านั้นมาก
คุณไม่จำเป็นต้องเดาขนาด ทุกคำตอบมีฟิลด์ usage พร้อมจำนวน token ลูปแชทแบบมินิมอลนี้ (API ที่เข้ากันได้กับ OpenAI, model id จากเอกสาร CheapTokens) แสดงทั้งสองอย่างพร้อมกัน: ประวัติทั้งหมดถูกส่งออกในทุกเทิร์น และจำนวน token กลับมา
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
เรียก ask() สิบครั้งและดูตัวเลขแรกไต่ขึ้น การไต่ขึ้นนั้นคือเรื่องราวทั้งหมดของบทความนี้
Window กับ max output: สองตัวเลขที่ต่างกัน#
ทุกหน้าโมเดลแสดงสองขนาด และผู้เริ่มต้นมักสับสน window คือโต๊ะทั้งหมด ทั้ง input และ output รวมกัน ขีดจำกัด output คือความยาวสูงสุดของหนึ่งคำตอบ: สูงสุด 32,768 tokens สำหรับ DeepSeek-V4-Flash สูงสุด 8,192 สำหรับ GLM-5.3-Flash และ MiniMax-M2.7
它们ใช้พื้นที่ร่วมกัน ไม่ว่า input ของคุณจะใช้ไปเท่าไร คำตอบก็ต้องพอดีกับส่วนที่เหลือ ถ้าคุณอยากเห็นว่าคำตอบที่ถูกตัดขาดเป็นอย่างไร ทำไมคำตอบ AI หยุดกลางประโยค อธิบายไว้
เช็กด่วน
DeepSeek-V4-Flash มี window 380K และขีดจำกัด output 32,768 tokens คุณส่ง input 375K tokens คำตอบจะยาวได้ประมาณเท่าไร?
แสดงคำตอบ
คำตอบ: ประมาณ 5K tokens เท่าที่เหลือใน window
window ครอบคลุม input และ output รวมกัน: 380K − 375K เหลือประมาณ 5K ซึ่งต่ำกว่าขีดจำกัด 32,768
ทำไมแชทยาวจึงเติมเต็ม window (และบิล)#
โมเดลไม่จำข้อความล่าสุดของคุณ เพื่อให้บทสนทนาดำเนินต่อไป API จะได้รับประวัติทั้งหมดอีกครั้งในทุกเทิร์น: เทิร์นก่อนหน้าถูกเก็บไว้ทั้งหมด และคำตอบของโมเดลกลายเป็นส่วนหนึ่งของ input ถัดไป (แอปแชทบางครั้งทิ้งข้อความเก่าสุดอย่างเงียบๆ; API ไม่ทำเช่นนั้นให้คุณ)
สมมติคุณแชทกับผู้ช่วยฝ่ายสนับสนุน 30 เทิร์น สมมติ system prompt 400 tokens คำถามละ 150 tokens และคำตอบละ 450 tokens ดังนั้นแต่ละการแลกเปลี่ยนเพิ่ม 600 tokens เข้าประวัติ
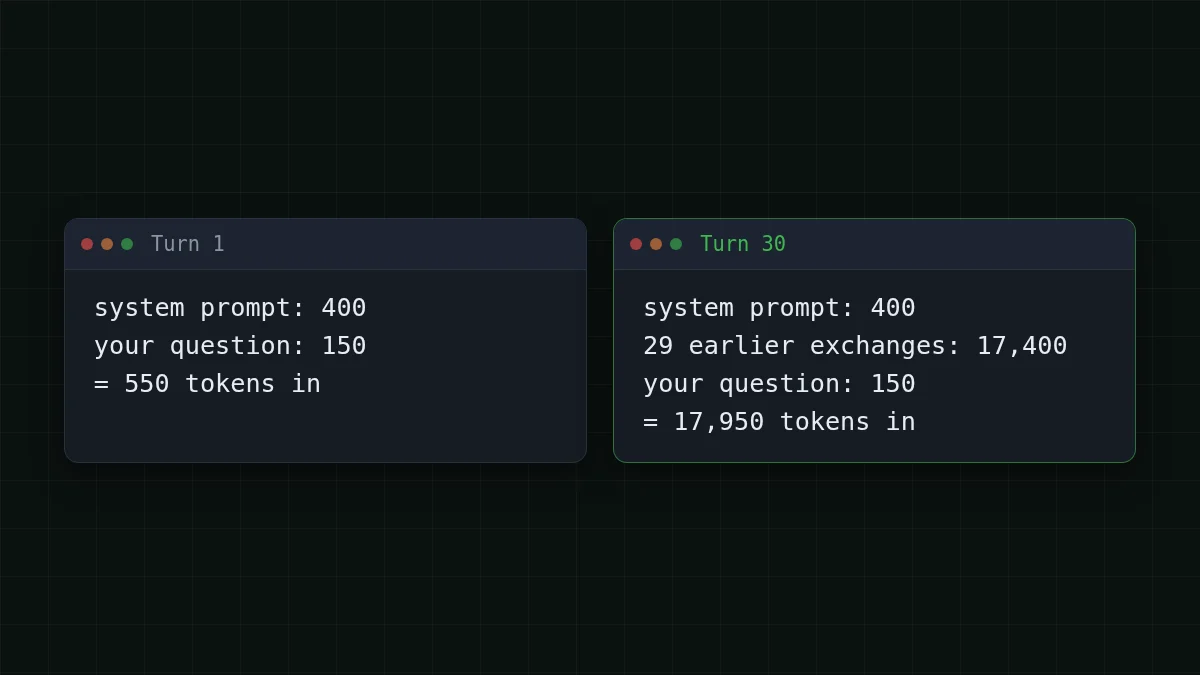
เทิร์น 1 ส่งประมาณ 550 tokens เทิร์น 30 ส่ง 400 + 150 + 29 × 600 = 17,950 เมื่อรวมตลอดแชท ทุกเทิร์นมี 550 tokens ของจุดเริ่มต้นของตัวเอง ดังนั้น 30 × 550 = 16,500 เหนือสิ่งนั้น เทิร์นที่ n ส่งการแลกเปลี่ยนก่อนหน้า n − 1 ครั้ง ครั้งละ 600 tokens ซ้ำ: 600 × 435 = 261,000 โดยที่ 435 = 1 + 2 + … + 29 input ของแชททั้งหมดคือ 16,500 + 261,000 = 277,500 tokens และคำตอบเพิ่ม 30 × 450 = 13,500
บน DeepSeek-V4-Flash แชททั้งหมดนั้นมีค่าใช้จ่าย $0.0055 นี่คือทั้งสามโมเดล โดยมีราคาอ้างอิงของ OpenRouter อยู่ข้างๆ; เมื่อนับ input และ output รวมกัน แต่ละตัวถูกกว่า OpenRouter สำหรับแชทนี้
| โมเดล | Input $/1M | Output $/1M | ค่าใช้จ่าย | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
277,500 โทเค็นอินพุตและ 13,500 โทเค็นเอาต์พุตรวมทั้งหมด ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
เฉลี่ยแล้ว แชทนั้นใช้ 277,500 ÷ 30 = 9,250 tokens ต่อคำขอเข้า และ 450 ออก
อยากลองแชทของคุณเอง? เปลี่ยนตัวเลขด้านล่าง เช่นเป็น 100 เทิร์น และดูว่ายอดรวมโตเร็วแค่ไหน
เครื่องคำนวณค่าใช้จ่าย
แชท 30 เทิร์นเดียวกัน เฉลี่ย
โทเค็นอินพุตต่อคำขอ: 9,250 · โทเค็นเอาต์พุตต่อคำขอ: 450 · คำขอต่อวัน: 30
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
ตอนนี้ส่วนที่ซื่อสัตย์ 17,950 tokens ต่ำกว่า 5% ของ window 380K ดังนั้นแชทธรรมดาแทบไม่ชนกำแพง สิ่งที่โตคือบิลและสัญญาณรบกวน เอกสารของ Anthropic ระบุว่าความแม่นยำและการเรียกคืนลดลงเมื่อจำนวน token โตขึ้น (เรียกว่า context rot) ดังนั้น window ที่ใหญ่กว่าไม่ได้ดีกว่าโดยอัตโนมัติ: สิ่งที่คุณใส่เข้าไปสำคัญพอๆ กับจำนวนที่พอดี กำแพงจะปรากฏในเอกสารและ agent บน API ของ Anthropic เอง คำขอที่มี input อย่างเดียวใหญ่กว่า window จะได้ error 400, prompt is too long สำหรับด้านค่าใช้จ่ายของผลเดียวกัน ดู ทำไมแชท AI ยาวจึงมีค่าใช้จ่ายสูงขึ้น
เอกสารของฉันจะพอดีไหม?#
กฎคร่าวๆ สำหรับข้อความภาษาอังกฤษ: หนึ่ง token ประมาณ ¾ ของคำ ดังนั้น tokens ≈ คำ ÷ 0.75 ภาษาอื่นมักใช้ token ต่อคำมากกว่า ดังนั้นเผื่อขอบเพิ่ม ลองทำก่อนอ่านต่อ
ทายตัวเลข
หนังสือ 90,000 คำมีกี่ tokens?
คำตอบของคุณ
0300,000
แสดงคำตอบ
คำตอบ: 120,000
ประมาณ 120,000: 90,000 ÷ 0.75 = 120,000 พอดีกับ window ทั้งสามแบบโดยเหลือที่ว่าง
ตอนนี้กรณีที่ใหญ่ขึ้น สมมติคุณมีคลังอีเมลสนับสนุน 150,000 คำและต้องการสรุป: 150,000 ÷ 0.75 = 200,000 tokens 200,000 tokens มากกว่า window 180K ดังนั้นสำหรับคลังนี้เลือก GLM-5.3-Flash (390K) หรือ DeepSeek-V4-Flash (380K) DeepSeek-V4-Flash ยังเหลือ 380,000 − 200,000 = 180,000 tokens ของที่ว่างบน DeepSeek-V4-Flash มากเกินพอสำหรับสรุปภายใต้ขีดจำกัดคำตอบ 32,768 tokens การอ่าน 200,000 tokens เหล่านั้นและเขียนสรุป 2,000 tokens มีค่าใช้จ่าย $0.0032
กรณีที่เล็กกว่า: รายงาน 60,000 คำคือ 60,000 ÷ 0.75 = 80,000 tokens MiniMax-M2.7 จัดการได้โดยเหลือ 100K ซึ่งทำให้ window 180K เพียงพอสำหรับแชทและเอกสารขนาดกลาง
สามนิสัยสำหรับ window ที่เกือบเต็ม#
1. สรุปและเริ่มใหม่. ในเทิร์น 30 คำขอมี 17,950 tokens ขอให้โมเดลเขียนสรุป 200 tokens ของการตัดสินใจที่ผ่านมา แล้วเริ่มแชทใหม่กับมัน คำขอถัดไปคือ 400 + 200 + 150 = 750 tokens เข้า และโมเดลยังรู้ว่าอะไรสำคัญ
2. ส่งเฉพาะส่วนที่คุณต้องการ. วางเฉพาะบทที่คุณถาม ไม่ใช่ทั้งเล่ม; ฟังก์ชัน ไม่ใช่ทั้ง repository น้อยลงบนโต๊ะหมายถึงบิลที่เล็กกว่า และตามบันทึก context-rot ของ Anthropic โมเดลที่มีสิ่งให้หลงน้อยลง
3. ทำให้ส่วนคงที่กระชับและเฝ้าดู usage. system prompt นิยามเครื่องมือ และผลลัพธ์เครื่องมือยาวๆ ติดไปในทุกขั้นตอน ตัดสิ่งที่ไม่ใช้ พิมพ์จำนวน token หลังทุกคำตอบดังในลูปด้านบน และตั้ง max_tokens เป็นความยาวที่คุณต้องการจริงๆ
เมื่อคุณอยากลองกับโมเดลจริง เอกสาร CheapTokens แสดงคำขอแรกในไม่กี่บรรทัด และ หน้าราคา แสดงราคาสดของแต่ละโมเดล สำหรับเอกสารยาวและลูป agent DeepSeek-V4-Flash (context 380K, output สูงสุด 32,768 tokens, ราคาคงที่เดียวไม่มีช่วง peak) และ GLM-5.3-Flash (390K, window ใหญ่สุดในสามตัว) คือตัวที่ควรดูก่อน


