O que é uma janela de contexto em IA? O que a preenche e o que fazer
A janela de contexto é a memória de trabalho de um modelo para uma requisição: seu prompt, o histórico do chat e a resposta. Veja o que a preenche, como estimá-la e três hábitos.
Nesta página
Seu chat funcionou bem por vinte mensagens, e agora as respostas ficam vagas. Uma coisa que cresce a cada mensagem é a janela de contexto: a memória de trabalho do modelo para uma requisição. Ela contém tudo o que você envia mais a resposta que o modelo escreve, e tem um tamanho fixo, por exemplo 380K tokens para o DeepSeek-V4-Flash.
O que é a janela de contexto#
Pense em uma mesa. O modelo só pode trabalhar com o que está na mesa agora: suas instruções, a conversa até aqui, um documento colado e a resposta que está escrevendo. Qualquer coisa que não esteja na mesa não existe para ele. A documentação da Anthropic sobre janelas de contexto (verificada em 27 de outubro de 2026) coloca da mesma forma: a janela é todo o texto que um modelo pode referenciar quando gera uma resposta, incluindo a própria resposta, e é separada dos dados com os quais o modelo foi treinado.
A mesa tem um tamanho fixo, contado em tokens. Um token é um pedaço de texto, aproximadamente ¾ de uma palavra em inglês; o que é um token em IA aprofunda mais. Aqui estão os três modelos no CheapTokens e suas janelas:
- GLM-5.3-Flash: 390K tokens
- DeepSeek-V4-Flash: 380K tokens
- MiniMax-M2.7: 180K tokens
K significa mil. Uma janela de 380K é cerca de 285.000 palavras em inglês: 380.000 × 0,75 = 285.000. Isso são alguns romances em uma mesa, e ainda assim acaba mais rápido do que você imagina.
O que conta para ela#
Tudo na requisição conta, não apenas sua última mensagem:
- o prompt de sistema (as instruções permanentes);
- cada mensagem anterior, suas e do modelo;
- definições de ferramentas e resultados de ferramentas, se você usa um agente ou plugin de editor;
- documentos e imagens que você anexa;
- a própria resposta, incluindo qualquer raciocínio que o modelo faça.
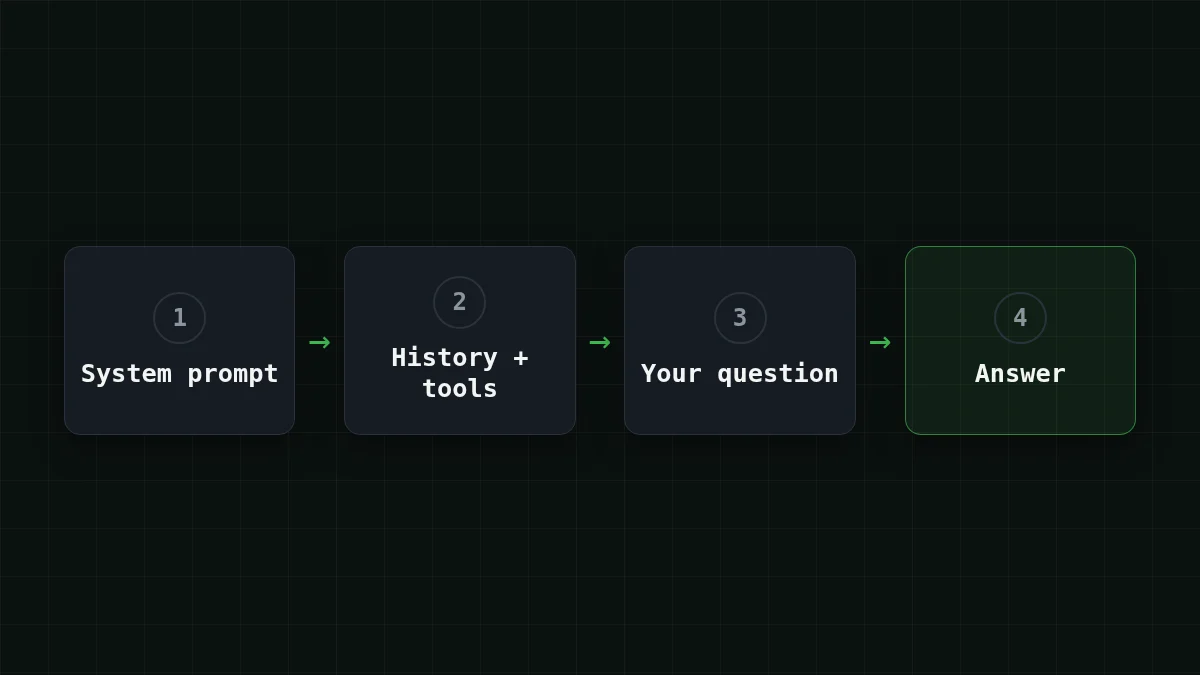
Um agente de editor é o caso sorrateiro. A cada passo ele envia a lista de ferramentas novamente mais tudo o que leu até agora. Você digitou uma frase; a janela vê muito mais.
Você não precisa adivinhar o tamanho. Cada resposta carrega um campo usage com as contagens de tokens. Este loop de chat mínimo (API compatível com OpenAI, id do modelo da documentação do CheapTokens) mostra as duas coisas ao mesmo tempo: todo o histórico sai a cada turno, e as contagens voltam.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
Chame ask() dez vezes e veja o primeiro número subir. Essa subida é toda a história deste artigo.
Janela vs. saída máxima: dois números diferentes#
Cada página de modelo lista dois tamanhos, e iniciantes frequentemente os confundem. A janela é a mesa inteira, entrada e saída juntas. O limite de saída é quanto pode ter uma resposta: até 32.768 tokens para o DeepSeek-V4-Flash, até 8.192 para o GLM-5.3-Flash e o MiniMax-M2.7.
Eles compartilham o mesmo espaço. O que sua entrada ocupar, a resposta tem que caber no que sobrar. Se você quer ver como é uma resposta cortada, por que uma resposta de IA para no meio da frase percorre isso.
Verificação rápida
O DeepSeek-V4-Flash tem uma janela de 380K e um limite de saída de 32.768 tokens. Você envia 375K tokens de entrada. Aproximadamente quanto pode ter a resposta?
Mostrar resposta
Resposta: Cerca de 5K tokens, o que sobrar na janela
A janela cobre entrada e saída juntas: 380K − 375K deixa cerca de 5K, que está abaixo do teto de 32.768.
Por que um chat longo enche a janela (e a conta)#
Um modelo não lembra da sua última mensagem. Para manter uma conversa, a API recebe todo o histórico novamente a cada turno: turnos anteriores são mantidos completamente, e a resposta do modelo se torna parte da próxima entrada. (Aplicativos de chat às vezes descartam as mensagens mais antigas silenciosamente; a API não faz isso por você.)
Digamos que você converse com um assistente de suporte por 30 turnos. Suponha um prompt de sistema de 400 tokens, 150 tokens por pergunta e 450 por resposta, então cada troca adiciona 600 tokens ao histórico.
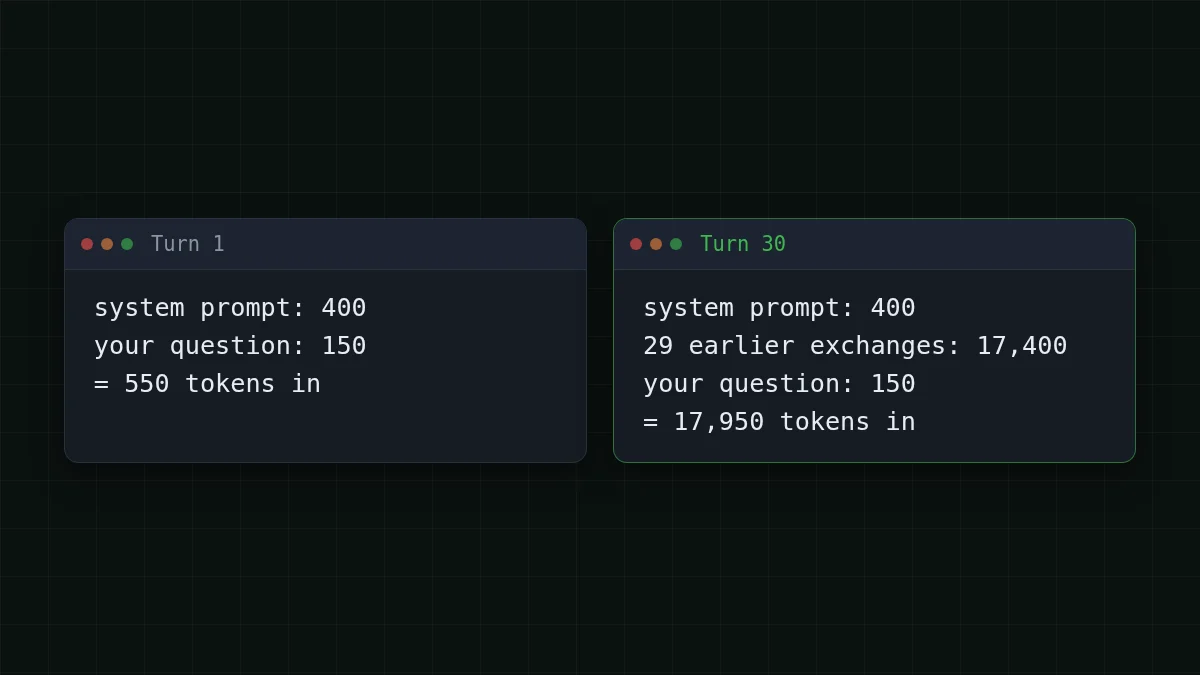
O turno 1 envia cerca de 550 tokens. O turno 30 envia 400 + 150 + 29 × 600 = 17.950. Somando ao longo de todo o chat, cada turno carrega os 550 tokens do seu próprio início, então 30 × 550 = 16.500. Além disso, o turno n reenvia n − 1 trocas anteriores de 600 tokens cada: 600 × 435 = 261.000, onde 435 = 1 + 2 + … + 29. A entrada do chat inteiro é 16.500 + 261.000 = 277.500 tokens, e as respostas adicionam 30 × 450 = 13.500.
No DeepSeek-V4-Flash esse chat inteiro custa $0.0055. Aqui estão os três modelos, com o preço de referência do OpenRouter ao lado deles; contando entrada e saída juntas, cada um é mais barato que o OpenRouter para este chat:
| Modelo | Entrada $/1M | Saída $/1M | Custo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
277.500 tokens de entrada e 13.500 tokens de saída no total. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Em média, esse chat é 277.500 ÷ 30 = 9.250 tokens de entrada por requisição e 450 de saída.
Quer o seu próprio chat? Mude os números abaixo, por exemplo para 100 turnos, e veja como o total cresce rápido.
Calculadora de custos
O mesmo chat de 30 turnos, em média
Tokens de entrada por solicitação: 9.250 · Tokens de saída por solicitação: 450 · Solicitações por dia: 30
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
Agora a parte honesta. 17.950 tokens está abaixo de 5% de uma janela de 380K, então um chat simples raramente bate no limite. O que cresce é a conta e o ruído. A documentação da Anthropic observa que a precisão e a recordação degradam conforme a contagem de tokens cresce (ela chama isso de apodrecimento de contexto), então uma janela maior não é automaticamente melhor: o que você coloca importa tanto quanto quanto cabe. Onde o limite aparece é em documentos e agentes. Na própria API da Anthropic, uma requisição cuja entrada sozinha é maior que a janela recebe um erro 400, prompt muito longo. Para o lado do custo do mesmo efeito, veja por que um chat de IA longo custa mais.
Meu documento vai caber?#
Uma regra aproximada para texto em inglês: um token é cerca de ¾ de uma palavra, então tokens ≈ palavras ÷ 0,75. Outros idiomas geralmente consomem mais tokens por palavra, então deixe margem extra. Tente antes de continuar lendo.
Adivinhar o número
Quantos tokens tem um livro de 90.000 palavras?
O seu palpite
0300.000
Mostrar resposta
Resposta: 120.000
Cerca de 120.000: 90.000 ÷ 0,75 = 120.000. Cabe em qualquer uma das três janelas com folga.
Agora um caso maior. Digamos que você tenha um arquivo de 150.000 palavras de e-mails de suporte e queira um resumo: 150.000 ÷ 0,75 = 200.000 tokens. 200.000 tokens é mais que uma janela de 180K, então para este arquivo escolha o GLM-5.3-Flash (390K) ou o DeepSeek-V4-Flash (380K). O DeepSeek-V4-Flash ainda deixa 380.000 − 200.000 = 180.000 tokens de espaço no DeepSeek-V4-Flash, mais que suficiente para um resumo abaixo do seu limite de resposta de 32.768 tokens. Ler esses 200.000 tokens e escrever um resumo de 2.000 tokens custa $0.0032.
Um caso menor: um relatório de 60.000 palavras é 60.000 ÷ 0,75 = 80.000 tokens. O MiniMax-M2.7 lida com isso com 100K de sobra, o que torna sua janela de 180K suficiente para chats e documentos de porte médio.
Três hábitos para uma janela quase cheia#
1. Resuma e reinicie. No turno 30 a requisição carrega 17.950 tokens. Peça ao modelo para escrever um resumo de 200 tokens das decisões até agora, então comece um chat novo com ele. A próxima requisição é 400 + 200 + 150 = 750 tokens de entrada, e o modelo ainda sabe o que importa.
2. Envie só a parte que você precisa. Cole o capítulo sobre o qual está perguntando, não o livro inteiro; a função, não o repositório inteiro. Menos na mesa significa uma conta menor e, seguindo a nota de apodrecimento de contexto da Anthropic, um modelo com menos coisas para se perder.
3. Mantenha as partes fixas enxutas e observe usage. O prompt de sistema, as definições de ferramentas e resultados longos de ferramentas acompanham cada passo. Corte o que você não usa, imprima as contagens de tokens após cada resposta como no loop acima, e defina max_tokens para o comprimento que você realmente precisa.
Quando quiser testar isso em um modelo real, a documentação do CheapTokens mostra a primeira requisição em poucas linhas, e a página de preços lista o preço ao vivo de cada modelo. Para documentos longos e loops de agentes, o DeepSeek-V4-Flash (contexto de 380K, até 32.768 tokens de saída, um preço fixo sem horários de pico) e o GLM-5.3-Flash (390K, a maior janela dos três) são os que você deve olhar primeiro.


