Requisição longa demais: 400 vs 413, janela de contexto e max_tokens
Distinga um 413 (bytes demais) de um erro de comprimento em tokens (geralmente um 400), confira entrada mais max_tokens contra a janela de contexto e encolha a requisição.
Nesta página
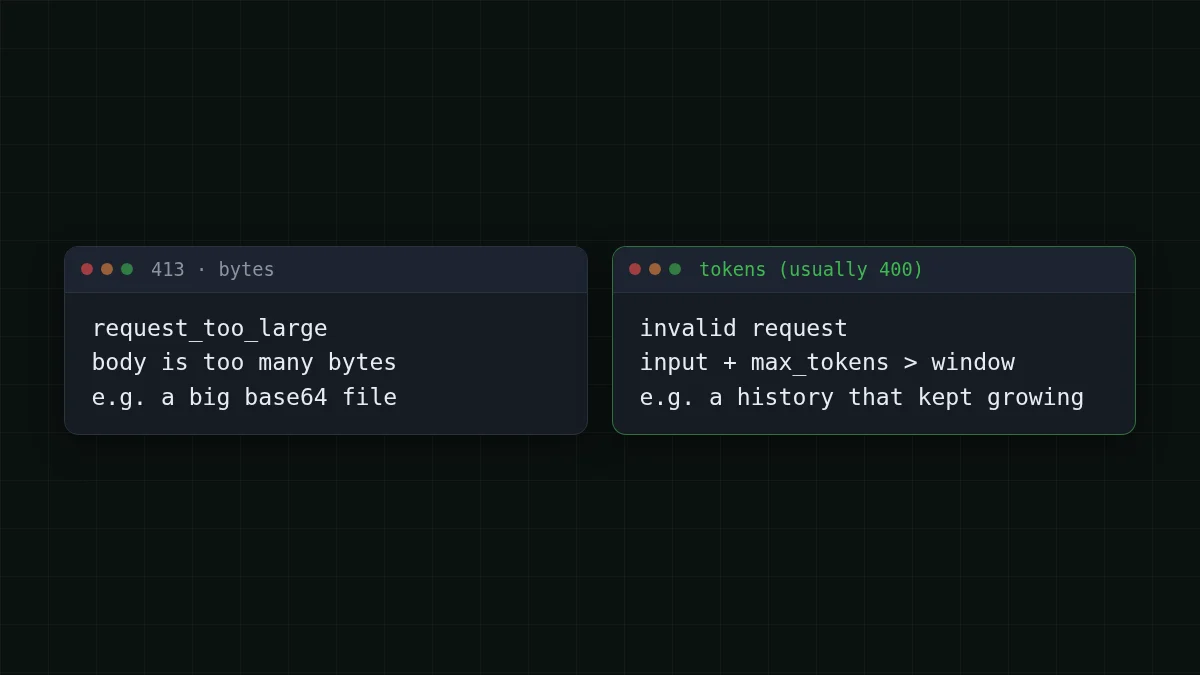
Seu chat funcionou bem por quarenta turnos, e então todas as requisições começaram a falhar. A resposta curta: "request too long" esconde dois limites diferentes. Um 413 significa que a requisição é grande demais em bytes e foi recusada antes de qualquer modelo vê-la. Se o erro reclama do comprimento em tokens (geralmente uma requisição inválida da classe 400), sua entrada mais a resposta que você pede não cabem na janela de contexto; leia error.message para ver qual é o caso. A solução é medir e depois cortar.
Este guia mostra como distinguir os dois, como conferir a conta antes de enviar e quatro formas de encolher uma requisição. Se o termo é novo, o que é uma janela de contexto explica em palavras simples.
Dois limites, dois erros#
Um 413 é o correio recusando um pacote grande demais; um erro de tokens é o modelo dizendo que a carta não cabe na sua janela de leitura. Eles falham em lugares diferentes e precisam de correções diferentes.
A página de erros da API da Anthropic (consultada em 29 de outubro de 2026) descreve 413 request_ como uma requisição que excede o número máximo de bytes: 128 MB para a Messages API, 256 MB para a Batch API, 500 MB para a Files API. Um 400 invalid_ cobre problemas com o formato ou o conteúdo da requisição. Esses são os limites da Anthropic. A página deles não lista uma mensagem de contagem de tokens, e o guia de códigos de erro da OpenAI também não, então não construa lógica com base no texto exato que você viu em um tópico de fórum.
Na prática, chats só de texto costumam crescer em tokens muito antes de crescer em bytes. Bytes viram problema quando você anexa imagens em base64 ou documentos inteiros. Tokens viram problema quando o histórico cresce, e esse é o caso comum.
Emparelhar os pares
Relacione cada sintoma à sua causa
Toque num item à esquerda, depois no seu par
- 413 request_too_largeO corpo tem bytes demais, por exemplo um anexo base64 grande
- Um erro de comprimento em tokens logo após colar um log enormeO prompt sozinho tem mais tokens que a janela de contexto
- 400 após um prompt de cerca de 375K tokens com max_tokens=32768 em um modelo de 380KJuntos eles podem exceder a janela
- Mesmo histórico, modelo diferenteConfira a janela de cada modelo: um histórico que cabe em um pode não caber em outro
O corpo do erro é JSON com um type: error de nível superior, um objeto error com seu próprio type e message, e um id de requisição. Leia error.message e guarde o id da requisição; com os SDKs oficiais, capture a exceção tipada em vez de comparar strings.
Confira a conta antes de enviar#
O hábito que economiza mais tempo: não espere o erro. Antes de cada chamada, some três coisas e compare com a janela.
- Tokens nas suas mensagens (prompt de sistema, histórico, a nova pergunta).
- O
max_tokensque você está pedindo. - A janela de contexto do modelo.
Mantenha a entrada mais a resposta pedida dentro da janela. As janelas na CheapTokens são 390K para GLM-5.3-Flash, 380K para DeepSeek-V4-Flash e 180K para MiniMax-M2.7; as respostas vão até 8.192 tokens no GLM e no MiniMax e até 32.768 no DeepSeek-V4-Flash. Confira as páginas de preços e de modelos para a lista atual.
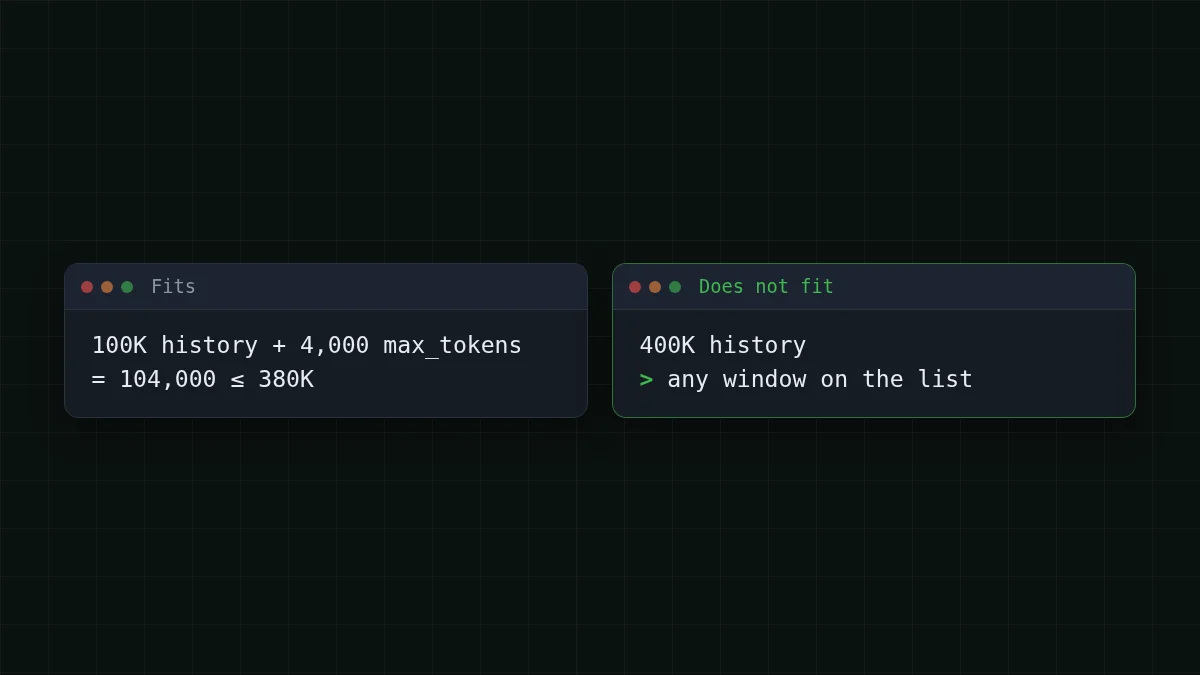
Digamos que seu agente envie um histórico de 100K tokens e peça 4.000 tokens de volta. Isso dá 100.000 + 4.000 = 104.000 tokens, confortável em qualquer uma das três. Agora o mesmo agente depois de mais cinquenta passos: 400K. Nenhuma janela da lista comporta isso, qualquer que seja o max_tokens que você defina. Esse é o momento em que o erro aparece, e ele parece súbito só porque o histórico cresceu um pouco a cada turno.
Um contador aproximado basta para uma proteção. Texto em inglês tem em média cerca de 4 caracteres por token; código e texto em outros idiomas usam mais tokens por caractere, então deixe uma margem:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
A última linha é sua calibração: usage. é o que a API realmente contou. Compare com rough_ algumas vezes e ajuste o divisor e a margem ao seu próprio texto.
Quatro formas de encolher uma requisição#
Escolha a correção mais barata que funciona, nesta ordem.
1. Reduza max_tokens. Peça apenas a resposta de que você precisa: entrada mais max_tokens é o que você tem que manter dentro da janela, e cada modelo tem seu próprio teto para a resposta (8.192 ou 32.768 tokens acima). Não defina max_tokens acima do que a resposta precisa, nem acima do teto de respostas do modelo. Se a resposta para no limite que você definiu, ela termina com finish_, que tem sua própria correção.
2. Corte o histórico. Descarte os turnos mais antigos, mantenha o prompt de sistema e as últimas trocas. A função trim acima faz exatamente isso. Para um agente, corte também o volume: saídas de ferramentas com 5.000 linhas raramente precisam ficar inteiras depois que o agente as usou.
3. Resuma em vez de descartar. Quando turnos antigos importam, peça ao modelo uma vez para comprimi-los em uma nota curta e depois substitua as mensagens antigas por essa nota. Você paga por uma chamada extra e mantém a conversa.
4. Troque para uma janela maior. Passar de MiniMax-M2.7 (180K) para GLM-5.3-Flash (390K) ou DeepSeek-V4-Flash (380K) é uma mudança de uma linha no id do modelo. Se você também precisa de respostas longas, o DeepSeek-V4-Flash permite até 32.768 tokens de saída, e os três compartilham um único saldo, então trocar não custa nada na configuração.
Lista de verificação
Antes de reenviar uma requisição que falhou
Quanto custa um histórico longo#
Cortar não é só questão de erros. Cada passo de um agente reenvia o histórico inteiro, então um histórico inflado também é a parte cara da conta. Pegue uma tarefa de 30 passos em que cada passo envia cerca de 100K tokens e recebe cerca de 1.500 de volta:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 30 solicitações | OpenRouter, 30 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100.000 tokens de entrada e 1.500 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
A tabela precifica essa mesma tarefa em cada modelo com tarifas ao vivo. Corte o histórico para um quarto e o lado da entrada cai cerca de três quartos. Para ver onde seu próprio agente gasta tokens, acompanhe o uso por requisição em Python; para os detalhes, por que agentes usam tantos tokens percorre um exemplo de 20 passos.
O DeepSeek-V4-Flash custa atualmente $0.015 por 1M tokens de entrada e $0.10 por 1M tokens de saída, um preço a qualquer hora. Experimente seus próprios números:
Calculadora de custos
Uma tarefa de agente de 30 passos com histórico de 100K
Tokens de entrada por solicitação: 100.000 · Tokens de saída por solicitação: 1.500 · Solicitações por dia: 30
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
Se ainda falhar#
Requisições longas em um link lento têm uma falha separada: a Anthropic recomenda streaming ou a Batch API para requisições longas com um max_tokens grande, porque as redes podem derrubar conexões ociosas, e seus SDKs esperam que requisições sem streaming terminem em até 10 minutos. Se o erro for um timeout ou uma conexão derrubada em vez de um 400, veja erros de conexão e defina stream=True.
Se a mensagem for 401 ou 404, o problema é a chave, a URL base ou o id do modelo: erro 401 ou 404 da API. Para a URL base exata, os ids de modelo e exemplos, abra a documentação da CheapTokens.


