Pag-troubleshootGabay
Masyadong mahaba ang kahilingan: 400 vs 413, context window at max_tokens
Makilala ang 413 (masyadong maraming bytes) mula sa token-length error (karaniwang 400), suriin ang input kasama ang max_tokens laban sa context window, at paliitin ang kahilingan.
Sa pahinang ito
Maayos na tumakbo ang iyong chat sa loob ng apatnapung turn, pagkatapos ay nagsimulang mabigo ang bawat kahilingan. Ang maikling sagot: ang "request too long" ay nagtatago ng dalawang magkaibang limitasyon. Ang 413 ay nangangahulugang masyadong malaki ang kahilingan sa bytes at tinanggihan bago pa man ito makita ng anumang modelo. Kung ang error ay nagrereklamo tungkol sa haba sa tokens (karaniwang 400-class invalid request), ang iyong input kasama ang sagot na hinihiling mo ay hindi kasya sa context window; basahin ang error.message upang makita kung alin. Ang solusyon ay sukatin, pagkatapos bawasan.
Ipinapakita ng gabay na ito kung paano makilala ang dalawa, kung paano suriin ang matematika bago ka magpadala, at apat na paraan upang paliitin ang isang kahilingan. Kung bago ang termino, ano ang context window ay sumasaklaw nito sa simpleng salita.
Dalawang limitasyon, dalawang error#
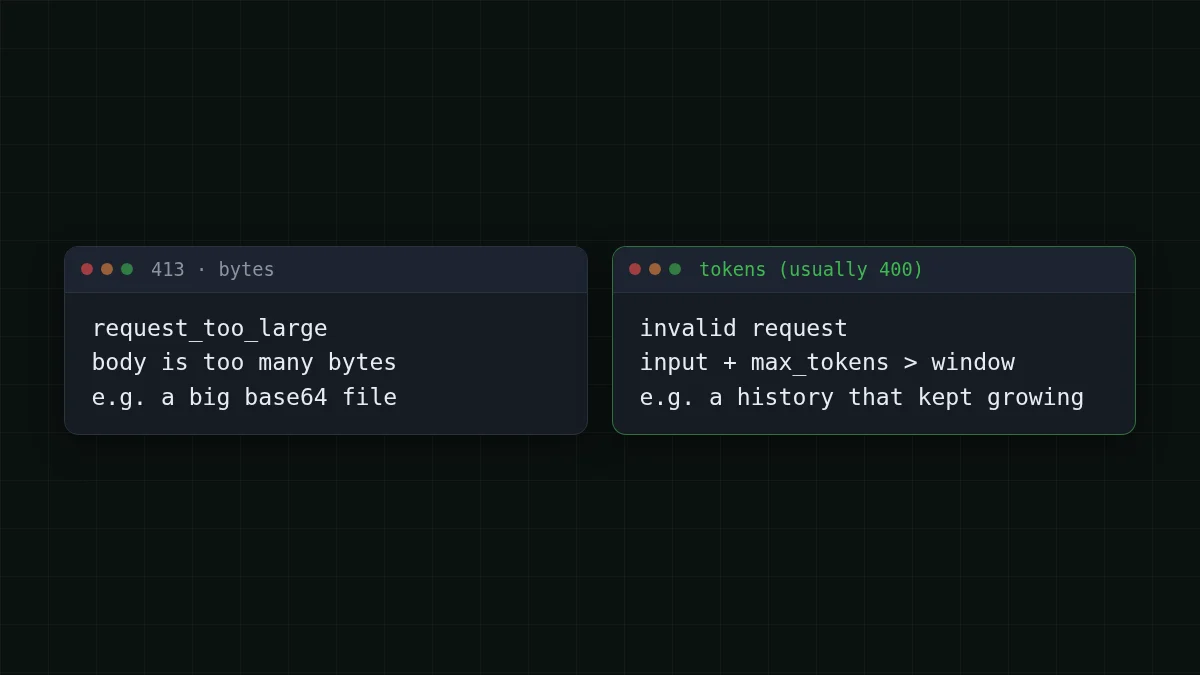
Ang 413 ay ang post office na tumatanggi sa isang parcel na masyadong malaki; ang token error ay ang modelo na nagsasabing hindi kasya ang sulat sa reading window nito. Nabigo sila sa magkaibang lugar at nangangailangan ng magkaibang solusyon.
Inilalarawan ng API errors page ng Anthropic (sinuri noong 29 Oktubre 2026) ang 413 request_ bilang isang kahilingan na lumalampas sa maximum na bilang ng bytes: 128 MB para sa Messages API, 256 MB para sa Batch API, 500 MB para sa Files API. Ang 400 invalid_ ay sumasaklaw sa mga problema sa format o nilalaman ng kahilingan. Iyon ang mga limitasyon ng Anthropic. Hindi naglilista ang kanilang page ng token-count message, at gayundin ang error-codes guide ng OpenAI, kaya huwag bumuo ng logic batay sa eksaktong salita na nakita mo sa isang forum thread.
Sa pagsasagawa, ang text-only na mga chat ay karaniwang lumalaki sa tokens bago pa sa bytes. Nagiging problema ang bytes kapag nag-attach ka ng base64 na mga larawan o buong dokumento. Nagiging problema ang tokens kapag lumalaki ang history, at iyon ang karaniwang kaso.
Itugma ang mga pares
Itugma ang bawat sintomas sa sanhi nito
I-tap ang isang item sa kaliwa, pagkatapos ang pares nito
- 413 request_too_largeMasyadong maraming bytes ang body, halimbawa isang malaking base64 attachment
- Isang token-length error pagkatapos i-paste ang isang malaking logAng prompt lamang ay mas maraming tokens kaysa sa context window
- 400 pagkatapos ng prompt na humigit-kumulang 375K tokens na may max_tokens=32768 sa isang 380K na modeloKapag pinagsama, maaaring lumampas sila sa window
- Parehong history, ibang modeloSuriin ang window ng bawat modelo: ang history na kasya sa isa ay maaaring hindi kasya sa iba
Ang error body ay JSON na may top-level na type: error, isang error object na may sariling type at message, at isang request id. Basahin ang error.message at itago ang request id; sa mga opisyal na SDK, hulihin ang typed exception sa halip na magtugma ng mga string.
Suriin ang matematika bago ka magpadala#
Ang ugali na pinakamalaking nakakatipid ng oras: huwag hintayin ang error. Bago ang bawat tawag, pagsamahin ang tatlong bagay at ihambing ang mga ito sa window.
- Mga token sa iyong mga mensahe (system prompt, history, ang bagong tanong).
- Ang
max_tokensna hinihiling mo. - Ang context window ng modelo.
Panatilihin ang input kasama ang hinihiling na sagot sa loob ng window. Ang mga window sa CheapTokens ay 390K para sa GLM-5.3-Flash, 380K para sa DeepSeek-V4-Flash at 180K para sa MiniMax-M2.7; ang mga sagot ay umaabot hanggang 8,192 tokens sa GLM at MiniMax at hanggang 32,768 sa DeepSeek-V4-Flash. Tingnan ang pricing at mga pahina ng modelo para sa kasalukuyang listahan.
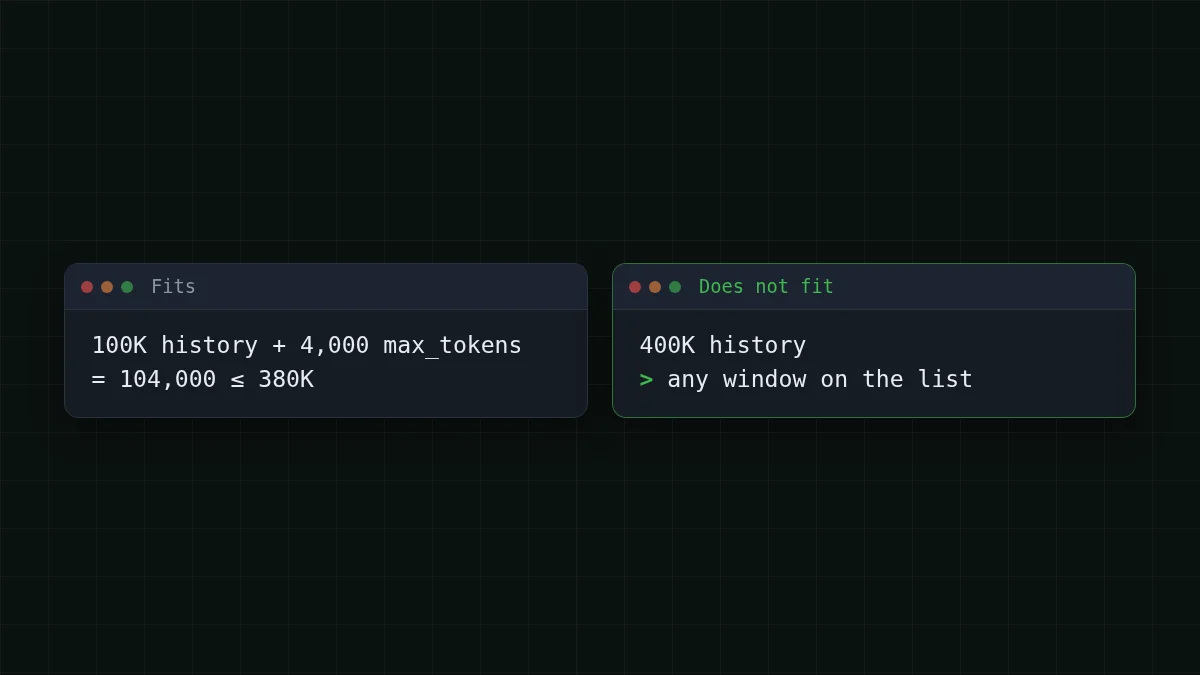
Sabihin nating ang iyong agent ay nagpapadala ng 100K-token na history at humihingi ng 4,000 tokens pabalik. Iyon ay 100,000 + 4,000 = 104,000 tokens, komportable sa alinman sa tatlo. Ngayon ang parehong agent pagkatapos ng isa pang limampung hakbang: 400K. Walang window sa listahan ang tumatanggap nito, anuman ang max_tokens na itakda mo. Iyon ang sandali na lumilitaw ang error, at mukhang biglaan lamang dahil lumaki nang kaunti ang history sa bawat turn.
Ang isang magaspang na counter ay sapat para sa isang guard. Ang English text ay may average na mga 4 na character bawat token; ang code at non-English na text ay gumagamit ng mas maraming tokens bawat character, kaya mag-iwan ng margin:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
Ang huling linya ay ang iyong calibration: ang usage. ay kung ano ang aktwal na binilang ng API. Ihambing ito sa rough_ ng ilang beses at i-adjust ang divisor at margin sa iyong sariling text.
Apat na paraan upang paliitin ang isang kahilingan#
Piliin ang pinakamurang solusyon na gumagana, sa ganitong pagkakasunod-sunod.
1. Bawasan ang max_tokens. Humingi lamang ng sagot na kailangan mo: input kasama ang max_tokens ang kailangan mong panatilihin sa loob ng window, at ang bawat modelo ay may sariling cap sa sagot (8,192 o 32,768 tokens sa itaas). Huwag itakda ang max_tokens nang mas mataas kaysa sa kailangan ng sagot, at hindi lalampas sa cap ng modelo sa mga sagot. Kung ang sagot ay huminto sa limitasyong itinakda mo, nagtatapos ito sa finish_, na may sariling solusyon.
2. Bawasan ang history. I-drop ang pinakalumang mga turn, panatilihin ang system prompt at ang huling ilang palitan. Ang trim function sa itaas ay eksaktong ginagawa ito. Para sa isang agent, putulin din ang bulk: ang mga tool output na 5,000 linya ay bihirang kailangang manatiling buo pagkatapos gamitin ng agent ang mga ito.
3. I-summarize sa halip na i-drop. Kapag mahalaga ang mga lumang turn, hilingin sa modelo nang isang beses na i-compress ang mga ito sa isang maikling tala, pagkatapos palitan ang mga lumang mensahe ng talang iyon. Magbabayad ka para sa isang karagdagang tawag at mapanatili ang thread.
4. Lumipat sa mas malaking window. Ang paglipat mula sa MiniMax-M2.7 (180K) patungo sa GLM-5.3-Flash (390K) o DeepSeek-V4-Flash (380K) ay isang linyang pagbabago ng model id. Kung kailangan mo rin ng mahahabang sagot, pinapayagan ng DeepSeek-V4-Flash ang hanggang 32,768 output tokens, at ang tatlo ay may isang balanse, kaya walang gastos sa setup ang paglipat.
Listahan ng dapat gawin
Bago mo muling ipadala ang isang nabigong kahilingan
Ano ang gastos ng mahabang history#
Ang pagbabawas ay hindi lamang tungkol sa mga error. Ang bawat hakbang ng isang agent ay muling nagpapadala ng buong history, kaya ang isang bloated na history ay ang mamahaling bahagi rin ng bill. Kunin ang isang gawain na 30 hakbang kung saan ang bawat hakbang ay nagpapadala ng mga 100K tokens at nakakakuha ng mga 1,500 pabalik:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 30 mga kahilingan | OpenRouter, 30 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100,000 input at 1,500 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Ang table ay nagpepresyo ng parehong gawain sa bawat modelo gamit ang live na mga rate. Bawasan ang history sa isang-kapat at ang input side ay bababa ng mga tatlong-kapat. Upang makita kung saan gumagastos ng tokens ang iyong sariling agent, subaybayan ang paggamit bawat kahilingan sa Python; para sa mekanika, bakit gumagamit ng napakaraming tokens ang mga agent ay dumadaan sa isang 20-hakbang na halimbawa.
Ang DeepSeek-V4-Flash ay kasalukuyang nagkakahalaga ng $0.015 bawat 1M input tokens at $0.10 bawat 1M output tokens, isang presyo sa anumang oras. Subukan ang iyong sariling mga numero:
Calculator ng gastos
Isang 30-hakbang na gawain ng agent na may 100K history
Mga input token bawat kahilingan: 100,000 · Mga output token bawat kahilingan: 1,500 · Mga kahilingan bawat araw: 30
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
Kung nabigo pa rin#
Ang mahahabang kahilingan sa mabagal na link ay may hiwalay na kabiguan: pinapayo ng Anthropic ang streaming o ang Batch API para sa mahahabang kahilingan na may malaking max_tokens, dahil maaaring i-drop ng mga network ang mga idle connection, at inaasahan ng kanilang mga SDK na matapos ang non-streaming na mga kahilingan sa loob ng 10 minuto. Kung ang error ay timeout o dropped connection sa halip na 400, tingnan ang connection errors at itakda ang stream=True.
Kung ang mensahe ay 401 o 404, ang problema ay ang key, base URL o model id sa halip: API 401 o 404 error. Para sa eksaktong base URL, model ids at mga halimbawa, buksan ang CheapTokens docs.


