故障排查指南
请求过长:400 与 413、上下文窗口和 max_tokens
区分 413(字节太多)和 token 长度错误(通常是 400),检查输入加 max_tokens 是否在上下文窗口内,并缩小请求。
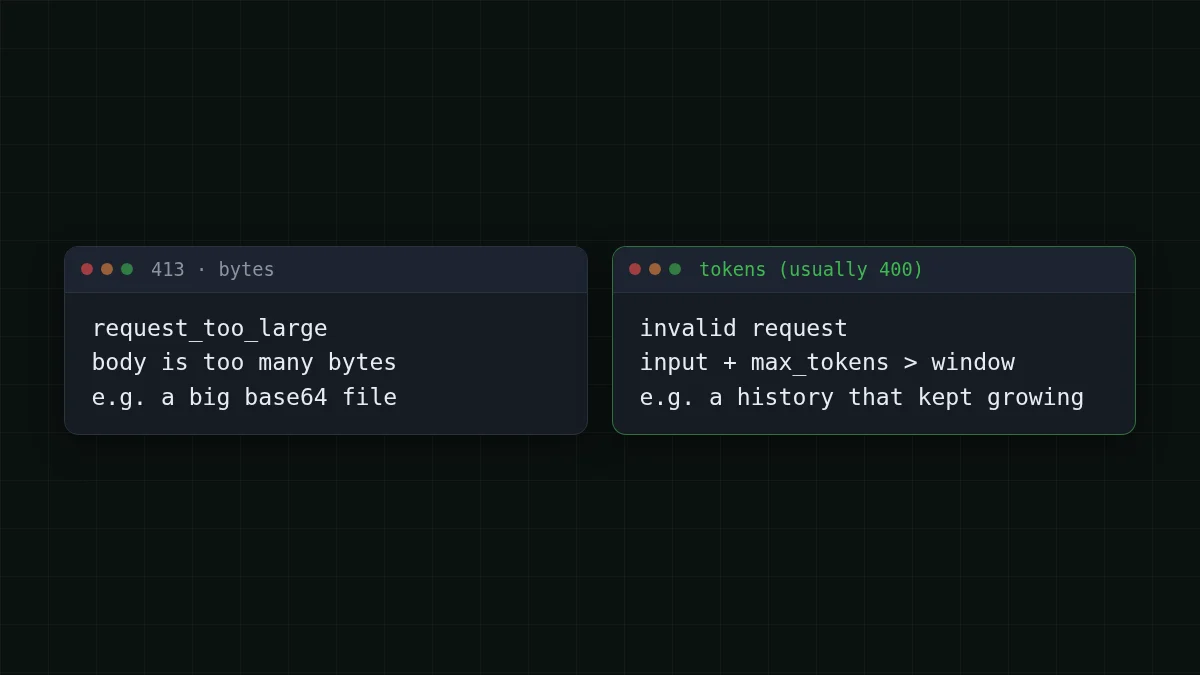
你的聊天顺利运行了四十轮,然后每个请求都开始失败。简短的回答是:"request too long" 隐藏了两个不同的限制。413 表示请求在字节上太大,在任何模型看到它之前就被拒绝了。如果错误抱怨的是 token 长度(通常是 400 类无效请求),那么你的输入加上你要求的回答无法放入上下文窗口;阅读 error.message 看看是哪一个。解决办法是测量,然后裁剪。
本指南展示如何区分两者、如何在发送前检查数学计算,以及四种缩小请求的方法。如果这个术语是新的,什么是上下文窗口用通俗的语言解释了它。
两个限制,两种错误#
413 是邮局拒绝一个太大的包裹;token 错误是模型说这封信放不进它的阅读窗口。它们在不同的地方失败,需要不同的修复。
Anthropic 的 API 错误页面(2026 年 10 月 29 日检查)将 413 request_ 描述为超过最大字节数的请求:Messages API 为 128 MB,Batch API 为 256 MB,Files API 为 500 MB。400 invalid_ 涵盖请求格式或内容的问题。这些是 Anthropic 的限制。他们的页面没有列出 token 计数消息,OpenAI 的错误代码指南也没有,所以不要基于你在论坛帖子中看到的确切措辞来构建逻辑。
在实践中,纯文本聊天通常在字节之前很久就在 token 上增长。当你附加 base64 图像或整个文档时,字节成为问题。当历史增长时,token 成为问题,而这是常见情况。
配对
将每个症状与其原因匹配
点击左侧项目,然后点击其配对项
- 413 request_too_large正文的字节数太多,例如一个大的 base64 附件
- 粘贴巨大日志后立即出现 token 长度错误仅提示词本身就比上下文窗口的 token 多
- 在 380K 模型上使用 max_tokens=32768 的约 375K token 提示词后出现 400它们加在一起可能超过窗口
- 相同历史,不同模型检查每个模型的窗口:适合一个的历史可能不适合另一个
错误正文是 JSON,带有顶层 type: error、一个带有自己的 type 和 message 的 error 对象,以及一个请求 id。阅读 error.message 并保留请求 id;使用官方 SDK 时,捕获类型化异常而不是匹配字符串。
发送前检查数学计算#
最能节省时间的习惯:不要等待错误。在每次调用之前,将三件事相加并与窗口比较。
- 你的消息中的 token(系统提示词、历史、新问题)。
- 你要求的
max_tokens。 - 模型的上下文窗口。
保持输入加上请求的回答在窗口内。CheapTokens 上的窗口为 GLM-5.3-Flash 的 390K、DeepSeek-V4-Flash 的 380K 和 MiniMax-M2.7 的 180K;回答在 GLM 和 MiniMax 上最高 8,192 token,在 DeepSeek-V4-Flash 上最高 32,768。查看定价和模型页面获取当前列表。
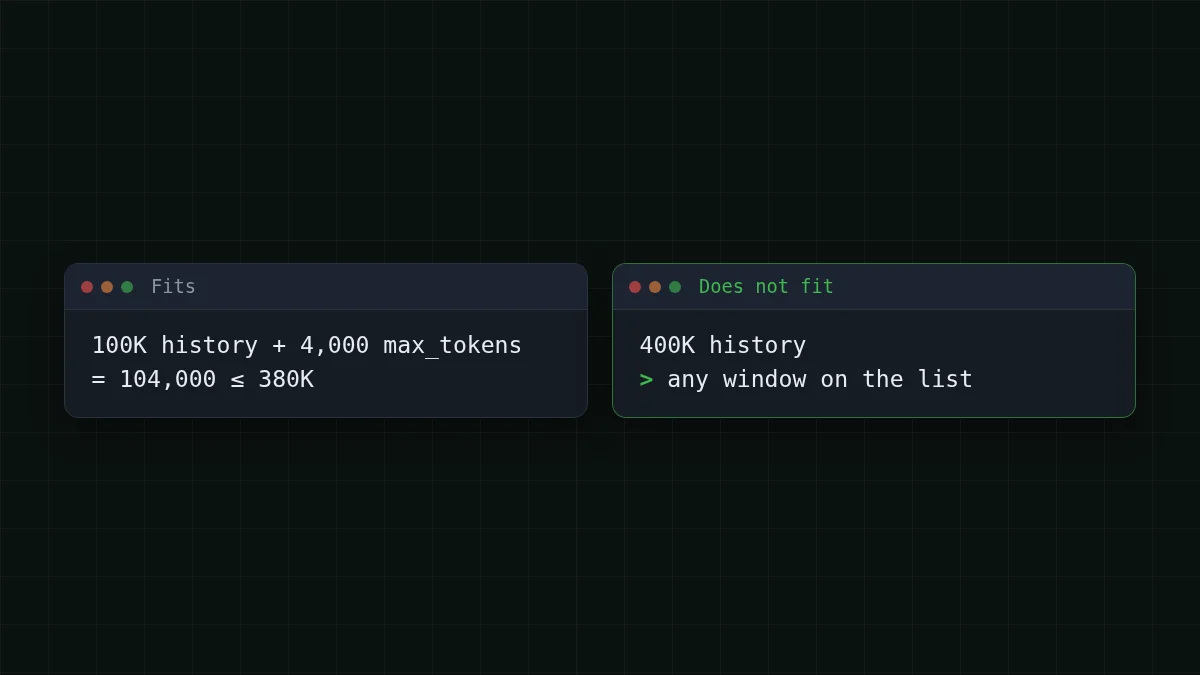
假设你的 agent 发送 100K token 的历史并要求返回 4,000 token。那是 100,000 + 4,000 = 104,000 token,在三个中的任何一个上都很舒适。现在同一个 agent 又过了五十步:400K。列表上没有窗口能容纳它,无论你设置什么 max_tokens。那就是错误出现的时刻,它看起来突然只是因为历史每轮增长了一点。
粗略的计数器对于守卫来说就足够了。英文文本平均每 token 约 4 个字符;代码和非英文文本每字符使用更多 token,所以留出余量:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)最后一行是你的校准:usage. 是 API 实际计数的。将它与 rough_ 比较几次,并根据你自己的文本调整除数和余量。
缩小请求的四种方法#
按此顺序选择最便宜的可行修复。
1. 降低 max_tokens。 只要求你需要的回答:输入加上 max_tokens 是你必须保持在窗口内的,每个模型对回答有自己的上限(上面的 8,192 或 32,768 token)。不要将 max_tokens 设置得高于回答所需,也不要高于模型对回答的上限。如果回答在你设置的限制处停止,它以 finish_ 结尾,这有自己的修复方法。
2. 裁剪历史。 丢弃最旧的轮次,保留系统提示词和最后几次交流。上面的 trim 函数正是这样做的。对于 agent,还要削减大量内容:5,000 行的工具输出在 agent 使用它们之后很少需要完整保留。
3. 总结而不是丢弃。 当旧轮次很重要时,让模型一次将它们压缩成简短笔记,然后用该笔记替换旧消息。你支付一次额外调用并保留线程。
4. 切换到更大的窗口。 从 MiniMax-M2.7(180K)切换到 GLM-5.3-Flash(390K)或 DeepSeek-V4-Flash(380K)只需更改模型 id 一行。如果你还需要长回答,DeepSeek-V4-Flash 允许最多 32,768 个输出 token,而且三者共享一个余额,所以切换在设置上没有任何成本。
清单
在重新发送失败的请求之前
长历史的成本#
裁剪不仅仅是为了错误。agent 的每一步都会重新发送整个历史,所以臃肿的历史也是账单中昂贵的部分。以一个 30 步的任务为例,每一步发送约 100K token 并得到约 1,500 返回:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 30 次请求 | OpenRouter,30 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
每次请求 100,000 个输入 token 和 1,500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
该表使用实时费率在每个模型上为同一任务定价。将历史削减到四分之一,输入侧下降约四分之三。要查看你自己的 agent 在哪里花费 token,在 Python 中跟踪每个请求的使用量;关于机制,为什么 agent 使用这么多 token通过一个 20 步的示例进行了说明。
DeepSeek-V4-Flash 目前每 1M 输入 token 花费 $0.015,每 1M 输出 token 花费 $0.10,任何时间都是一个价格。试试你自己的数字:
成本计算器
一个带有 100K 历史的 30 步 agent 任务
每次请求的输入 token 数: 100,000 · 每次请求的输出 token 数: 1,500 · 每日请求数: 30
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
如果仍然失败#
在慢速链路上的长请求有一个单独的失败:Anthropic 建议对具有大 max_tokens 的长请求使用流式传输或 Batch API,因为网络可能断开空闲连接,而且其 SDK 期望非流式请求在 10 分钟内完成。如果错误是超时或连接断开而不是 400,请参阅连接错误并设置 stream=True。
如果消息是 401 或 404,问题在于密钥、基础 URL 或模型 id:API 401 或 404 错误。有关确切的基础 URL、模型 id 和示例,请打开 CheapTokens 文档。


