快速开始指南
使用 API 进行多轮聊天:重新发送 messages 数组
模型在请求之间不记得任何东西。构建一个重新发送 messages 数组的 Python 聊天循环,并观察输入 token 如何增长。
你的第二个问题会得到奇怪的回答,因为 API 从未看到你的第一个问题。模型在请求之间不保留任何内容,所以聊天是你构建出来的:每次回复后,你把它追加到一个名为 messages 的列表中,并再次发送整个列表。这就是全部技巧,下面是一个针对 CheapTokens 的 OpenAI 兼容 API 的可运行 Python 循环。
两份官方文档描述了同一件事。Anthropic 的 Messages API 参考(2026 年 10 月 30 日查阅)称该 API 是无状态的、多轮的:之前的轮次通过 messages 参数传递。OpenAI 的文本生成指南(2026 年 10 月 30 日查阅)说,通过将之前的轮次作为带角色标记的消息发送,并在下一次请求前追加每条回复来保持上下文。
为什么第二个问题会得到茫然的眼神#
假设你输入 What is a token?,阅读答案,然后输入 Explain it shorter。对你来说,“它”是显而易见的。对 API 来说,第二个请求是一个陌生人的单行消息:没有“它”,没有什么可以缩短。你会得到一个猜测或一个反问,而不是更简短的解释。
解决办法是让第二个请求携带第一个请求的所有内容,加上回复,再加上新问题。比较这两个载荷:
比较
请求 2,有和没有历史记录
没有历史记录
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
模型完全不知道“它”是什么。
有历史记录
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
现在“它”指向第一个答案。
三个角色完成所有工作。system 一次性设定规则(语气、长度、机器人的用途)。user 是人输入的内容。assistant 是模型之前说的内容。模型从上到下读取列表,并写出下一条 assistant 消息。
几行代码实现聊天循环#
用 pip install openai 安装 SDK,并将你的密钥保存在环境变量中,如如何安全存储 API 密钥所述。基础 URL 和模型 ID 来自 CheapTokens 文档和 GET /v1/models(更多内容见列出模型以找到确切的 ID)。对于学习循环,GLM-5.3-Flash 很合适:390K 上下文,每个答案最多 8,192 个输出 token。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
运行它,问 What is a token?,然后问 Explain it shorter。第二个答案现在会引用第一个答案。最后一行打印 usage.,即该轮输入侧的账单;观察它随着每个问题而攀升。
循环内的顺序很重要,这也是初学者最常出错的地方:
排序
按顺序执行循环的一轮
拖动项目或使用箭头
- 将用户的问题追加到 messages
- 发送整个 messages 列表
- 从响应中读取回复
- 将回复作为 assistant 消息追加
跳过第 4 步,模型就会忘记自己的答案,于是“解释得简短些”只能生效一次,到第三个问题时又会失效。
两轮之后列表的样子#
在 What is a token? 和 Explain it shorter 之后,你的代码持有的列表有五个条目:系统规则、第一个问题、第一个答案、第二个问题、第二个答案。下一个请求将发送全部五个条目加上第三个问题。
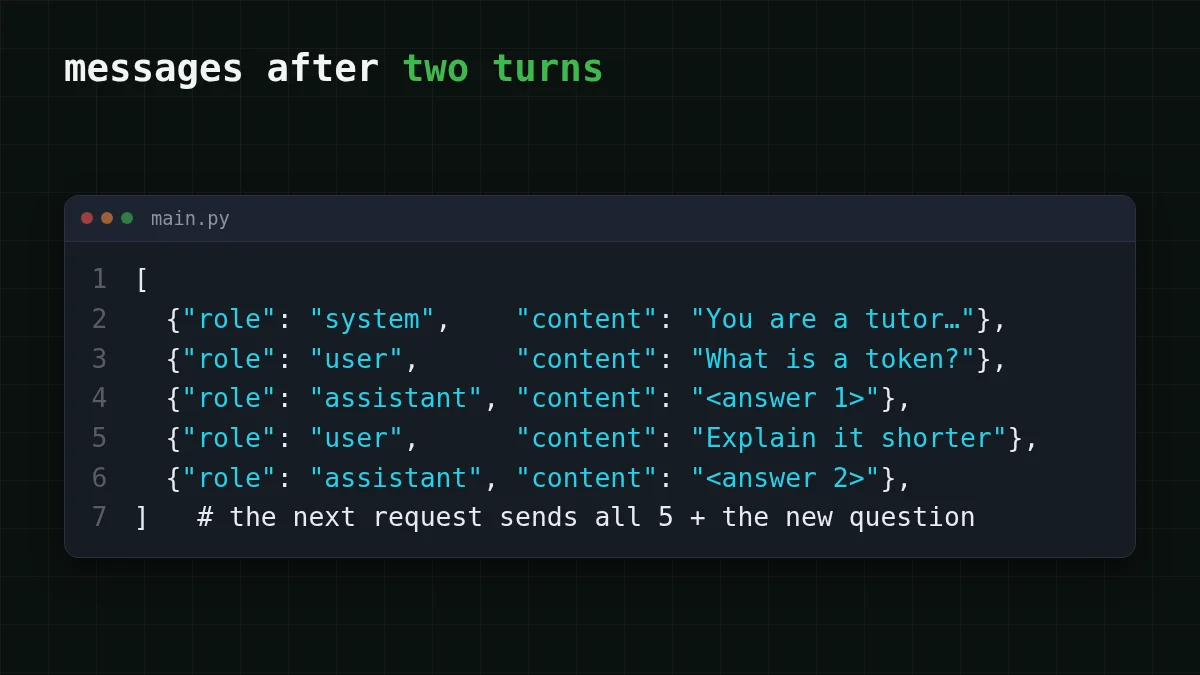
系统消息每次都会发送。API 不会在它那边“保留”它;它只是列表的第一项。OpenAI 的指南(2026 年 10 月 30 日查阅)指出,指令仅适用于当前请求,这是同一想法的另一种表述。如果你想调整第一条消息,请参阅系统提示和温度解释。
随着聊天增长,输入 token 会发生什么#
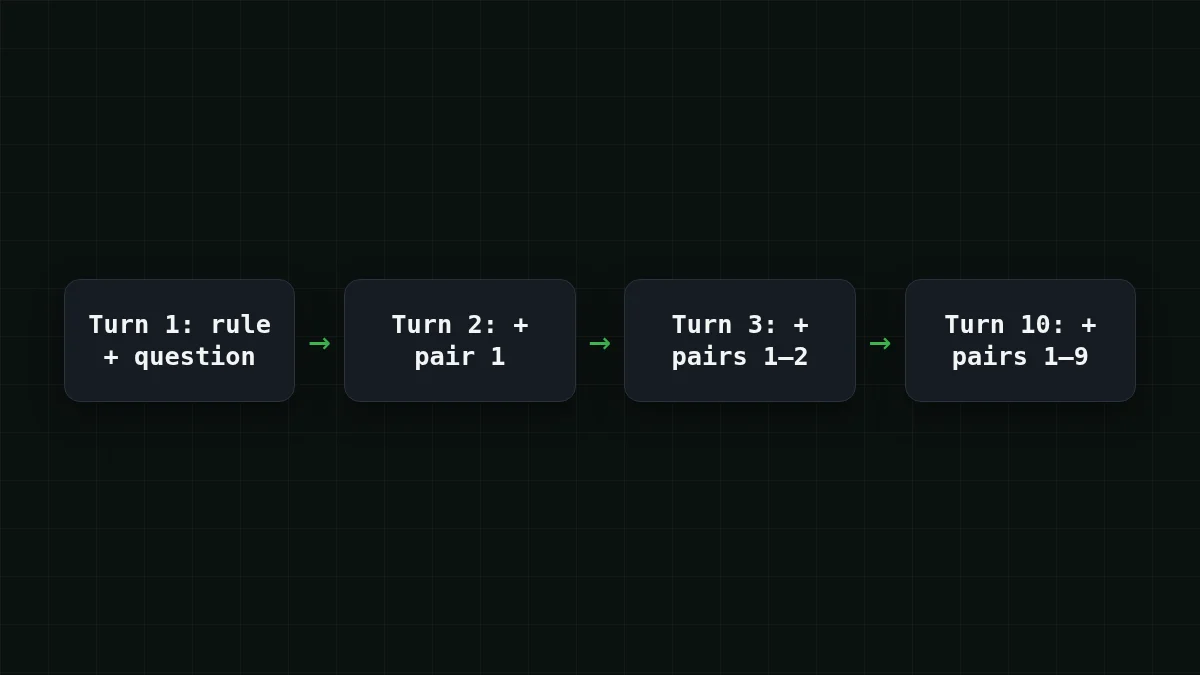
每个请求都要为整个列表再次支付输入费用。第 1 轮发送系统规则和一个问题;第 10 轮发送规则、九个之前的问答对和新问题。因此,即使你的每条消息都很短,输入也会随着每一轮增长。
假设一个 10 轮聊天,假设如下:系统规则约 50 个 token,每个问题约 150 个,每个回复约 250 个。第 1 轮发送 50 + 150 = 200 个输入 token。之后每一轮增加一个 400 token 的对(150 + 250 = 400),所以十轮的总输入是 200 × 10 + 400 × 45 = 20,000 个 token,其中 45 是 0 + 1 + … + 9。输出是 250 × 10 = 2,500 个 token。你发了十条消息,而输入是输出的八倍。
以下是整个聊天按实时费率计价,20,000 个输入 token 和 2,500 个输出 token:
| 模型 | 输入 $/1M | 输出 $/1M | 费用 | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
总计 20,000 个输入 token 和 2,500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
在总计中,将输入和输出一起计算,GLM-5.3-Flash 和 DeepSeek-V4-Flash 在这里比在 OpenRouter 上更便宜,而且两者在任何时段都保持一个价格。如果你在同一个聊天循环中需要超过 8,192 个 token 的答案,DeepSeek-V4-Flash 允许每个答案最多 32,768 个输出 token,上下文为 380K;将模型 ID 换成 deepseek-,循环中其他内容无需更改。
更深入的成本故事见为什么长 AI 聊天成本更高;输入与输出 token解释了为什么两侧分别定价。
快速检查
你的聊天进行到第 8 轮。第 8 轮的请求包含什么?
显示答案
答案: 系统消息和所有之前的问题与答案,加上最新的问题
API 不记得任何东西,所以每次都会发送完整列表。这也是输入 token 逐轮攀升的原因。
控制长聊天#
列表不能永远增长:它必须适应模型的上下文窗口(见什么是上下文窗口),而且每一轮额外都会消耗输入。两个习惯可以让原型保持合理:
- 修剪最旧的轮次。 保留系统消息和最后几对,例如在每次请求前
messages = messages[:1] + messages[-。成对删除,这样问题永远不会失去答案。8:] - 为新主题开始一个新列表。 新任务不需要旧任务的历史记录。
一个拥有长期规则集的支持机器人是同样的循环:系统消息一次性设定规则,每个用户轮次和回复都被追加,当列表变得沉重时进行修剪。关于第一个请求本身,请参阅你的第一个 CheapTokens API 请求;模型列表和价格在定价页面上。


