Per iniziareGuida
Chat multi-turn con un'API: reinviare l'array messages
Il modello non ricorda nulla tra una richiesta e l'altra. Costruisci un loop di chat Python che reinvia l'array messages e osserva come crescono i token di input.
In questa pagina
La tua seconda domanda riceve una risposta strana perché l'API non ha mai visto la prima. Il modello non conserva nulla tra una richiesta e l'altra, quindi una chat è qualcosa che tu costruisci: dopo ogni risposta la aggiungi a una lista chiamata messages e invii di nuovo l'intera lista. È tutto qui il trucco, e qui sotto trovi un loop Python funzionante per farlo contro l'API compatibile con OpenAI di CheapTokens.
Due documentazioni ufficiali descrivono la stessa cosa. Il riferimento dell'API Messages di Anthropic (verificato il 30 ottobre 2026) definisce l'API stateless e multi-turn: i turni precedenti viaggiano nel parametro messages. La guida alla generazione di testo di OpenAI (verificata il 30 ottobre 2026) dice di mantenere il contesto inviando i turni precedenti come messaggi con ruolo e aggiungendo ogni risposta prima della richiesta successiva.
Perché la seconda domanda riceve uno sguardo vuoto#
Supponi di digitare What is a token?, leggere la risposta e poi digitare Explain it shorter. Per te "it" è ovvio. Per l'API, la richiesta numero due è il messaggio di una riga di uno sconosciuto: non c'è nessun "it", niente da accorciare. Otterrai una supposizione o una domanda di rimando, non una spiegazione più breve.
La soluzione è far sì che la richiesta due contenga tutto ciò che aveva la richiesta uno, più la risposta, più la nuova domanda. Confronta i due payload:
Confronta
Richiesta 2, con e senza cronologia
Senza cronologia
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
Il modello non ha idea di cosa sia "it".
Con la cronologia
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
Ora "it" punta alla prima risposta.
Tre ruoli fanno tutto il lavoro. system imposta le regole una volta (tono, lunghezza, a cosa serve il bot). user è ciò che ha digitato la persona. assistant è ciò che il modello ha detto prima. Il modello legge la lista dall'alto in basso e scrive il successivo messaggio assistant.
Il loop di chat in poche righe#
Installa l'SDK con pip install openai e tieni la tua chiave in una variabile d'ambiente, come in come memorizzare in sicurezza una chiave API. L'URL di base e l'id del modello provengono dalla documentazione di CheapTokens e da GET /v1/models (altro in elencare i modelli per trovare l'id esatto). Per un loop di apprendimento, GLM-5.3-Flash è una buona scelta: contesto da 390K e fino a 8.192 token di output per risposta.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
Esegui il codice, chiedi What is a token?, poi Explain it shorter. La seconda risposta ora fa riferimento alla prima. L'ultima riga stampa usage., il lato input del conto per quel turno; guardalo salire a ogni domanda.
L'ordine dentro il loop conta, ed è la parte in cui i principianti sbagliano più spesso:
Metti in ordine
Metti in ordine un turno del loop
Trascina gli elementi o usa le frecce
- Aggiungi la domanda dell'utente a messages
- Invia l'intera lista messages
- Leggi la risposta dalla risposta
- Aggiungi la risposta come messaggio assistant
Salta il passo 4 e il modello dimentica le proprie risposte, così "spiegalo più breve" funziona una volta e poi si rompe di nuovo alla terza domanda.
Come appare la lista dopo due turni#
Dopo What is a token? e Explain it shorter, la lista che il tuo codice tiene ha cinque voci: la regola di sistema, la prima domanda, la prima risposta, la seconda domanda, la seconda risposta. La richiesta successiva invierà tutte e cinque più la terza domanda.
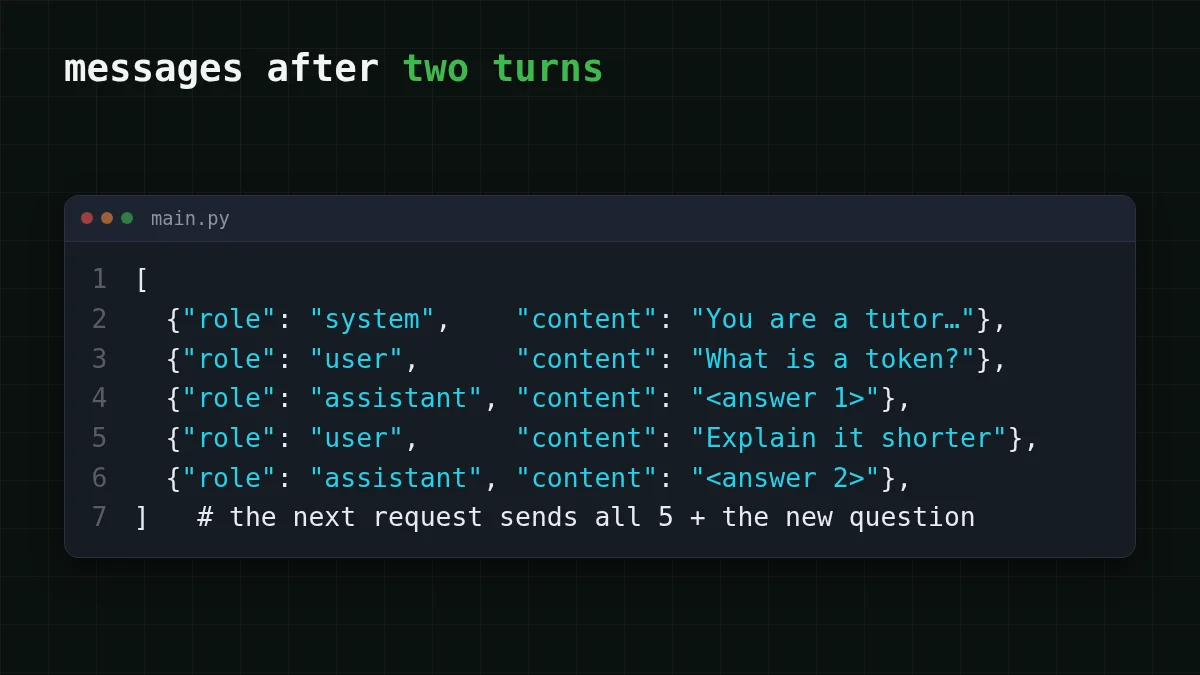
Il messaggio di sistema viene inviato ogni volta. L'API non lo "conserva" dalla sua parte; è semplicemente il primo elemento della lista. La guida di OpenAI (verificata il 30 ottobre 2026) nota che le istruzioni si applicano solo alla richiesta corrente, che è la stessa idea vista dall'altro lato. Se vuoi mettere a punto quel primo messaggio, vedi system prompt e temperature spiegati.
Cosa succede ai token di input man mano che la chat cresce#
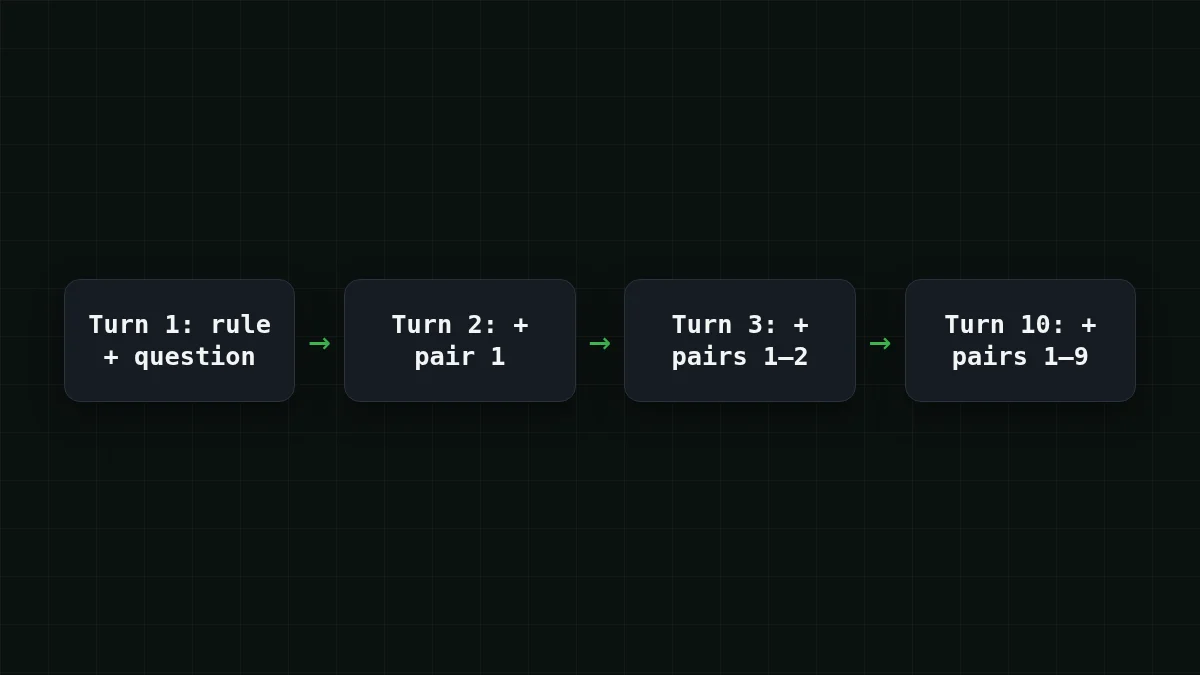
Ogni richiesta paga di nuovo l'intera lista come input. Il turno 1 invia la regola di sistema e una domanda; il turno 10 invia la regola, nove coppie domanda-risposta precedenti e la nuova domanda. Quindi l'input cresce a ogni turno, anche se ciascuno dei tuoi messaggi è breve.
Supponi una chat di 10 turni con queste ipotesi: la regola di sistema è di circa 50 token, ogni domanda di circa 150, ogni risposta di circa 250. Il turno 1 invia 50 + 150 = 200 token di input. Ogni turno successivo aggiunge un'altra coppia da 400 token (150 + 250 = 400), quindi il totale di input su dieci turni è 200 × 10 + 400 × 45 = 20.000 token, dove 45 è 0 + 1 + … + 9. L'output è 250 × 10 = 2.500 token. Dieci messaggi da parte tua, e l'input è otto volte l'output.
Ecco l'intera chat prezzata sulle tariffe live, 20.000 token in input e 2.500 in output:
| Modello | Input $/1M | Output $/1M | Costo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
20.000 token di input e 2500 token di output in totale. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Nel totale, contando insieme input e output, GLM-5.3-Flash e DeepSeek-V4-Flash costano qui meno che su OpenRouter, ed entrambi mantengono un unico prezzo a qualsiasi ora. Se vuoi risposte più lunghe di 8.192 token nello stesso loop di chat, DeepSeek-V4-Flash consente fino a 32.768 token di output per risposta con un contesto da 380K; sostituisci l'id del modello con deepseek- e nient'altro nel loop cambia.
La storia più approfondita dei costi è in perché una lunga chat AI costa di più; token di input vs output spiega perché i due lati sono prezzati separatamente.
Verifica rapida
La tua chat è al turno 8. Cosa contiene la richiesta per il turno 8?
Mostra risposta
Risposta: Il messaggio di sistema e ogni domanda e risposta precedente, più la domanda più recente
L'API non ricorda nulla, quindi l'intera lista viene inviata ogni volta. È anche per questo che i token di input salgono turno dopo turno.
Tenere sotto controllo una chat lunga#
La lista non può crescere all'infinito: deve stare nella finestra di contesto del modello (vedi cos'è una finestra di contesto), e ogni turno in più costa input. Due abitudini la mantengono ragionevole per un prototipo:
- Taglia i turni più vecchi. Mantieni il messaggio di sistema e le ultime coppie, per esempio
messages = messages[:1] + messages[-prima di ogni richiesta. Elimina le coppie insieme, così una domanda non perde mai la sua risposta.8:] - Inizia una lista nuova per un nuovo argomento. Un nuovo compito non ha bisogno della cronologia del precedente.
Un bot di supporto con un set di regole di lunga durata è lo stesso loop: il messaggio di sistema imposta le regole una volta, ogni turno utente e risposta viene aggiunto, e tagli quando la lista diventa pesante. Per la prima richiesta in sé, vedi la tua prima richiesta API con CheapTokens; la lista dei modelli e i prezzi sono nella pagina dei prezzi.


