はじめにガイド
APIでのマルチターンチャット:messages配列を再送信する
モデルはリクエスト間で何も記憶しません。messages配列を再送信するPythonチャットループを構築し、入力トークンがどう増えるかを見てみましょう。
2つ目の質問に奇妙な答えが返ってくるのは、APIが1つ目の質問を一度も見ていないからです。モデルはリクエスト間で何も保持しないため、チャットはあなたが構築するものです。返信のたびにそれをmessagesというリストに追加し、リスト全体を再度送信します。仕組みはこれだけです。以下はCheapTokensのOpenAI互換APIに対して動作するPythonループです。
同じことを説明している公式ドキュメントが2つあります。AnthropicのMessages APIリファレンス(2026年10月30日確認)は、APIをステートレスかつマルチターンと表現し、以前のターンはmessagesパラメータで送信されるとしています。OpenAIのテキスト生成ガイド(2026年10月30日確認)は、以前のターンをロール付きメッセージとして送信し、次のリクエストの前に各返信を追加することでコンテキストを保持すると述べています。
2つ目の質問が白けた反応をされる理由#
What is a token?と入力して答えを読み、次にExplain it shorterと入力したとします。あなたにとって「それ」は明らかです。しかしAPIにとって、2番目のリクエストは見知らぬ人の1行メッセージにすぎません。「それ」は存在せず、短くする対象もありません。返ってくるのは短い説明ではなく、推測か質問です。
解決策は、2番目のリクエストに1番目のリクエストのすべて、返信、そして新しい質問を含めることです。2つのペイロードを比較してみましょう。
比較する
リクエスト2、履歴ありとなし
履歴なし
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
モデルは「それ」が何なのかまったく分かりません。
履歴あり
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
これで「それ」は最初の答えを指します。
3つのロールがすべてを担います。systemはルール(口調、長さ、ボットの目的)を一度設定します。userは人が入力した内容です。assistantはモデルが以前に述べた内容です。モデルはリストを上から下へ読み、次のassistantメッセージを書きます。
数行で書けるチャットループ#
pip install openaiでSDKをインストールし、APIキーを安全に保存する方法のようにキーを環境変数に保持します。ベースURLとモデルIDはCheapTokensのドキュメントとGET /v1/modelsから取得します(詳細は正確なIDを見つけるためのモデル一覧)。学習用のループにはGLM-5.3-Flashが適しています。390Kのコンテキストと、回答あたり最大8,192の出力トークンを備えています。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
print(f"[input tokens this turn: {response.usage.prompt_tokens}]")実行してWhat is a token?、次にExplain it shorterと尋ねてみましょう。2つ目の答えは1つ目を参照するようになります。最後の行はusage.を出力します。これはそのターンの請求の入力側であり、質問のたびに増えていくのが分かります。
ループ内の順序は重要で、初心者が最もよく間違える部分です。
順番に並べる
ループの1ターンを順序通りに
項目をドラッグするか矢印を使う
- ユーザーの質問をmessagesに追加する
- messagesリスト全体を送信する
- レスポンスから返信を読み取る
- 返信をassistantメッセージとして追加する
ステップ4を飛ばすと、モデルは自分の答えを忘れてしまい、「短く説明して」は一度だけ機能し、3つ目の質問でまた壊れます。
2ターン後のリストの様子#
What is a token?とExplain it shorterの後、コードが保持するリストには5つのエントリがあります。システムルール、最初の質問、最初の答え、2番目の質問、2番目の答えです。次のリクエストでは、これら5つすべてに3番目の質問を加えて送信します。
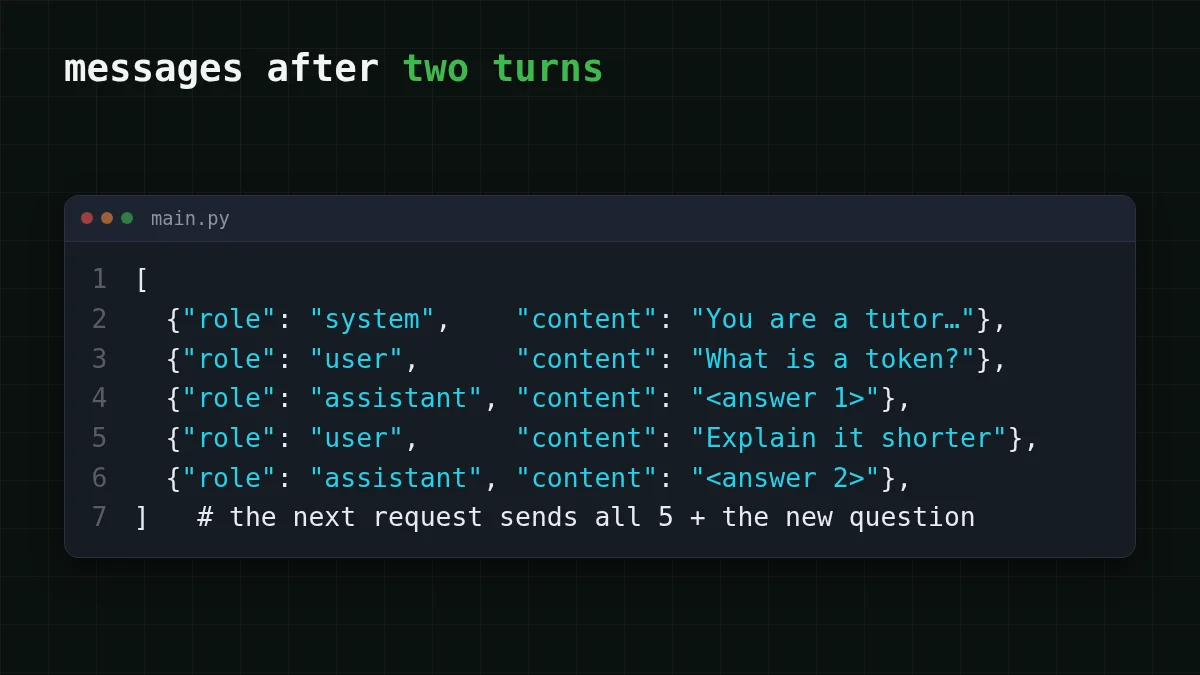
システムメッセージは毎回送信されます。APIはそれを自側で「保持」しているわけではなく、単にリストの最初の項目なのです。OpenAIのガイド(2026年10月30日確認)は、指示は現在のリクエストにのみ適用されると述べており、これは逆方向から見た同じ考え方です。最初のメッセージを調整したい場合は、システムプロンプトとtemperatureの解説をご覧ください。
チャットが長くなるにつれて入力トークンはどうなるか#
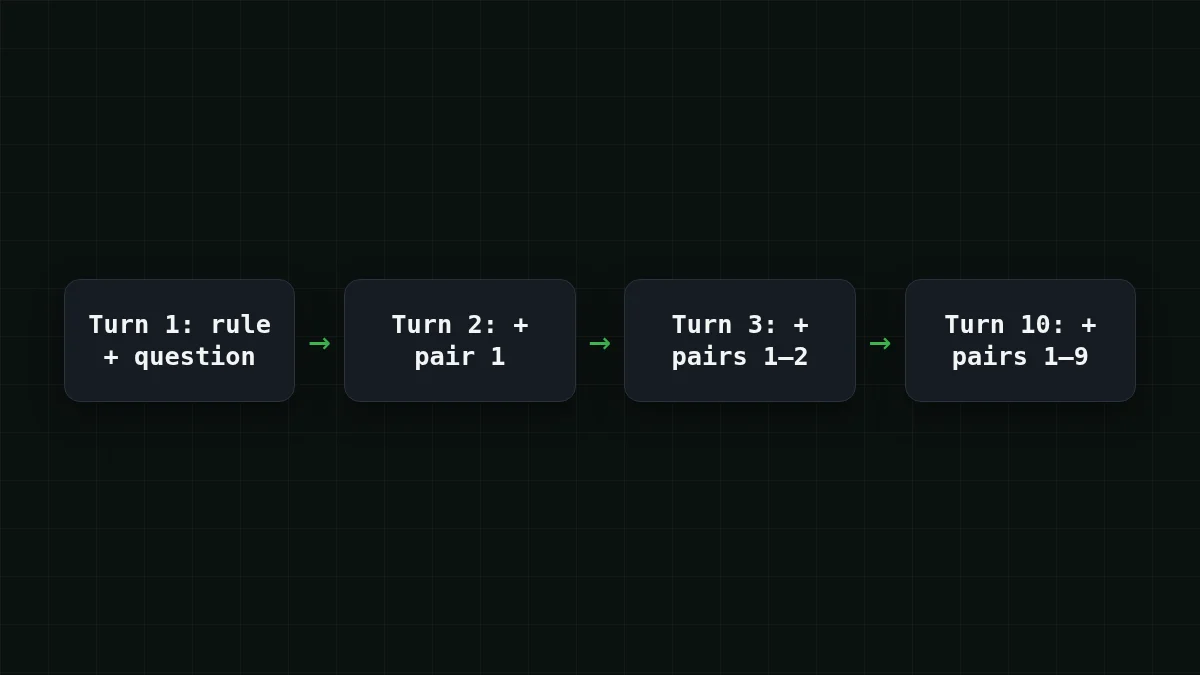
すべてのリクエストはリスト全体を入力として再度支払います。ターン1はシステムルールと1つの質問を送信し、ターン10はルール、9つの以前の質問と回答のペア、そして新しい質問を送信します。つまり、あなたの各メッセージが短くても、入力はターンごとに増えていきます。
次の仮定で10ターンのチャットを考えます。システムルールは約50トークン、各質問は約150、各返信は約250です。ターン1は50 + 150 = 200入力トークンを送信します。以降の各ターンはさらに400トークンのペア(150 + 250 = 400)を追加するので、10ターンの総入力は200 × 10 + 400 × 45 = 20,000トークンとなります(45は0 + 1 + … + 9)。出力は250 × 10 = 2,500トークンです。あなたからのメッセージは10件で、入力は出力の8倍になります。
このチャット全体を実際の料金で計算すると、入力20,000トークン、出力2,500トークンになります。
| モデル | 入力 $/1M | 出力 $/1M | コスト | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
合計 20,000 入力トークンと 2,500 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
入力と出力を合計した総額では、GLM-5.3-FlashとDeepSeek-V4-FlashはここではOpenRouterより安く、どちらも時間帯に関係なく同一価格を維持します。同じチャットループで8,192トークンを超える回答が必要な場合、DeepSeek-V4-Flashは380Kのコンテキストで回答あたり最大32,768出力トークンを許可します。モデルIDをdeepseek-に差し替えるだけで、ループ内の他の何も変わりません。
コストの詳細については長いAIチャットが高くつく理由を、入力トークンと出力トークンでは2つが別々に価格設定される理由を説明しています。
クイックチェック
チャットがターン8に達しました。ターン8のリクエストには何が含まれますか?
答えを表示
答え: システムメッセージと以前のすべての質問と回答、そして最新の質問
APIは何も記憶しないため、毎回リスト全体が送信されます。これが入力トークンがターンごとに増える理由でもあります。
長いチャットを制御する#
リストは永遠に成長できません。モデルのコンテキストウィンドウに収まる必要があり(コンテキストウィンドウとはを参照)、追加のターンごとに入力コストがかかります。プロトタイプでは2つの習慣で健全に保てます。
- 最も古いターンを削る。 システムメッセージと最後の数ペアを保持します。例えば各リクエストの前に
messages = messages[:1] + messages[-を実行します。質問が答えを失わないよう、ペアごとまとめて削除してください。8:] - 新しいトピックには新しいリストを開始する。 新しいタスクに古いタスクの履歴は必要ありません。
長期間使われるルールセットを持つサポートボットも同じループです。システムメッセージがルールを一度設定し、各ユーザーターンと返信が追加され、リストが重くなったら削ります。最初のリクエスト自体についてはCheapTokensでの最初のAPIリクエストを、モデル一覧と価格は料金ページをご覧ください。


