Начало работыИнструкция
Чат через API: как передавать историю в messages
У модели нет памяти между запросами. Соберите на Python чат, который каждый раз отправляет весь массив messages, и посмотрите, как растёт вход.
Содержание
На второй вопрос API отвечает странно, потому что первого оно не видело. Между запросами модель ничего не хранит, так что чат — это то, что собираете вы: после каждого ответа добавляете его в список messages и отправляете список целиком. Вся хитрость в этом, а ниже — рабочий цикл на Python для OpenAI-совместимого API CheapTokens.
То же самое описывают две официальные документации. Справочник Messages API от Anthropic (сверено 30 октября 2026) называет API stateless и многоходовым: прежние реплики передаются в параметре messages. Руководство OpenAI по генерации текста (сверено 30 октября 2026) советует держать контекст, отправляя прежние реплики сообщениями с ролями и добавляя каждый ответ перед следующим запросом.
Почему второй вопрос повисает в воздухе#
Допустим, вы написали Что такое токен?, прочитали ответ и пишете Объясни короче. Для вас «это» очевидно. Для API второй запрос — одинокая строчка от незнакомца: никакого «это» нет, сокращать нечего. В ответ придёт догадка или встречный вопрос, а не короткое объяснение.
Чинится просто: второй запрос несёт всё, что было в первом, плюс ответ, плюс новый вопрос. Сравните два варианта:
Сравнение
Запрос 2: без истории и с историей
Без истории
messages = [
    {"role": "user", "content": "Объясни короче"},
]
Модель не знает, что такое «это».
С историей
messages = [
    {"role": "user", "content": "Что такое токен?"},
    {"role": "assistant", "content": "<первый ответ>"},
    {"role": "user", "content": "Объясни короче"},
]
Теперь «это» указывает на первый ответ.
Всю работу делают три роли. system один раз задаёт правила (тон, длину, зачем нужен бот). user — то, что набрал человек. assistant — то, что модель сказала раньше. Модель читает список сверху вниз и пишет следующее сообщение assistant.
Цикл чата в нескольких строках#
Установите SDK командой pip install openai и держите ключ в переменной окружения, как в статье как безопасно хранить API-ключ. Базовый адрес и id модели берите из документации CheapTokens и из GET /v1/models (подробнее — как получить список моделей и точный id). Для учебного цикла подойдёт GLM-5.3-Flash: контекст 390K и до 8 192 токенов в ответе.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
Запустите, спросите Что такое токен?, потом Объясни короче. Теперь второй ответ ссылается на первый. Последняя строка печатает usage. — входную часть счёта за этот ход; следите, как она растёт с каждым вопросом.
Порядок внутри цикла важен, и именно здесь новички ошибаются чаще всего:
Расставьте по порядку
Расставьте один ход цикла по порядку
Перетащите элементы или используйте стрелки
- Добавить вопрос пользователя в messages
- Отправить весь список messages
- Прочитать ответ из response
- Добавить ответ в список как сообщение assistant
Пропустите шаг 4 — и модель забудет собственные ответы: «объясни короче» сработает один раз, а на третьем вопросе снова собьётся.
Как выглядит список после двух ходов#
После Что такое токен? и Объясни короче в вашем коде лежит список из пяти записей: правило system, первый вопрос, первый ответ, второй вопрос, второй ответ. Следующий запрос отправит все пять плюс третий вопрос.
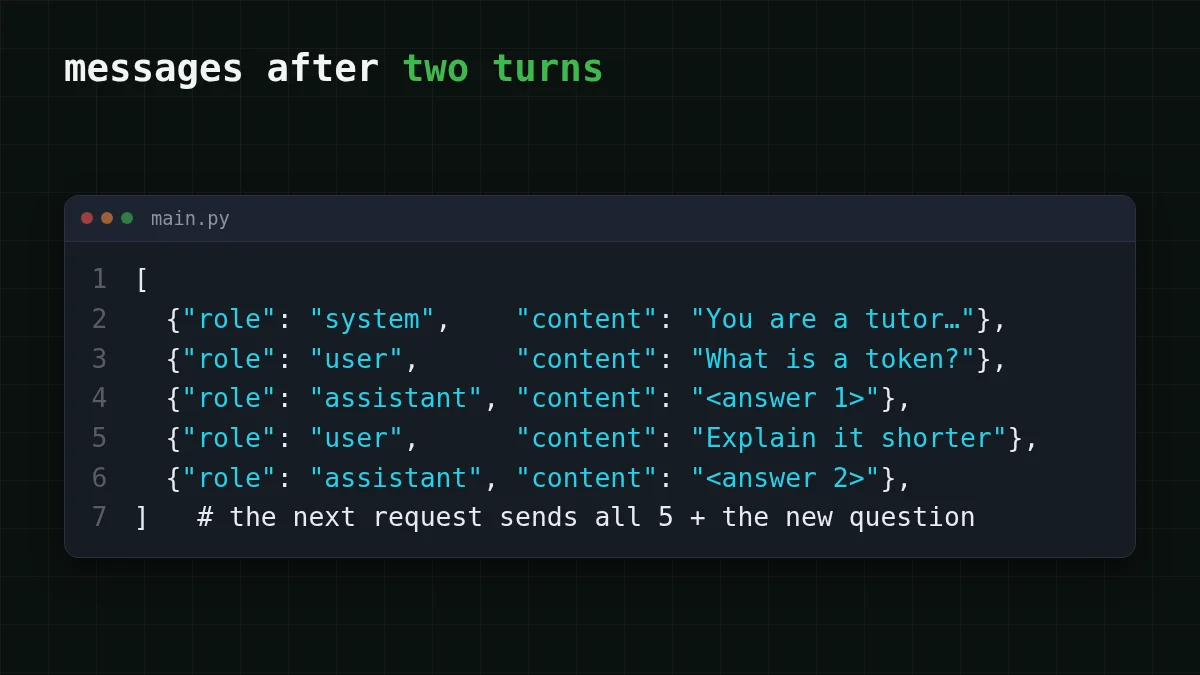
Сообщение system уходит каждый раз. API не «хранит» его у себя: это просто первый элемент списка. Руководство OpenAI (сверено 30 октября 2026) отмечает, что инструкции действуют только на текущий запрос, — та же мысль с другой стороны. Как настроить это первое сообщение — в статье системный промпт и temperature.
Что происходит со входными токенами, пока чат растёт#
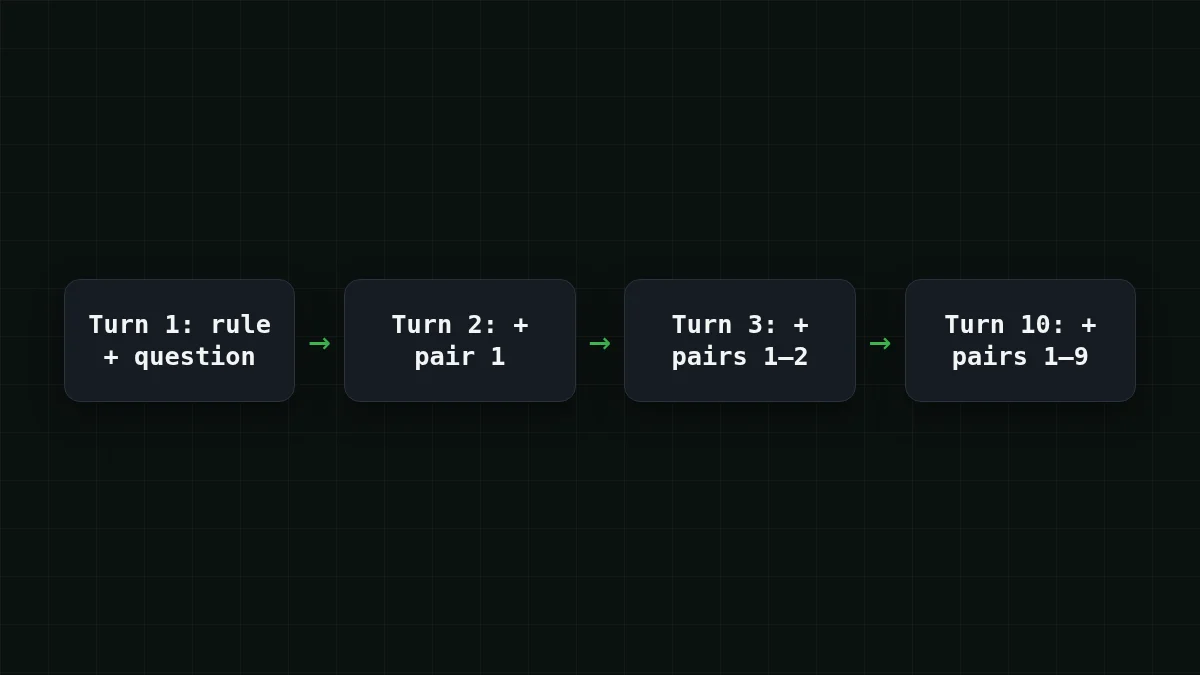
Каждый запрос снова оплачивает весь список как вход. Ход 1 отправляет правило и один вопрос; ход 10 — правило, девять прежних пар «вопрос–ответ» и новый вопрос. Вход растёт с каждым ходом, даже если ваши сообщения короткие.
Допустим, чат из 10 ходов и такие допущения: правило system около 50 токенов, каждый вопрос около 150, каждый ответ около 250. Ход 1 отправляет 50 + 150 = 200 входных токенов. Каждый следующий ход добавляет пару в 400 токенов (150 + 250 = 400), так что за десять ходов вход — 200 × 10 + 400 × 45 = 20 000 токенов, где 45 — это 0 + 1 + … + 9. Выход — 250 × 10 = 2 500 токенов. Десять ваших реплик, а входа в восемь раз больше, чем выхода.
Вот весь этот чат по живым тарифам: 20 000 токенов на входе и 2 500 на выходе:
| Модель | Вход $/1M | Выход $/1M | Стоимость | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
20 000 входных и 2 500 выходных токенов всего. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
В сумме, с учётом входа и выхода, GLM-5.3-Flash и DeepSeek-V4-Flash здесь выходят дешевле, чем на OpenRouter, и обе держат одну цену в любое время суток. Если в этом же чате нужны ответы длиннее 8 192 токенов, DeepSeek-V4-Flash отдаёт до 32 768 токенов за ответ при контексте 380K: замените id модели на deepseek-, остальной цикл не меняется.
Подробнее о расходах — в статье почему длинный чат с ИИ стоит дороже; а вход и выход токенов объясняют, почему две стороны считаются отдельно.
Быстрая проверка
Чат на ходе 8. Что содержит запрос восьмого хода?
Показать ответ
Ответ: Сообщение system, все прежние вопросы и ответы и новый вопрос
API ничего не помнит, поэтому полный список уходит каждый раз. Отсюда и рост входных токенов от хода к ходу.
Как не дать длинному чату разрастись#
Список не может расти бесконечно: он должен помещаться в окно контекста модели (см. что такое окно контекста), и каждый лишний ход стоит входных токенов. Для прототипа хватает двух привычек:
- Обрезайте старые ходы. Оставьте сообщение system и несколько последних пар, например
messages = messages[:1] + messages[-перед каждым запросом. Убирайте пары целиком, чтобы вопрос не остался без ответа.8:] - Для новой темы начинайте новый список. Новой задаче история старой не нужна.
Бот поддержки с долгоживущим набором правил — тот же цикл: system задаёт правила один раз, каждая реплика пользователя и ответ добавляются в список, а когда он тяжелеет — вы обрезаете. Про сам первый запрос — ваш первый запрос к API CheapTokens; список моделей и цены — на странице цен.


