API и SDKИнструкция
LangChain ChatOpenAI с другим base_url: CheapTokens на Python
Как направить ChatOpenAI из LangChain на CheapTokens: base_url, ключ и id модели на Python, а ещё invoke, стриминг и токены за вызов.
Содержание
У вас есть цепочка LangChain на ChatOpenAI, и её нужно запустить на другом эндпоинте, ничего не переписывая. Это можно: передайте три аргумента, base_url, api_key и model, остальной код остаётся как есть. CheapTokens работает по протоколу OpenAI Chat Completions по адресу https:/, поэтому ChatOpenAI подключается к нему напрямую.
Шаги ниже сверены с документацией LangChain по ChatOpenAI на 27 октября 2026 года. У страницы нет даты и версии, поэтому конкретный релиз langchain-openai я не называю: ставьте последний.
Шаг за шагом
Подключаем LangChain за три шага
Установка
pip install -U langchain-openaiКлюч
Храните ключ в переменной окружения, а не в файле:
export CHEAPTOKENS_API_KEY="your-key"Вызов модели
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() возвращает сообщение, а .content — это текст ответа. Вот и всё подключение. Ключ и пополнение баланса — в документации CheapTokens.
Какой id модели писать в model#
Пишите полный id, с префиксом разработчика. Короткое имя вроде deepseek- вы видите в таблицах цен, а API принимает deepseek-. Id из списка моделей CheapTokens:
deepseek-: контекст 380K, до 32 768 токенов в одном ответе. Хороший выбор по умолчанию для цепочек с длинными документами и длинными ответами.ai/ DeepSeek- V4- Flash- 0731 zai-: контекст 390K, до 8 192 токенов в ответе.org/ GLM- 5. 3- Flash MiniMaxAI/: контекст 180K, до 8 192 токенов в ответе.MiniMax- M2. 7
Переключение — правка одной строки, ведь модель это просто строка:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
Баланс один на все три модели, так что одну и ту же цепочку можно прогнать на каждой без новых настроек. Актуальные цены — на странице цен: у MiniMax-M2.7 вход $0.05, выход $0.15 за 1M токенов.
base_url через переменные окружения#
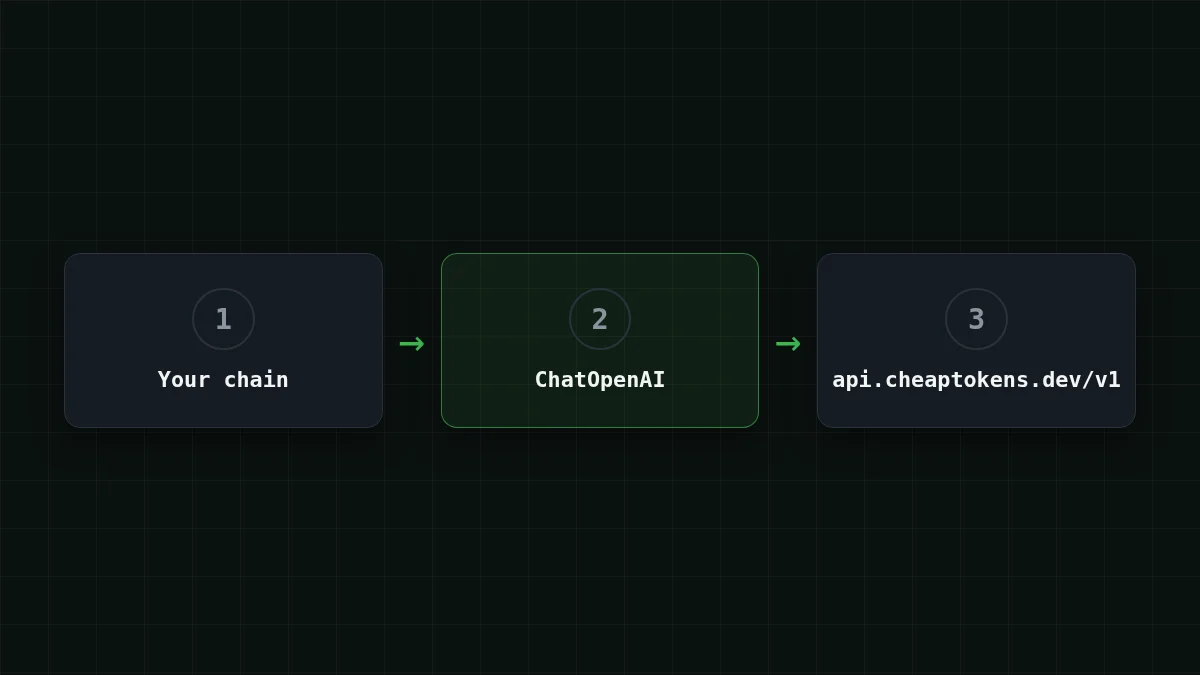
Если код трогать не хочется, LangChain читает адрес из окружения. Порядок приоритета — по документации:
- аргумент
base_url(илиopenai_api_base) в коде; OPENAI_API_BASE, её читает LangChain;OPENAI_BASE_URL, её читает SDKopenai.
Быстрая проверка
Вы задали base_url в коде и ещё экспортировали OPENAI_BASE_URL с другим адресом. Какой адрес возьмёт ChatOpenAI?
Показать ответ
Ответ: Аргумент base_url из кода
Явный аргумент приоритетнее всего, затем OPENAI_API_BASE, затем OPENAI_BASE_URL. Забытая переменная в терминале не перенаправит вызов, где base_url задан явно.
Из той же страницы документации ещё одно следствие: если задана OPENAI_BASE_URL, LangChain по умолчанию выключает stream_usage. Это важно в следующих двух разделах.
Стриминг ответа#
Для интерфейса нужен текст по мере появления. stream() отдаёт куски, у каждого есть .content:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
Для окна чата этого хватает. Если нужен ещё и подсчёт токенов в конце стрима, передайте stream_: ChatOpenAI(.. В этом руководстве токены считаются по invoke(), как в следующем разделе. Стриминг в обычном SDK OpenAI разобран в статье Стриминг ответов в Python.
Токены за каждый вызов#
У каждого сообщения от invoke() есть usage_metadata с токенами этого вызова:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
Сложите их по всему пайплайну, и получится бюджет запуска:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
Вход и выход тарифицируются отдельно, поэтому храните оба числа. Почему они разделены — в статье Входные и выходные токены, а готовый счётчик с остановкой по бюджету — в Учёт токенов агента на Python.
Сколько стоит пайплайн LangChain за день#
Допустим, у вас бот поддержки на 2 000 обращений в день. Каждый вызов отправляет обращение с промптом, около 3 000 токенов, а ответ занимает около 500. На MiniMax-M2.7 один такой вызов стоит $0.00023. Подвигайте ползунки под свои числа, сайт посчитает по текущим ценам:
Калькулятор стоимости
Один день бота поддержки
Входные токены на запрос: 3 000 · Выходные токены на запрос: 500 · Запросов в день: 2 000
| Модель | В день | В месяц |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
Калькулятор показывает сумму за день: в таком вызове большая часть токенов приходится на вход, меньшая — на выход. В CheapTokens итог, вход и выход вместе, получается ниже, чем у OpenRouter, а цена одинакова в любое время суток: пиковых тарифов, под которые надо подстраиваться, нет.
Что покрывает это руководство#
В примере обычные chat completions: invoke, stream и usage_metadata. ChatOpenAI следует спецификации OpenAI, поэтому текст ответа лежит в .content. По документации LangChain, он переключается на Responses API, если используются встроенные инструменты или параметр reasoning.
Если вызов падает, причина обычно одна из трёх: в base_url нет /v1, вместо полного id модели указано короткое имя, или переменная с ключом не экспортирована в том терминале, где запускается Python. Как выглядит каждая, показано в списке частых ошибок подключения.
Следующий шаг: запустите блок из трёх шагов со своей цепочкой, а потом прогоните её же с другим id модели — как это устроено, объясняет статья про OpenAI-совместимый API.


