API และ SDKคู่มือ
LangChain ChatOpenAI กับ base_url แบบกำหนดเอง: CheapTokens ใน Python
ชี้ ChatOpenAI ของ LangChain ไปที่ CheapTokens: base_url, คีย์ และ model id ใน Python แล้ว invoke, สตรีม และการใช้โทเคนต่อการเรียก
ในหน้านี้
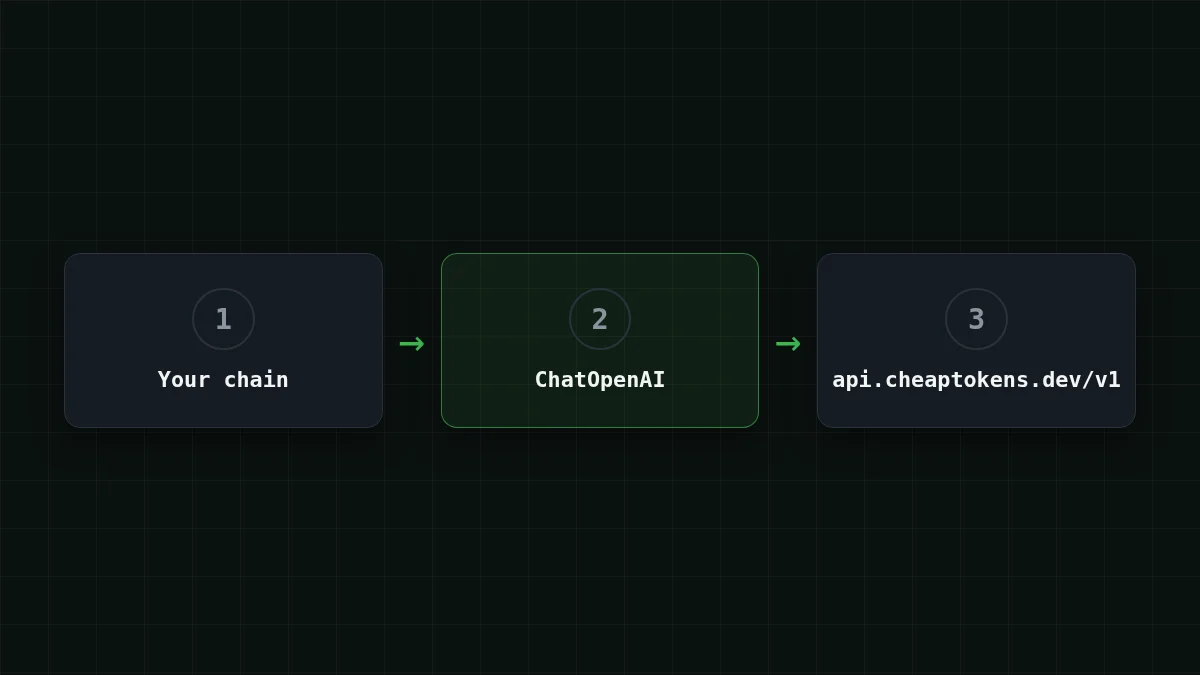
คุณมีเชน LangChain ที่คุยกับ ChatOpenAI อยู่แล้ว และต้องการให้มันทำงานบน endpoint อื่นโดยไม่ต้องเขียนใหม่ คุณทำได้โดย: ส่งอาร์กิวเมนต์สามตัว คือ base_url, api_key และ model ส่วนที่เหลือของเชนยังคงเหมือนเดิม CheapTokens พูดภาษาโปรโตคอล OpenAI Chat Completions ที่ https:/ ดังนั้น ChatOpenAI จึงใช้กับมันได้โดยตรง
ขั้นตอนด้านล่างอ้างอิงจากเอกสาร LangChain ChatOpenAI ณ วันที่ตรวจสอบ 27 ตุลาคม 2026 หน้าเว็บไม่แสดงวันที่หรือเวอร์ชัน ดังนั้นผมจึงไม่ระบุเวอร์ชัน langchain-openai ที่นี่: ให้ติดตั้งเวอร์ชันล่าสุด
ทีละขั้นตอน
เชื่อมต่อ LangChain ในสามขั้นตอน
ติดตั้ง
pip install -U langchain-openaiตั้งค่าคีย์
เก็บคีย์ไว้ในตัวแปรสภาพแวดล้อม ไม่ใช่ในไฟล์:
export CHEAPTOKENS_API_KEY="your-key"เรียกโมเดล
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() คืนค่าข้อความ ส่วน .content คือข้อความคำตอบ นั่นคือการเชื่อมต่อทั้งหมด รับคีย์และเติมยอดคงเหลือได้ที่เอกสาร CheapTokens
model id ตัวไหนใส่ใน model#
ใช้ id แบบเต็มพร้อมคำนำหน้าผู้พัฒนา ชื่อสั้นอย่าง deepseek- คือสิ่งที่คุณเห็นในตารางราคา ส่วน API รับ deepseek- id จากรายการโมเดลของ CheapTokens:
deepseek-: คอนเท็กซ์ 380K เอาต์พุตสูงสุด 32,768 โทเคนต่อคำตอบ เหมาะเป็นค่าเริ่มต้นสำหรับเชนที่มีเอกสารยาวและคำตอบยาวai/ DeepSeek- V4- Flash- 0731 zai-: คอนเท็กซ์ 390K เอาต์พุตสูงสุด 8,192 โทเคนorg/ GLM- 5. 3- Flash MiniMaxAI/: คอนเท็กซ์ 180K เอาต์พุตสูงสุด 8,192 โทเคนMiniMax- M2. 7
การสลับเป็นเพียงการแก้ไขบรรทัดเดียว เพราะโมเดลเป็นเพียงสตริง:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
ทั้งสามใช้ยอดคงเหลือร่วมกัน ดังนั้นคุณจึงลองแต่ละตัวบนเชนเดียวกันได้โดยไม่ต้องเปิดอะไรใหม่ ราคาปัจจุบันอยู่ที่หน้าราคา สำหรับ MiniMax-M2.7 อินพุตคือ $0.05 และเอาต์พุต $0.15 ต่อ 1M โทเคน
การตั้งค่า base_url ผ่านสภาพแวดล้อม#
หากคุณไม่อยากแตะโค้ด LangChain จะอ่านที่อยู่จากสภาพแวดล้อม เอกสารระบุลำดับความสำคัญ:
- อาร์กิวเมนต์
base_url(หรือopenai_api_base) ที่คุณส่งในโค้ด; OPENAI_API_BASEซึ่ง LangChain อ่าน;OPENAI_BASE_URLซึ่ง SDKopenaiอ่าน
เช็กด่วน
คุณตั้ง base_url ในโค้ดและยัง export OPENAI_BASE_URL ด้วยที่อยู่อื่น ChatOpenAI จะใช้อันไหน?
แสดงคำตอบ
คำตอบ: อาร์กิวเมนต์ base_url ในโค้ด
อาร์กิวเมนต์ที่ระบุชัดเจนมีลำดับความสำคัญสูงสุด ตามด้วย OPENAI_API_BASE แล้วจึง OPENAI_BASE_URL ตัวแปรที่ลืมไว้ในเชลล์ของคุณจะไม่เปลี่ยนเส้นทางคำขอที่ตั้ง base_url อย่างชัดเจน
ผลข้างเคียงหนึ่งจากหน้าเอกสารเดียวกัน: เมื่อตั้งค่า OPENAI_BASE_URL LangChain จะปิด stream_usage โดยค่าเริ่มต้น สิ่งนี้สำคัญในสองส่วนถัดไป
การสตรีมคำตอบ#
สำหรับ UI คุณต้องการข้อความขณะที่มาถึง stream() ให้ผลลัพธ์เป็นชังก์ และแต่ละชังก์มีส่วน .content:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
เท่านี้ก็เพียงพอสำหรับหน้าต่างแชท หากคุณต้องการจำนวนโทเคนเมื่อสิ้นสุดการสตรีมด้วย ให้ส่ง stream_: ChatOpenAI(. คู่มือนี้นับโทเคนจาก invoke() ดังในส่วนถัดไป การสตรีมใน OpenAI SDK แบบธรรมดาอธิบายไว้ในการสตรีมคำตอบใน Python
การอ่านการใช้โทเคนต่อการเรียก#
ทุกข้อความที่ invoke() คืนมาจะมี usage_metadata พร้อมโทเคนที่การเรียกใช้ไป:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
รวมค่าเหล่านี้ตลอดไปป์ไลน์แล้วคุณจะได้งบประมาณต่อการรัน:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
อินพุตและเอาต์พุตคิดราคาแยกกัน ดังนั้นเก็บตัวเลขทั้งสองไว้ เหตุผลของการแยกนี้อยู่ในโทเคนอินพุตกับเอาต์พุต และตัวติดตามแบบเต็มพร้อมการหยุดเมื่อถึงงบประมาณอยู่ในติดตามต้นทุนโทเคนของ AI agent ใน Python
ไปป์ไลน์ LangChain หนึ่งวันมีค่าใช้จ่ายเท่าไร#
สมมติคุณรันบอทซัพพอร์ตที่มีตั๋ว 2,000 ใบต่อวัน แต่ละครั้งส่งตั๋วพร้อมพรอมป์ต์ประมาณ 3,000 โทเคน และคำตอบประมาณ 500 โทเคน บน MiniMax-M2.7 การเรียกหนึ่งครั้งมีค่าใช้จ่าย $0.00023 เลื่อนแถบเลื่อนเป็นตัวเลขของคุณเอง เว็บไซต์จะรวมให้ตามราคาปัจจุบัน:
เครื่องคำนวณค่าใช้จ่าย
หนึ่งวันของบอทซัพพอร์ต
โทเค็นอินพุตต่อคำขอ: 3,000 · โทเค็นเอาต์พุตต่อคำขอ: 500 · คำขอต่อวัน: 2,000
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
เครื่องคำนวณแสดงยอดรวมรายวัน: ในการเรียกแบบนี้ อินพุตเป็นส่วนใหญ่ของโทเคน และเอาต์พุตเป็นส่วนที่เล็กกว่า ด้วย CheapTokens ยอดรวมที่นับอินพุตและเอาต์พุตรวมกันออกมาต่ำกว่าของ OpenRouter และราคาเท่ากันทุกชั่วโมง: ไม่มีอัตราช่วงพีคให้ต้องวางแผน
คู่มือนี้ครอบคลุมอะไร#
ตัวอย่างใช้ chat completions แบบธรรมดา: invoke, stream และ usage_metadata ChatOpenAI ทำตามสเปก OpenAI ดังนั้นข้อความคำตอบอยู่ใน .content ตามเอกสารของ LangChain มันจะสลับไปใช้ Responses API เมื่อคุณใช้เครื่องมือในตัวหรือพารามิเตอร์ reasoning
หากการเรียกล้มเหลว สาเหตุมักเป็นหนึ่งในสามอย่าง: /v1 หายไปจาก base_url, ใช้ model id แบบสั้นแทนแบบเต็ม, หรือตัวแปรคีย์ไม่ได้ export ในเชลล์ที่รัน Python รายการข้อผิดพลาดการเชื่อมต่อที่พบบ่อย แสดงให้เห็นว่าแต่ละอย่างมีหน้าตาอย่างไร
ขั้นตอนถัดไป: รันบล็อกสามขั้นตอนด้านบนกับเชนของคุณเอง แล้วลองเชนเดียวกันบนendpoint ที่เข้ากันได้กับ OpenAI ด้วย model id อื่น


