API & SDKAnleitung
LangChain ChatOpenAI mit einer benutzerdefinierten base_url: CheapTokens in Python
Richten Sie LangChains ChatOpenAI auf CheapTokens aus: base_url, Schlüssel und Modell-ID in Python, dann invoke, Streaming und Token-Verbrauch pro Aufruf.
Auf dieser Seite
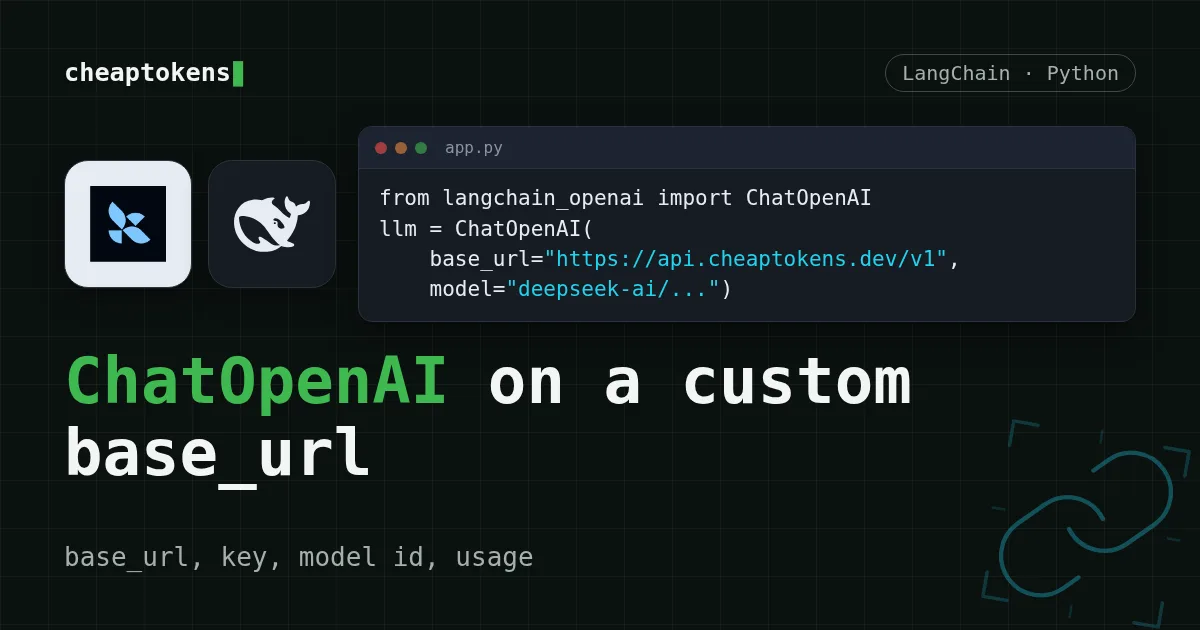
Sie haben bereits eine LangChain-Chain, die mit ChatOpenAI spricht, und möchten sie auf einem anderen Endpunkt ausführen, ohne sie neu zu schreiben. Das geht so: Übergeben Sie drei Argumente, base_url, api_key und model, und der Rest der Chain bleibt unverändert. CheapTokens spricht das OpenAI-Chat-Completions-Protokoll unter https:/, daher funktioniert ChatOpenAI direkt damit.
Die folgenden Schritte folgen der LangChain-ChatOpenAI-Dokumentation mit Stand vom 27. Oktober 2026. Die Seite zeigt kein Datum und keine Version, daher lege ich hier keine langchain-openai-Version fest: Installieren Sie die neueste.
Schritt für Schritt
LangChain in drei Schritten verbinden
Installieren
pip install -U langchain-openaiSchlüssel setzen
Bewahren Sie den Schlüssel in einer Umgebungsvariable auf, nicht in der Datei:
export CHEAPTOKENS_API_KEY="your-key"Modell aufrufen
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() gibt eine Nachricht zurück; .content ist der Antworttext. Das ist die gesamte Verbindung. Holen Sie sich einen Schlüssel und laden Sie das Guthaben in der CheapTokens-Dokumentation auf.
Welche Modell-ID in model gehört#
Verwenden Sie die vollständige ID mit dem Entwickler-Präfix. Ein Kurzname wie deepseek- ist das, was Sie in Preistabellen sehen; die API erwartet deepseek-. Die IDs aus der CheapTokens-Modellliste:
deepseek-: 380K Kontext, bis zu 32.768 Ausgabe-Tokens pro Antwort. Ein guter Standard für Chains mit langen Dokumenten und langen Antworten.ai/ DeepSeek- V4- Flash- 0731 zai-: 390K Kontext, bis zu 8.192 Ausgabe-Tokens.org/ GLM- 5. 3- Flash MiniMaxAI/: 180K Kontext, bis zu 8.192 Ausgabe-Tokens.MiniMax- M2. 7
Das Wechseln ist eine einzeilige Änderung, denn das Modell ist nur ein String:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
Alle drei teilen sich ein Guthaben, sodass Sie jedes auf derselben Chain ausprobieren können, ohne etwas Neues zu eröffnen. Aktuelle Preise finden Sie auf der Preisseite; für MiniMax-M2.7 beträgt der Input $0.05 und der Output $0.15 pro 1M Tokens.
base_url über die Umgebung setzen#
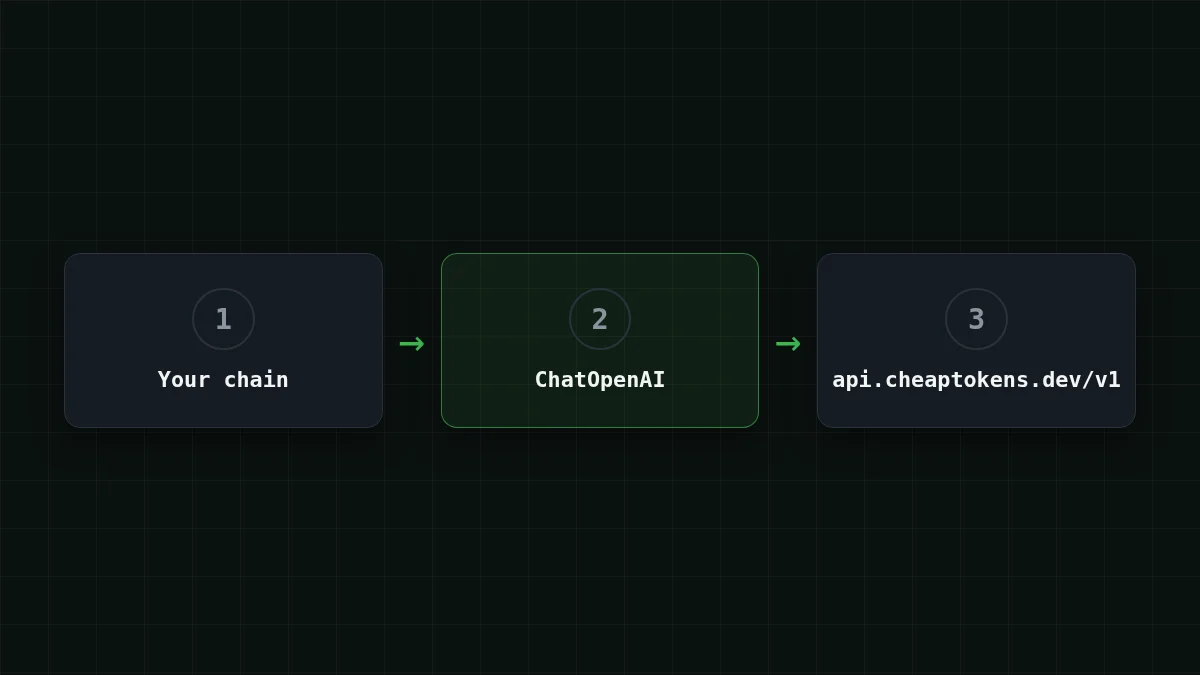
Wenn Sie den Code lieber nicht anfassen möchten, liest LangChain die Adresse aus der Umgebung. Die Dokumentation gibt die Rangfolge an:
- das Argument
base_url(oderopenai_api_base), das Sie im Code übergeben; OPENAI_API_BASE, das LangChain liest;OPENAI_BASE_URL, das dasopenai-SDK liest.
Kurzer Check
Sie setzen base_url im Code und exportieren zusätzlich OPENAI_BASE_URL mit einer anderen Adresse. Welche verwendet ChatOpenAI?
Antwort anzeigen
Antwort: Das base_url-Argument im Code
Das explizite Argument hat die höchste Priorität, dann OPENAI_API_BASE, dann OPENAI_BASE_URL. Eine vergessene Variable in Ihrer Shell leitet einen Aufruf, der base_url explizit setzt, nicht um.
Ein Nebeneffekt aus derselben Dokumentationsseite: Wenn OPENAI_BASE_URL gesetzt ist, lässt LangChain stream_usage standardmäßig weg. Das ist in den nächsten beiden Abschnitten wichtig.
Die Antwort streamen#
Für eine UI möchten Sie Text, sobald er eintrifft. stream() liefert Chunks, und jeder Chunk hat ein .content-Stück:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
Das reicht für ein Chat-Fenster. Wenn Sie am Ende eines Streams auch die Token-Anzahl möchten, übergeben Sie stream_: ChatOpenAI(.. Diese Anleitung zählt Tokens aus invoke(), wie im nächsten Abschnitt. Streaming im reinen OpenAI-SDK wird in Streaming responses in Python behandelt.
Token-Verbrauch pro Aufruf lesen#
Jede von invoke() zurückgegebene Nachricht trägt usage_metadata mit den Tokens, die der Aufruf verbraucht hat:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
Summieren Sie diese über eine Pipeline und Sie haben ein Budget pro Lauf:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
Input und Output werden getrennt bepreist, daher sollten Sie beide Zahlen behalten. Warum diese Aufteilung existiert, steht in Input vs output tokens, und ein vollständiger Tracker mit einer Stopp-bei-Budget-Sicherung ist in Track AI agent token cost in Python zu finden.
Was eine LangChain-Pipeline pro Tag kostet#
Angenommen, Sie betreiben einen Support-Bot mit 2.000 Tickets pro Tag. Jeder Aufruf sendet das Ticket plus einen Prompt, etwa 3.000 Tokens, und die Antwort umfasst etwa 500 Tokens. Bei MiniMax-M2.7 kostet ein solcher Aufruf $0.00023. Verschieben Sie die Schieberegler auf Ihre eigenen Zahlen; die Seite summiert sie zu den aktuellen Preisen:
Kostenrechner
Ein Tag des Support-Bots
Eingabe-Tokens pro Anfrage: 3.000 · Ausgabe-Tokens pro Anfrage: 500 · Anfragen pro Tag: 2.000
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
Der Rechner zeigt die Tagessumme: Bei dieser Art von Aufruf macht der Input den Großteil der Tokens aus und der Output den kleineren Teil. Bei CheapTokens liegt die Gesamtsumme, Input und Output zusammengerechnet, unter der von OpenRouter, und der Preis ist zu jeder Stunde gleich: Es gibt keine Spitzenzeiten-Tarife, um die Sie herumplanen müssen.
Was diese Anleitung abdeckt#
Das Beispiel verwendet einfache Chat-Completions: invoke, stream und usage_metadata. ChatOpenAI folgt der OpenAI-Spezifikation, daher steht der Antworttext in .content. Laut der LangChain-Dokumentation wechselt es zur Responses-API, wenn Sie integrierte Tools oder den Parameter reasoning verwenden.
Wenn ein Aufruf fehlschlägt, ist die Ursache meist eine von drei Dingen: /v1 fehlt in base_url, eine kurze Modell-ID statt der vollständigen, oder die Schlüsselvariable ist nicht in der Shell exportiert, die Python ausführt. Die Liste der häufigen Verbindungsfehler zeigt, wie jeder aussieht.
Nächster Schritt: Führen Sie den dreistufigen Block oben mit Ihrer eigenen Chain aus und probieren Sie dann dieselbe Chain auf OpenAI-kompatiblen Endpunkten mit einer anderen Modell-ID aus.


