API & SDKPanduan
LangChain ChatOpenAI dengan base_url kustom: CheapTokens di Python
Arahkan ChatOpenAI dari LangChain ke CheapTokens: base_url, kunci dan id model di Python, lalu invoke, streaming dan penggunaan token per panggilan.
Di halaman ini
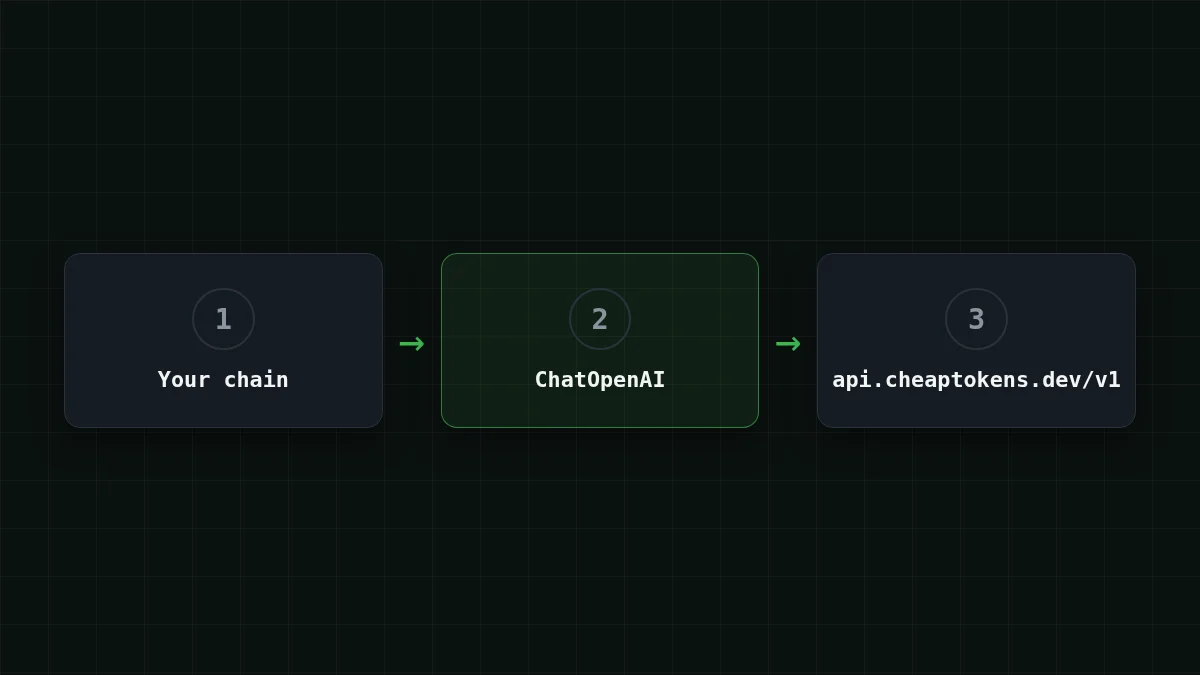
Anda sudah memiliki rantai LangChain yang berbicara dengan ChatOpenAI, dan Anda ingin menjalankannya di endpoint lain tanpa menulis ulang. Anda bisa: berikan tiga argumen, base_url, api_key dan model, dan sisa rantai tetap seperti semula. CheapTokens berbicara protokol OpenAI Chat Completions di https:/, jadi ChatOpenAI bekerja dengannya secara langsung.
Langkah-langkah di bawah mengikuti dokumentasi LangChain ChatOpenAI sebagaimana diperiksa pada 27 Oktober 2026. Halaman tersebut tidak menampilkan tanggal atau versi, jadi saya tidak mematok rilis langchain-openai di sini: pasang versi terbaru.
Langkah demi langkah
Hubungkan LangChain dalam tiga langkah
Pasang
pip install -U langchain-openaiAtur kunci
Simpan kunci di variabel lingkungan, bukan di file:
export CHEAPTOKENS_API_KEY="your-key"Panggil model
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() mengembalikan sebuah pesan; .content adalah teks jawabannya. Itulah keseluruhan koneksinya. Dapatkan kunci dan isi ulang saldo di dokumentasi CheapTokens.
Id model mana yang masuk ke model#
Gunakan id lengkap, dengan prefiks pengembang. Nama pendek seperti deepseek- adalah yang Anda lihat di tabel harga; API menerima deepseek-. Id dari daftar model CheapTokens:
deepseek-: konteks 380K, hingga 32.768 token keluaran per jawaban. Default yang baik untuk rantai dengan dokumen panjang dan jawaban panjang.ai/ DeepSeek- V4- Flash- 0731 zai-: konteks 390K, hingga 8.192 token keluaran.org/ GLM- 5. 3- Flash MiniMaxAI/: konteks 180K, hingga 8.192 token keluaran.MiniMax- M2. 7
Berganti model cukup dengan perubahan satu baris, karena model hanyalah sebuah string:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
Ketiganya berbagi satu saldo, jadi Anda bisa mencoba masing-masing pada rantai yang sama tanpa membuka apa pun yang baru. Harga terkini ada di halaman harga; untuk MiniMax-M2.7 input adalah $0.05 dan output $0.15 per 1M token.
Mengatur base_url melalui lingkungan#
Jika Anda lebih suka tidak menyentuh kode, LangChain membaca alamat dari lingkungan. Dokumentasi memberikan urutan prioritas:
- argumen
base_url(atauopenai_api_base) yang Anda berikan di kode; OPENAI_API_BASE, yang dibaca LangChain;OPENAI_BASE_URL, yang dibaca SDKopenai.
Cek cepat
Anda mengatur base_url di kode dan juga mengekspor OPENAI_BASE_URL dengan alamat lain. Mana yang digunakan ChatOpenAI?
Tampilkan jawaban
Jawaban: Argumen base_url di kode
Argumen eksplisit memiliki prioritas tertinggi, lalu OPENAI_API_BASE, lalu OPENAI_BASE_URL. Variabel yang terlupakan di shell Anda tidak akan mengalihkan panggilan yang mengatur base_url secara eksplisit.
Satu efek samping dari halaman dokumentasi yang sama: ketika OPENAI_BASE_URL diatur, LangChain membiarkan stream_usage nonaktif secara default. Itu penting di dua bagian berikutnya.
Streaming jawaban#
Untuk UI Anda ingin teks saat tiba. stream() menghasilkan potongan, dan setiap potongan memiliki bagian .content:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
Itu cukup untuk jendela chat. Jika Anda juga ingin jumlah token di akhir stream, berikan stream_: ChatOpenAI(.. Panduan ini menghitung token dari invoke(), seperti di bagian berikutnya. Streaming di SDK OpenAI biasa dibahas di Streaming respons di Python.
Membaca penggunaan token per panggilan#
Setiap pesan yang dikembalikan oleh invoke() membawa usage_metadata dengan token yang digunakan panggilan tersebut:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
Jumlahkan ini di seluruh pipeline dan Anda memiliki anggaran per eksekusi:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
Input dan output diberi harga terpisah, jadi simpan kedua angka. Mengapa pemisahan itu ada dijelaskan di Token input vs output, dan pelacak lengkap dengan pengaman berhenti-saat-anggaran ada di Lacak biaya token agen AI di Python.
Berapa biaya pipeline LangChain per hari#
Katakanlah Anda menjalankan bot dukungan dengan 2.000 tiket sehari. Setiap panggilan mengirim tiket plus prompt, sekitar 3.000 token, dan jawabannya sekitar 500 token. Pada MiniMax-M2.7 satu panggilan seperti itu berbiaya $0.00023. Geser slider ke angka Anda sendiri; situs menjumlahkannya pada harga terkini:
Kalkulator biaya
Satu hari bot dukungan
Token input per permintaan: 3.000 · Token output per permintaan: 500 · Permintaan per hari: 2.000
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
Kalkulator menampilkan jumlah harian: dalam jenis panggilan ini, input adalah bagian terbesar dari token dan output bagian yang lebih kecil. Dengan CheapTokens, totalnya, input dan output dihitung bersama, keluar lebih rendah daripada OpenRouter, dan harganya sama di jam berapa pun: tidak ada tarif jam sibuk yang perlu direncanakan.
Cakupan panduan ini#
Contoh menggunakan chat completions biasa: invoke, stream dan usage_metadata. ChatOpenAI mengikuti spesifikasi OpenAI, jadi teks jawabannya ada di .content. Menurut dokumentasi LangChain, ia beralih ke Responses API saat Anda menggunakan alat bawaan atau parameter reasoning.
Jika panggilan gagal, penyebabnya biasanya salah satu dari tiga hal: /v1 hilang dari base_url, id model pendek alih-alih yang lengkap, atau variabel kunci tidak diekspor di shell yang menjalankan Python. Daftar kesalahan koneksi umum menunjukkan seperti apa masing-masingnya.
Langkah berikutnya: jalankan blok tiga langkah di atas dengan rantai Anda sendiri, lalu coba rantai yang sama pada endpoint yang kompatibel dengan OpenAI dengan id model yang berbeda.


