API ও SDKগাইড
কাস্টম base_url সহ LangChain ChatOpenAI: Python-এ CheapTokens
LangChain-এর ChatOpenAI-কে CheapTokens-এ নির্দেশ করুন: Python-এ base_url, কী এবং মডেল আইডি, তারপর invoke, স্ট্রিমিং এবং প্রতি কলে টোকেন ব্যবহার।
এই পৃষ্ঠায়
আপনার ইতিমধ্যে একটি LangChain চেইন আছে যা ChatOpenAI-এর সাথে কথা বলে, এবং আপনি এটি পুনরায় না লিখে অন্য একটি এন্ডপয়েন্টে চালাতে চান। আপনি করতে পারেন: তিনটি আর্গুমেন্ট পাস করুন, base_url, api_key এবং model, এবং চেইনের বাকি অংশ অপরিবর্তিত থাকবে। CheapTokens https:/-এ OpenAI Chat Completions প্রোটোকল ব্যবহার করে, তাই ChatOpenAI সরাসরি এটির সাথে কাজ করে।
নিচের ধাপগুলো LangChain ChatOpenAI ডকুমেন্টেশন অনুসরণ করে যা ২৭ অক্টোবর ২০২৬-এ যাচাই করা হয়েছে। পৃষ্ঠাটি কোনো তারিখ বা সংস্করণ দেখায় না, তাই আমি এখানে কোনো langchain-openai রিলিজ পিন করছি না: সর্বশেষটি ইনস্টল করুন।
ধাপে ধাপে
তিনটি ধাপে LangChain সংযুক্ত করুন
ইনস্টল
pip install -U langchain-openaiকী সেট করুন
কীটি ফাইলে নয়, একটি এনভায়রনমেন্ট ভেরিয়েবলে রাখুন:
export CHEAPTOKENS_API_KEY="your-key"মডেল কল করুন
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() একটি মেসেজ রিটার্ন করে; .content হলো উত্তর টেক্সট। এটাই সম্পূর্ণ সংযোগ। CheapTokens ডকুমেন্টেশন-এ একটি কী নিন এবং ব্যালেন্স টপ আপ করুন।
model-এ কোন মডেল আইডি যাবে#
ডেভেলপার প্রিফিক্সসহ সম্পূর্ণ আইডি ব্যবহার করুন। deepseek--এর মতো একটি সংক্ষিপ্ত নাম আপনি মূল্য সারণিতে দেখেন; API deepseek- নেয়। CheapTokens মডেল তালিকা থেকে আইডিগুলো:
deepseek-: ৩৮০K কনটেক্সট, প্রতি উত্তরে সর্বোচ্চ ৩২,৭৬৮ আউটপুট টোকেন। দীর্ঘ ডকুমেন্ট ও দীর্ঘ উত্তরযুক্ত চেইনের জন্য একটি ভালো ডিফল্ট।ai/ DeepSeek- V4- Flash- 0731 zai-: ৩৯০K কনটেক্সট, সর্বোচ্চ ৮,১৯২ আউটপুট টোকেন।org/ GLM- 5. 3- Flash MiniMaxAI/: ১৮০K কনটেক্সট, সর্বোচ্চ ৮,১৯২ আউটপুট টোকেন।MiniMax- M2. 7
স্যুইচিং এক লাইনের পরিবর্তন, কারণ মডেলটি শুধু একটি স্ট্রিং:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
তিনটিই একটি ব্যালেন্স শেয়ার করে, তাই নতুন কিছু না খুলেই আপনি একই চেইনে প্রতিটি চেষ্টা করতে পারেন। বর্তমান মূল্য মূল্য পৃষ্ঠা-এ আছে; MiniMax-M2.7-এর জন্য ইনপুট $0.05 এবং আউটপুট $0.15 প্রতি ১M টোকেনে।
এনভায়রনমেন্টের মাধ্যমে base_url সেট করা#
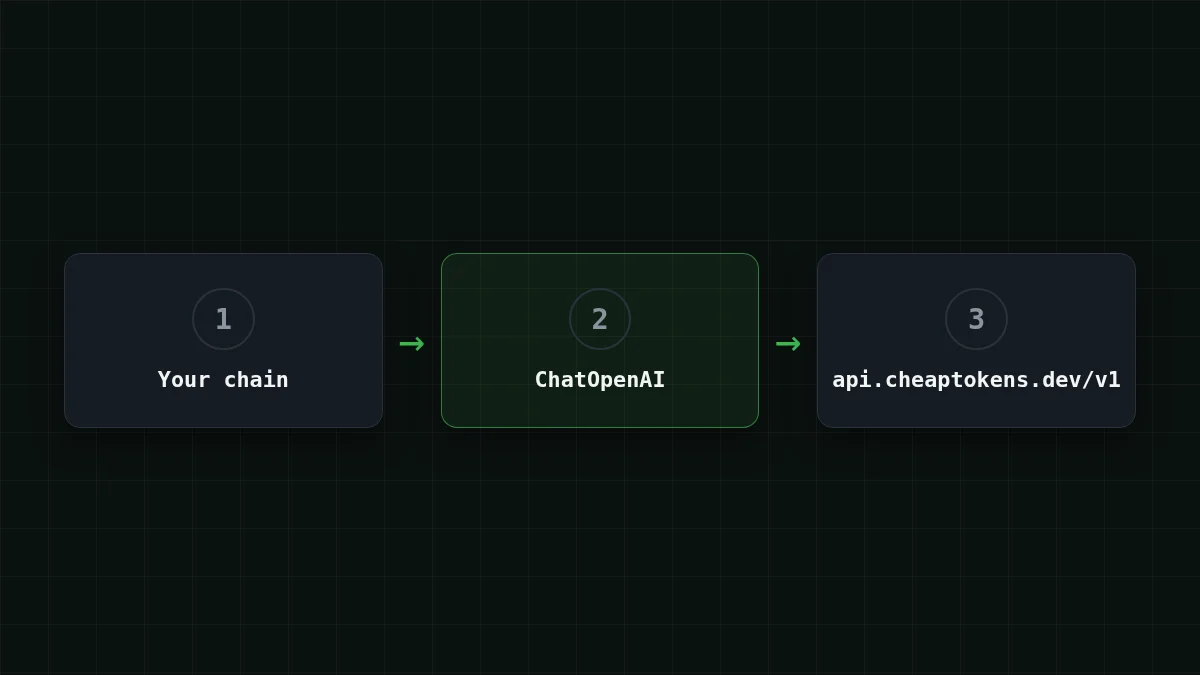
আপনি যদি কোড স্পর্শ করতে না চান, LangChain এনভায়রনমেন্ট থেকে ঠিকানাটি পড়ে। ডকুমেন্টেশন অগ্রাধিকারের ক্রম দেয়:
- কোডে আপনি যে
base_url(বাopenai_api_base) আর্গুমেন্ট পাস করেন; OPENAI_API_BASE, যা LangChain পড়ে;OPENAI_BASE_URL, যাopenaiSDK পড়ে।
দ্রুত যাচাই
আপনি কোডে base_url সেট করেছেন এবং অন্য একটি ঠিকানা দিয়ে OPENAI_BASE_URL-ও এক্সপোর্ট করেছেন। ChatOpenAI কোনটি ব্যবহার করে?
উত্তর দেখান
উত্তর: কোডে base_url আর্গুমেন্ট
স্পষ্ট আর্গুমেন্টের সর্বোচ্চ অগ্রাধিকার, তারপর OPENAI_API_BASE, তারপর OPENAI_BASE_URL। আপনার শেলে ভুলে যাওয়া একটি ভেরিয়েবল এমন একটি কলকে পুনর্নির্দেশ করবে না যা base_url স্পষ্টভাবে সেট করে।
একই ডকুমেন্টেশন পৃষ্ঠা থেকে একটি পার্শ্বপ্রতিক্রিয়া: যখন OPENAI_BASE_URL সেট থাকে, LangChain ডিফল্টভাবে stream_usage বন্ধ রাখে। এটি পরবর্তী দুটি বিভাগে গুরুত্বপূর্ণ।
উত্তর স্ট্রিমিং#
একটি UI-এর জন্য আপনি টেক্সট আসার সাথে সাথে চান। stream() চাঙ্ক দেয়, এবং প্রতিটি চাঙ্কে একটি .content অংশ থাকে:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
একটি চ্যাট উইন্ডোর জন্য এটি যথেষ্ট। আপনি যদি স্ট্রিমের শেষে টোকেন সংখ্যাও চান, stream_ পাস করুন: ChatOpenAI(.। এই গাইড invoke() থেকে টোকেন গণনা করে, যেমন পরবর্তী বিভাগে। সাধারণ OpenAI SDK-তে স্ট্রিমিং Python-এ স্ট্রিমিং রেসপন্স-এ আলোচনা করা হয়েছে।
প্রতি কলে টোকেন ব্যবহার পড়া#
invoke() দ্বারা রিটার্ন করা প্রতিটি মেসেজ usage_metadata বহন করে যা কলটি যে টোকেন ব্যবহার করেছে তা দেখায়:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
একটি পাইপলাইনে এগুলো যোগ করুন এবং আপনার প্রতি-রান বাজেট তৈরি হবে:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
ইনপুট ও আউটপুট আলাদাভাবে মূল্যায়ন করা হয়, তাই উভয় সংখ্যা রাখুন। এই বিভাজন কেন আছে তা ইনপুট বনাম আউটপুট টোকেন-এ, এবং বাজেটে থামার গার্ডসহ একটি সম্পূর্ণ ট্র্যাকার Python-এ AI এজেন্ট টোকেন খরচ ট্র্যাক করুন-এ আছে।
একটি LangChain পাইপলাইনের দৈনিক খরচ#
ধরুন আপনি প্রতিদিন ২,০০০ টিকেটের একটি সাপোর্ট বট চালান। প্রতিটি কল টিকেট প্লাস একটি প্রম্পট পাঠায়, প্রায় ৩,০০০ টোকেন, এবং উত্তর প্রায় ৫০০ টোকেন। MiniMax-M2.7-এ এমন একটি কলের খরচ $0.00023। স্লাইডারগুলো আপনার নিজের সংখ্যায় সরান; সাইটটি বর্তমান মূল্যে এটি যোগ করে:
খরচ ক্যালকুলেটর
সাপোর্ট বটের এক দিন
প্রতি অনুরোধে ইনপুট টোকেন: ৩,০০০ · প্রতি অনুরোধে আউটপুট টোকেন: ৫০০ · প্রতিদিন অনুরোধ: ২,০০০
| মডেল | প্রতিদিন | প্রতি মাসে |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
ক্যালকুলেটর দৈনিক যোগফল দেখায়: এই ধরনের কলে, ইনপুটই টোকেনের বড় অংশ এবং আউটপুট ছোট অংশ। CheapTokens-এ মোট, ইনপুট ও আউটপুট একসাথে গণনা করে, OpenRouter-এর চেয়ে কম আসে, এবং মূল্য যেকোনো সময় একই: পরিকল্পনা করার জন্য কোনো পিক-টাইম রেট নেই।
এই গাইড কী কভার করে#
উদাহরণটি সাধারণ চ্যাট কমপ্লিশন ব্যবহার করে: invoke, stream এবং usage_metadata। ChatOpenAI OpenAI স্পেক অনুসরণ করে, তাই উত্তর টেক্সট .content-এ থাকে। LangChain-এর ডকুমেন্টেশন অনুযায়ী, আপনি বিল্ট-ইন টুল বা reasoning প্যারামিটার ব্যবহার করলে এটি Responses API-তে স্যুইচ করে।
যদি একটি কল ব্যর্থ হয়, কারণ সাধারণত তিনটির একটি: base_url-এ /v1 অনুপস্থিত, সম্পূর্ণটির বদলে একটি সংক্ষিপ্ত মডেল আইডি, বা যে শেল Python চালায় সেখানে কী ভেরিয়েবল এক্সপোর্ট করা হয়নি। সাধারণ সংযোগ ত্রুটি তালিকা দেখায় প্রতিটি কেমন দেখায়।
পরবর্তী ধাপ: আপনার নিজের চেইন দিয়ে উপরের তিন-ধাপের ব্লকটি চালান, তারপর ভিন্ন একটি মডেল আইডি দিয়ে OpenAI-সামঞ্জস্যপূর্ণ এন্ডপয়েন্ট-এ একই চেইন চেষ্টা করুন।


