API اور SDKگائیڈ
کسٹم base_url کے ساتھ LangChain ChatOpenAI: Python میں CheapTokens
LangChain کے ChatOpenAI کو CheapTokens کی طرف اشارہ کریں: Python میں base_url، کلید اور ماڈل آئی ڈی، پھر انووک، اسٹریمنگ اور فی کال ٹوکن استعمال۔
اس صفحہ پر
آپ کے پاس پہلے سے ایک LangChain چین ہے جو ChatOpenAI سے بات کرتا ہے، اور آپ چاہتے ہیں کہ یہ کسی دوسرے اینڈ پوائنٹ پر چلے بغیر اسے دوبارہ لکھے۔ آپ کر سکتے ہیں: تین آرگیومنٹس پاس کریں، base_url، api_key اور model، اور باقی چین ویسا ہی رہتا ہے۔ CheapTokens https:/ پر OpenAI Chat Completions پروٹوکول بولتا ہے، لہذا ChatOpenAI اس کے ساتھ براہ راست کام کرتا ہے۔
نیچے دیے گئے مراحل LangChain ChatOpenAI دستاویزات کی پیروی کرتے ہیں جیسا کہ 27 اکتوبر 2026 کو چیک کیا گیا تھا۔ صفحہ کوئی تاریخ یا ورژن نہیں دکھاتا، اس لیے میں یہاں langchain-openai ریلیز کو پن نہیں کرتا: تازہ ترین انسٹال کریں۔
قدم بہ قدم
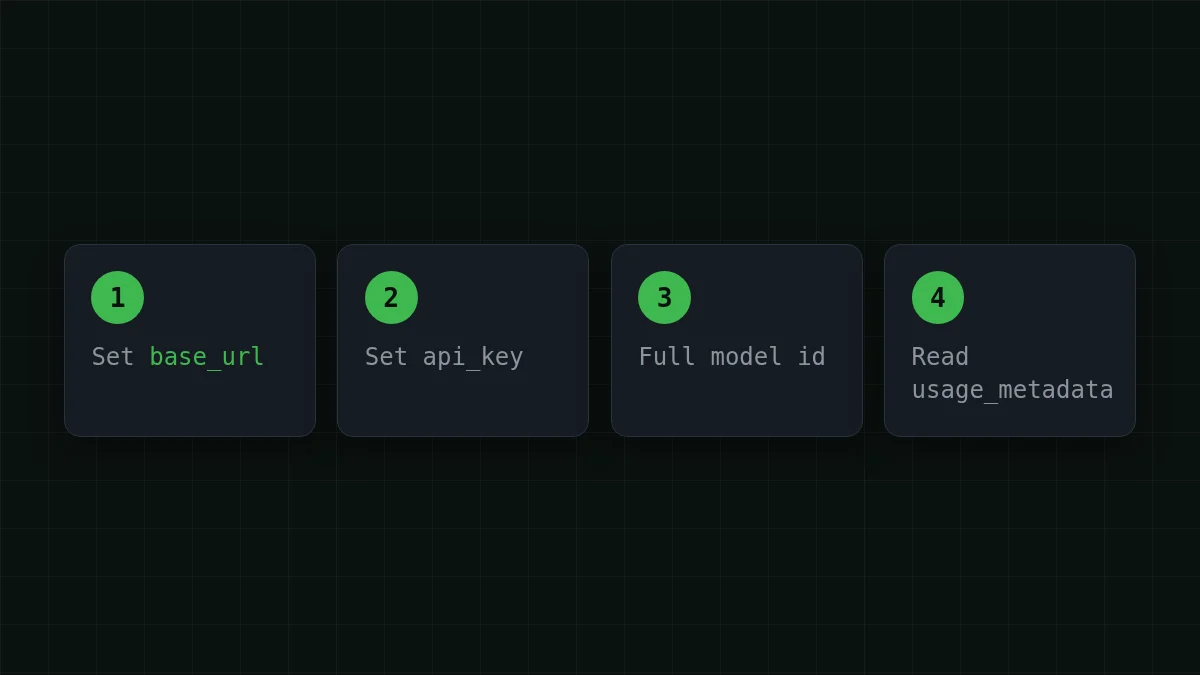
LangChain کو تین مراحل میں جوڑیں
انسٹال کریں
pip install -U langchain-openaiکلید سیٹ کریں
کلید کو ماحول کے متغیر میں رکھیں، فائل میں نہیں:
export CHEAPTOKENS_API_KEY="your-key"ماڈل کو کال کریں
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() ایک پیغام واپس کرتا ہے؛ .content جواب کا متن ہے۔ یہی پورا کنکشن ہے۔ CheapTokens دستاویزات میں کلید حاصل کریں اور بیلنس ٹاپ اپ کریں۔
model میں کون سی ماڈل آئی ڈی جاتی ہے#
مکمل آئی ڈی استعمال کریں، ڈویلپر پریفکس کے ساتھ۔ deepseek- جیسا مختصر نام وہ ہے جو آپ قیمت کے جدولوں میں دیکھتے ہیں؛ API deepseek- لیتا ہے۔ CheapTokens ماڈل فہرست سے آئی ڈیز:
deepseek-: 380K سیاق و سباق، فی جواب زیادہ سے زیادہ 32,768 آؤٹ پٹ ٹوکن۔ لمبی دستاویزات اور لمبے جوابات والی چینز کے لیے اچھا ڈیفالٹ۔ai/ DeepSeek- V4- Flash- 0731 zai-: 390K سیاق و سباق، زیادہ سے زیادہ 8,192 آؤٹ پٹ ٹوکن۔org/ GLM- 5. 3- Flash MiniMaxAI/: 180K سیاق و سباق، زیادہ سے زیادہ 8,192 آؤٹ پٹ ٹوکن۔MiniMax- M2. 7
سوئچ کرنا ایک لائن کی تبدیلی ہے، کیونکہ ماڈل صرف ایک سٹرنگ ہے:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
تینوں ایک ہی بیلنس شیئر کرتے ہیں، لہذا آپ کچھ نیا کھولے بغیر اسی چین پر ہر ایک کو آزما سکتے ہیں۔ موجودہ قیمتیں قیمتوں کے صفحے پر ہیں؛ MiniMax-M2.7 کے لیے ان پٹ $0.05 اور آؤٹ پٹ $0.15 فی 1M ٹوکن ہے۔
ماحول کے ذریعے base_url سیٹ کرنا#
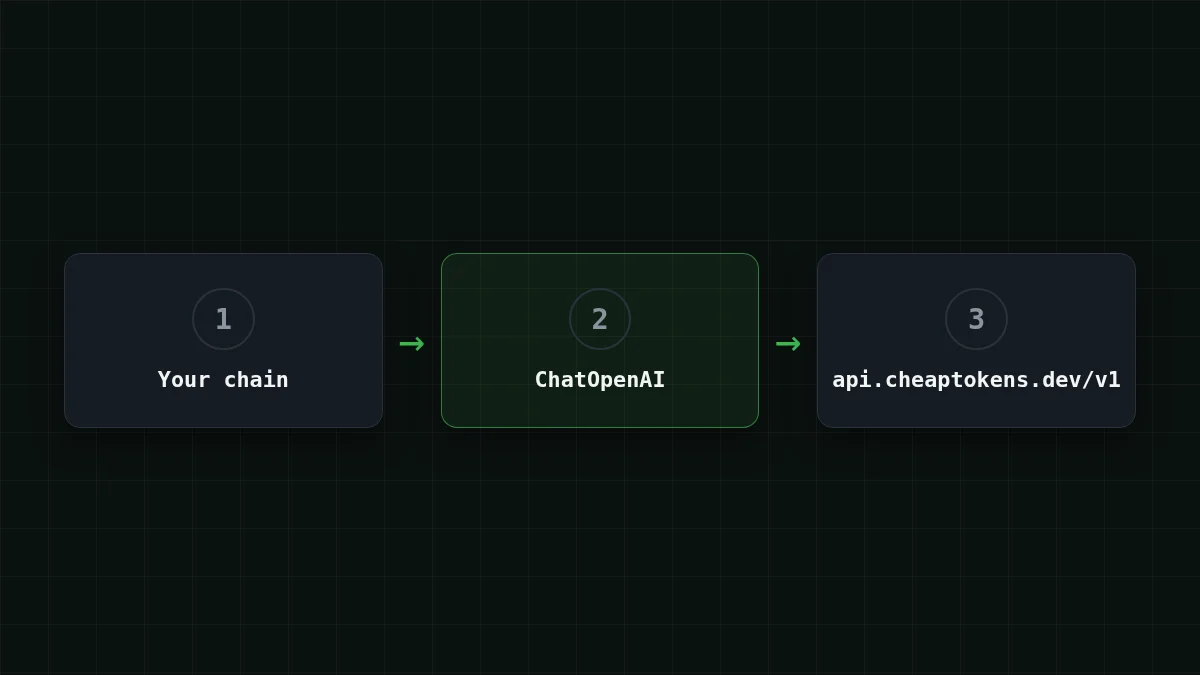
اگر آپ کوڈ کو چھونا نہیں چاہتے، تو LangChain ماحول سے پتہ پڑھتا ہے۔ دستاویزات ترجیح کا ترتیب دیتی ہیں:
base_url(یاopenai_api_base) آرگیومنٹ جو آپ کوڈ میں پاس کرتے ہیں؛OPENAI_API_BASE، جسے LangChain پڑھتا ہے؛OPENAI_BASE_URL، جسےopenaiSDK پڑھتا ہے۔
فوری جانچ
آپ کوڈ میں base_url سیٹ کرتے ہیں اور OPENAI_BASE_URL کو کسی دوسرے پتے کے ساتھ ایکسپورٹ بھی کرتے ہیں۔ ChatOpenAI کون سا استعمال کرتا ہے؟
جواب دکھائیں
جواب: کوڈ میں base_url آرگیومنٹ
واضح آرگیومنٹ کی سب سے زیادہ ترجیح ہے، پھر OPENAI_API_BASE، پھر OPENAI_BASE_URL۔ آپ کے شیل میں بھولا ہوا متغیر اس کال کو ری ڈائریکٹ نہیں کرے گا جو base_url کو واضح طور پر سیٹ کرتا ہے۔
اسی دستاویزات کے صفحے سے ایک ضمنی اثر: جب OPENAI_BASE_URL سیٹ ہوتا ہے، تو LangChain stream_usage کو بطور ڈیفالٹ بند چھوڑ دیتا ہے۔ یہ اگلے دو حصوں میں اہم ہے۔
جواب کو اسٹریم کرنا#
UI کے لیے آپ متن چاہتے ہیں جیسے ہی وہ آتا ہے۔ stream() چنکس دیتا ہے، اور ہر چنک میں .content کا ٹکڑا ہوتا ہے:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
یہ چیٹ ونڈو کے لیے کافی ہے۔ اگر آپ اسٹریم کے آخر میں ٹوکن کی گنتی بھی چاہتے ہیں، تو stream_ پاس کریں: ChatOpenAI(.۔ یہ گائیڈ invoke() سے ٹوکن گنتا ہے، جیسا کہ اگلے حصے میں ہے۔ سادہ OpenAI SDK میں اسٹریمنگ Python میں اسٹریمنگ جوابات میں شامل ہے۔
فی کال ٹوکن استعمال پڑھنا#
invoke() کے ذریعے واپس کردہ ہر پیغام میں usage_metadata ہوتا ہے جس میں کال کے استعمال کردہ ٹوکن ہوتے ہیں:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
انہیں پائپ لائن میں جمع کریں اور آپ کے پاس فی رن بجٹ ہوگا:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
ان پٹ اور آؤٹ پٹ کی قیمت الگ الگ ہے، لہذا دونوں نمبر رکھیں۔ یہ تقسیم کیوں ہے اس کا ذکر ان پٹ بمقابلہ آؤٹ پٹ ٹوکن میں ہے، اور بجٹ پر رکنے والے گارڈ کے ساتھ مکمل ٹریکر Python میں AI ایجنٹ ٹوکن لاگت ٹریک کریں میں ہے۔
LangChain پائپ لائن کی روزانہ لاگت#
فرض کریں آپ روزانہ 2,000 ٹکٹوں کے ساتھ سپورٹ بوٹ چلاتے ہیں۔ ہر کال ٹکٹ کے ساتھ ایک پرامپٹ بھیجتی ہے، تقریباً 3,000 ٹوکن، اور جواب تقریباً 500 ٹوکن ہے۔ MiniMax-M2.7 پر ایسی ایک کال کی لاگت $0.00023 ہے۔ سلائیڈرز کو اپنے نمبروں پر منتقل کریں؛ سائٹ موجودہ قیمتوں پر اسے جمع کرتی ہے:
لاگت کیلکولیٹر
سپورٹ بوٹ کا ایک دن
فی درخواست ان پٹ ٹوکنز: 3,000 · فی درخواست آؤٹ پٹ ٹوکنز: 500 · فی دن درخواستیں: 2,000
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
کیلکولیٹر روزانہ کا مجموعہ دکھاتا ہے: اس قسم کی کال میں، ان پٹ ٹوکن کا بڑا حصہ ہے اور آؤٹ پٹ چھوٹا حصہ۔ CheapTokens کے ساتھ کل، ان پٹ اور آؤٹ پٹ ملا کر، OpenRouter سے کم آتا ہے، اور قیمت کسی بھی وقت یکساں ہے: کوئی پیک ٹائم ریٹس نہیں ہیں جن کے گرد منصوبہ بندی کرنی ہو۔
یہ گائیڈ کیا احاطہ کرتی ہے#
مثال سادہ چیٹ کمپلیشنز استعمال کرتی ہے: invoke، stream اور usage_metadata۔ ChatOpenAI OpenAI تفصیلات کی پیروی کرتا ہے، لہذا جواب کا متن .content میں ہے۔ LangChain کی دستاویزات کے مطابق، یہ Responses API پر سوئچ کرتا ہے جب آپ بلٹ ان ٹولز یا reasoning پیرامیٹر استعمال کرتے ہیں۔
اگر کوئی کال ناکام ہوتی ہے، تو وجہ عام طور پر تین چیزوں میں سے ایک ہوتی ہے: /v1 base_url سے غائب، مکمل کے بجائے مختصر ماڈل آئی ڈی، یا کلید کا متغیر اس شیل میں ایکسپورٹ نہیں کیا گیا جو Python چلاتا ہے۔ عام کنکشن غلطیاں کی فہرست دکھاتی ہے کہ ہر ایک کیسی دکھتی ہے۔
اگلا قدم: اوپر والا تین مرحلوں کا بلاک اپنی چین کے ساتھ چلائیں، پھر وہی چین OpenAI-مطابق اینڈ پوائنٹس پر مختلف ماڈل آئی ڈی کے ساتھ آزمائیں۔


