使用自定义 base_url 的 LangChain ChatOpenAI:Python 中的 CheapTokens
将 LangChain 的 ChatOpenAI 指向 CheapTokens:在 Python 中设置 base_url、密钥和模型 id,然后调用、流式输出并查看每次调用的 token 用量。
你已有一个与 ChatOpenAI 通信的 LangChain 链,想让它运行在另一个端点上而无需重写。你可以:传入三个参数 base_url、api_key 和 model,链的其余部分保持不变。CheapTokens 在 https:/ 上使用 OpenAI Chat Completions 协议,因此 ChatOpenAI 可直接与之配合。
以下步骤依据 LangChain ChatOpenAI 文档,核对日期为 2026 年 10 月 27 日。该页面未显示日期或版本,因此我不在此固定 langchain-openai 版本:请安装最新版。
分步操作
三步连接 LangChain
安装
pip install -U langchain-openai设置密钥
将密钥保存在环境变量中,而不是文件中:
export CHEAPTOKENS_API_KEY="your-key"调用模型
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() 返回一条消息;.content 是回答文本。连接就这么多。在 CheapTokens 文档 中获取密钥并充值余额。
model 中应填哪个模型 id#
使用带开发者前缀的完整 id。像 deepseek- 这样的短名称是你在价格表中看到的;API 接受的是 deepseek-。CheapTokens 模型列表中的 id:
deepseek-:380K 上下文,每次回答最多 32,768 个输出 token。对于包含长文档和长回答的链来说是个不错的默认选择。ai/ DeepSeek- V4- Flash- 0731 zai-:390K 上下文,最多 8,192 个输出 token。org/ GLM- 5. 3- Flash MiniMaxAI/:180K 上下文,最多 8,192 个输出 token。MiniMax- M2. 7
切换只需改一行,因为模型只是一个字符串:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
三者共享一个余额,因此你可以在同一条链上试用每一个,而无需新开任何东西。当前价格见 价格页面;对于 MiniMax-M2.7,输入为每 1M token $0.05,输出为 $0.15。
通过环境变量设置 base_url#
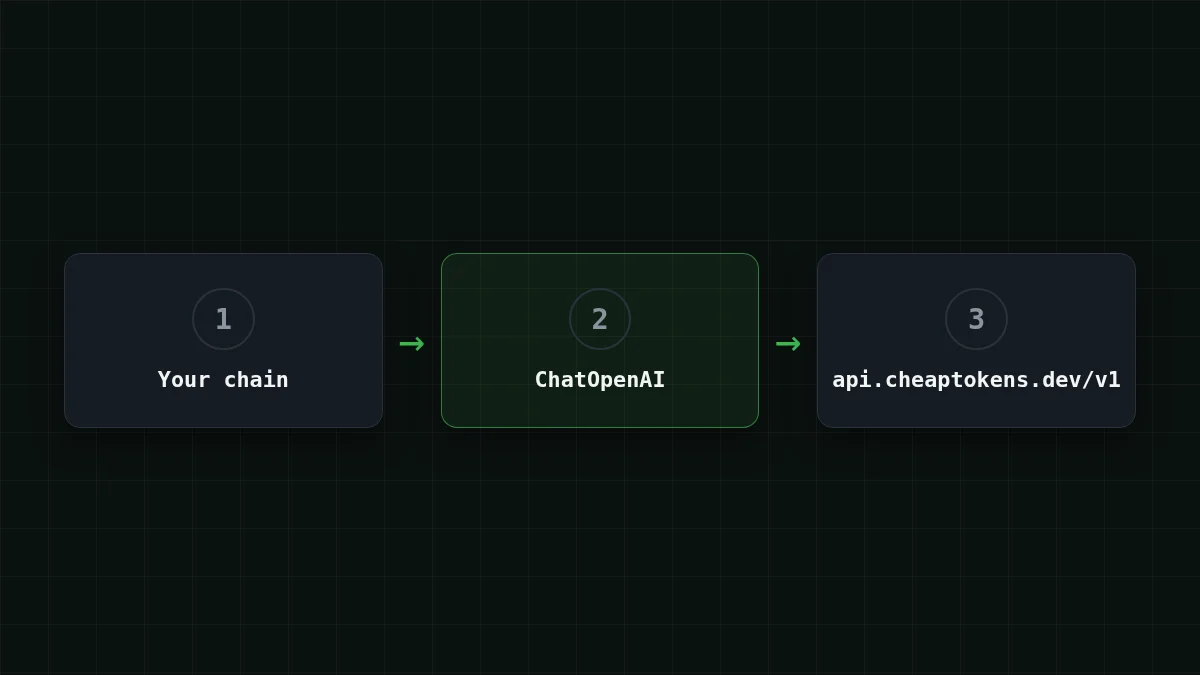
如果你不想改动代码,LangChain 会从环境变量读取地址。文档给出了优先级顺序:
- 你在代码中传入的
base_url(或openai_api_base)参数; OPENAI_API_BASE,LangChain 会读取它;OPENAI_BASE_URL,openaiSDK 会读取它。
快速检查
你在代码中设置了 base_url,同时还导出了指向另一个地址的 OPENAI_BASE_URL。ChatOpenAI 会使用哪一个?
显示答案
答案: 代码中的 base_url 参数
显式参数优先级最高,其次是 OPENAI_API_BASE,然后是 OPENAI_BASE_URL。shell 中遗留的变量不会重定向显式设置了 base_url 的调用。
同一文档页面的一个副作用:当设置了 OPENAI_BASE_URL 时,LangChain 默认不启用 stream_usage。这在接下来两节中很重要。
流式输出回答#
对于 UI,你希望文本随到随显。stream() 会产出块,每个块包含一段 .content:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
这对聊天窗口来说足够了。如果你还想在流结束时获取 token 数,传入 stream_:ChatOpenAI(.。本指南从 invoke() 统计 token,如下一节所示。普通 OpenAI SDK 中的流式输出见 Python 中的流式响应。
读取每次调用的 token 用量#
invoke() 返回的每条消息都带有 usage_metadata,其中包含该次调用使用的 token:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
在流水线中将这些累加,你就有了每次运行的预算:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
输入和输出分别计价,因此两个数字都要保留。这种拆分的原因见 输入 token 与输出 token,完整的追踪器及超预算停止保护见 在 Python 中追踪 AI agent token 成本。
一条 LangChain 流水线每天的成本#
假设你运行一个每天处理 2,000 张工单的支持机器人。每次调用发送工单加提示词,约 3,000 个 token,回答约 500 个 token。在 MiniMax-M2.7 上,这样一次调用花费 $0.00023。将滑块移到你自己的数字;网站会按当前价格汇总:
成本计算器
支持机器人的一天
每次请求的输入 token 数: 3,000 · 每次请求的输出 token 数: 500 · 每日请求数: 2,000
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
计算器显示每日总和:在这类调用中,输入占 token 的大部分,输出占较小部分。使用 CheapTokens 时,总计(输入和输出合计)低于 OpenRouter,且价格在任何时段都相同:没有需要规划的峰时费率。
本指南涵盖的内容#
示例使用普通聊天补全:invoke、stream 和 usage_metadata。ChatOpenAI 遵循 OpenAI 规范,因此回答文本位于 .content 中。根据 LangChain 的文档,当你使用内置工具或 reasoning 参数时,它会切换到 Responses API。
如果调用失败,原因通常是以下三种之一:base_url 中缺少 /v1、使用了短模型 id 而非完整 id,或者运行 Python 的 shell 中未导出密钥变量。常见连接错误 列表展示了每种情况的样子。
下一步:用你自己的链运行上面的三步代码块,然后用不同的模型 id 在同一条链上试用 OpenAI 兼容端点。


