AI 入门指南
AI 代理如何工作:循环,无需 API 密钥运行
AI 代理是一个循环:模型请求工具,你的代码运行它,结果返回。运行一个无密钥的 Python 演示,然后将其指向真实模型。
你让一个编码代理修复一个拼写错误,然后看着日志滚动:读取一个文件,搜索,读取另一个文件,编辑,运行测试。一个小请求,十几次模型调用。它们从何而来?
AI 代理是一个循环。你的程序将对话发送给模型;模型要么回答,要么请求一个工具(“读取这个文件”);你的程序运行该工具,将结果添加到对话中,并再次调用模型。如此重复,直到模型以纯文本回答。像 Claude Code、Codex 和 Cursor 的代理模式这样的编码代理都围绕同一个循环构建,只是有更多工具和更多细节。下面你将运行一个 40 行的版本,完全不需要密钥,然后将其指向一个真实模型。
一图看懂循环#
想象一个不能触碰任何东西的管理者。管理者只写便条:“请把 todo.txt 带给我”。一个助手(你的程序)走到架子前,拿来文件并放在桌子上。管理者阅读它,然后写下下一个便条,或者最终答案。
这就是全部诀窍。模型从不打开文件或运行命令。它写文本,说明要调用哪个工具以及使用哪些参数。你的代码完成工作并反馈回来。如果你见过函数调用,这就是同样的机制,重复直到任务完成。
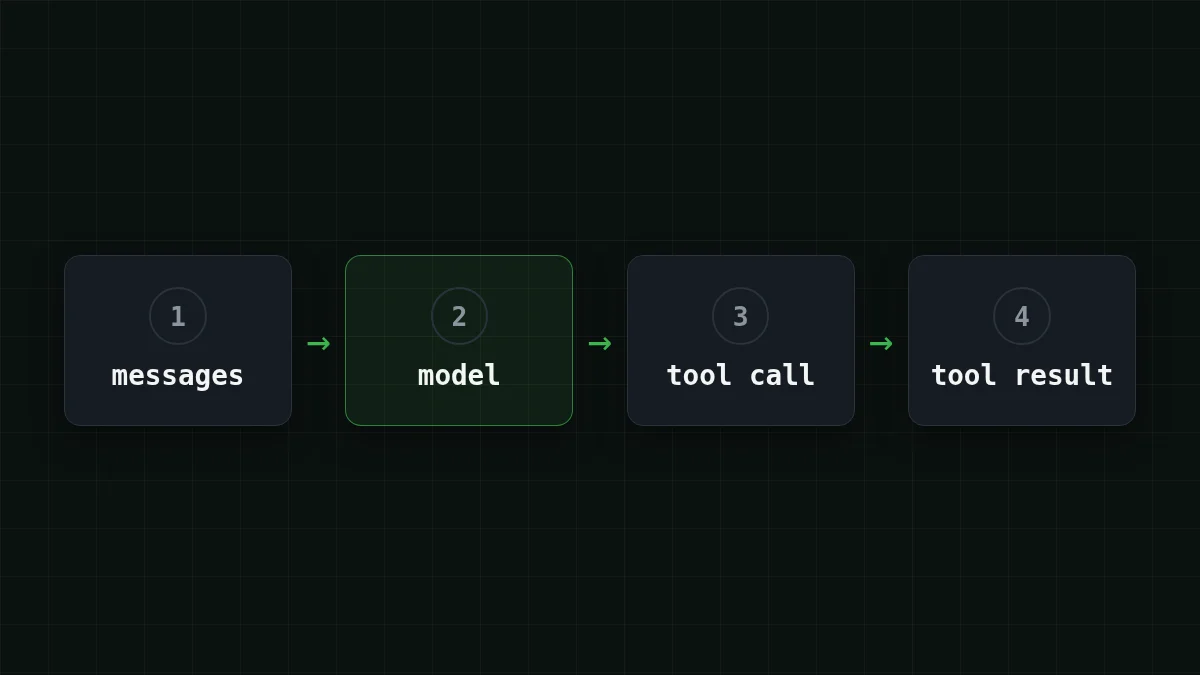
你能将循环的一圈按正确顺序排列吗?
排序
将代理循环的一圈按顺序排列
拖动项目或使用箭头
- 将任务和工具列表发送给模型
- 模型以工具调用而非文本回答
- 你的程序自己运行该工具
- 结果作为“tool”消息进入消息列表
- 带着结果再次调用模型,直到它以纯文本回复
无需密钥运行#
假设任务是:“todo.txt 中有多少项?”。工具是一个函数 read_file,它在一个小字典中查找而不是磁盘。并且没有真实模型,而是一个脚本化的模型,它总是做同样的两件事:请求文件,然后回答。这足以看到每个活动部件。将其保存为 agent_loop.py(Python 3.10+,仅标准库):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
运行 python agent_。如果你的环境中没有 LLM_API_KEY,你会得到脚本化模型,屏幕显示恰好两圈:
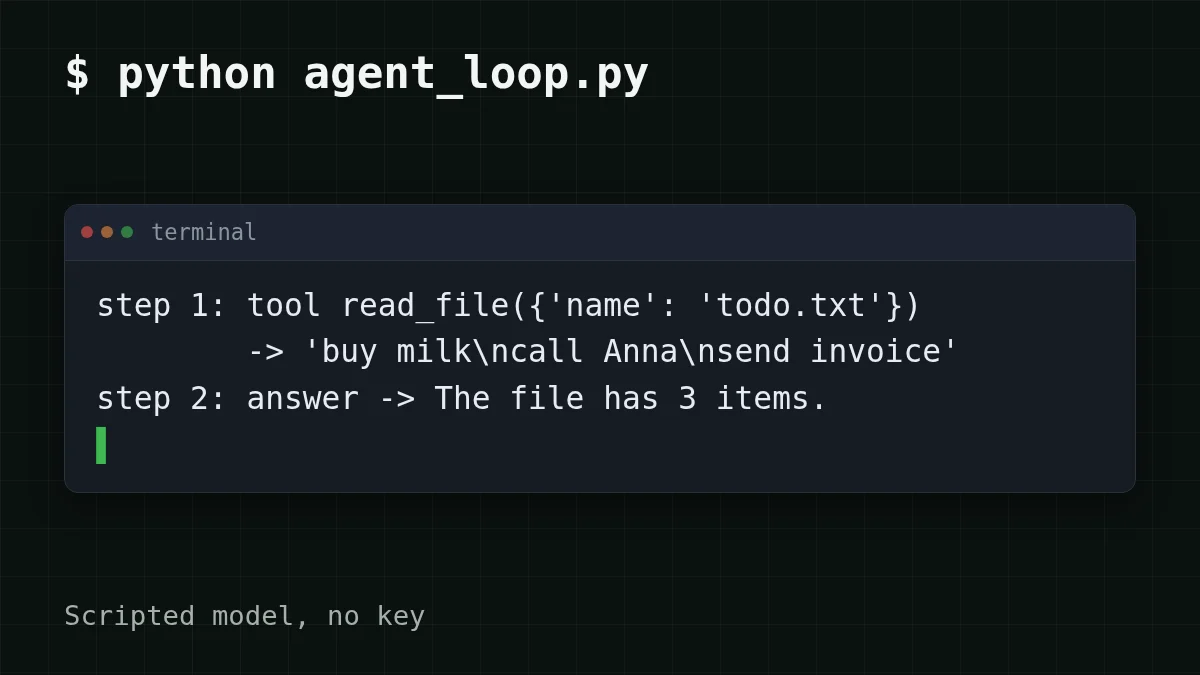
看三行,因为它们包含了整个思想:
messages.保留模型自己的回合。跳过它,下一次调用将包含一个工具结果,它回答了一个 API 从未见过的请求;大多数 API 会以 400 拒绝。append(reply) arguments以 JSON 字符串形式到达,所以在调用函数之前要经过json.loads。max_steps是紧急刹车。模型可能永远请求工具,所以每个真实代理都有这样的限制。
将同一个循环指向真实模型#
只有一件事改变:谁扮演模型。脚本读取三个环境变量,如果存在密钥,它将相同的 messages 发送到 OpenAI 兼容端点。CheapTokens 地址是 https:/(兼容 OpenAI Chat Completions 和 Anthropic Messages),模型 ID 必须是文档中的完整 ID:deepseek-。
以三种方式运行循环
无密钥
python agent_loop.py脚本化模型扮演两圈。没有任何东西离开你的机器。
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
380K 上下文窗口,每次回答最多 32,768 输出令牌:为长循环留出空间。
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
一个轻量模型,具有 390K 上下文窗口,适合多步循环的首次运行。
你应该看到与之前相同的形状:step 1: tool read_,然后 step 2: answer -,每次模型调用下面有一行 usage:。答案的措辞将与脚本化的不同,一个健谈的模型可能会多跑一圈。这很正常:模型决定,循环只是服从。将密钥排除在脚本本身之外;环境变量是安全的地方(这里是如何存储它)。
usage: 行是有用的部分。添加更长运行的 in 数字,你就会看到钱花在哪里。
为什么每一圈都比上一圈更贵#
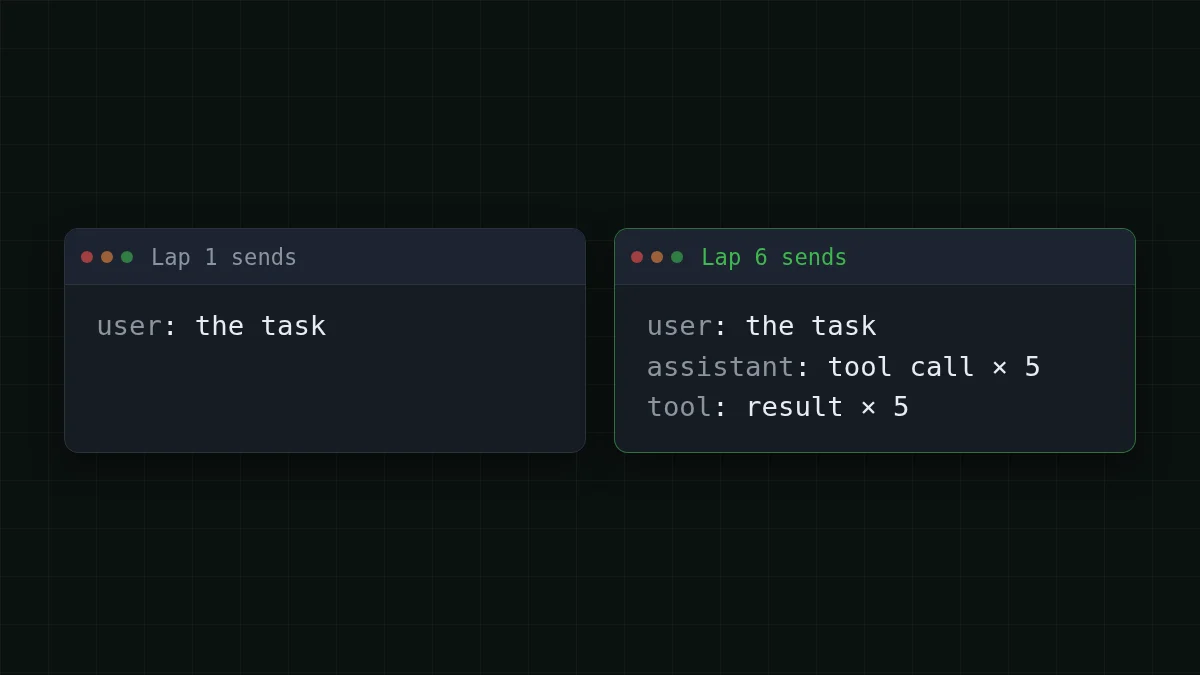
模型在调用之间不记得任何东西。每一圈都会再次发送整个 messages 列表:任务、每个早期的工具调用、每个工具结果。(同样的规则使长聊天变得昂贵;多轮聊天在普通对话中展示了这一点。)
第 1 圈发送一条消息。如果循环继续,第 6 圈发送十一条。
假设一个真实任务需要 10 圈。它开始时大约 2,000 个令牌(指令、工具列表、你的请求),每圈增加约 1,500 个(一个工具结果加上模型的笔记),模型每圈写约 300 个令牌。第 1 圈发送 2,000,第 2 圈发送 3,500,第 10 圈发送 15,500。第一部分的合计是 10 × 2,000 = 20,000 个令牌;增长增加 1,500 × 45 = 67,500(45 是 0+1+…+9),所以任务上的输入是 20,000 + 67,500 = 87,500 个令牌。输出是 10 × 300 = 3,000 个令牌。
任务文本本身只有几句话,但输入侧是 87,500 个令牌。按每 1M 输入令牌 $0.015 计算,DeepSeek-V4-Flash 上的整个任务花费 $0.0016。以下是相同负载在各模型上的情况,以 OpenRouter 作为参考。总的来说,输入和输出一起计算,CheapTokens 在此负载上比 OpenRouter 更便宜:
| 模型 | 输入 $/1M | 输出 $/1M | 费用 | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
总计 87,500 个输入 token 和 3,000 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
一天中任何时间一个价格在这里也有帮助:一个通宵运行的代理与中午运行的成本相同,你可以在定价页面上看到所有价格。对于一天这样的任务,移动滑块:
成本计算器
一天:20 个任务,每个 10 圈
每次请求的输入 token 数: 8,750 · 每次请求的输出 token 数: 300 · 每日请求数: 200
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
字段是每次模型调用:8,750 是上面示例中一圈的平均输入(87,500 ÷ 10),200 次调用是 20 个任务 × 10 圈。这就是为什么代理账单主要关乎历史,而不是问题。20 步示例深入探讨了同样的效应。
快速检查
代理循环的第 3 圈比第 1 圈花费更多,尽管你没有问任何新东西。为什么?
显示答案
答案: 消息列表现在包含两个工具调用和两个结果,所有这些都会再次发送
API 是无状态的。每次调用都携带完整历史,所以输入令牌每圈增长,而输出大致保持不变。
从 40 行出发去哪里#
上面的脚本是一个用于学习的草图。如果你想要长版本,GitHub 上有一个开放课程,justxor/agent-harness-course(README 为俄语,检查于 2026 年 10 月 31 日)。它是纯 Python 3.10+,无依赖,代码为 MIT 许可,文本为 CC BY 4.0。克隆后,python examples/ 使用脚本化模型离线运行循环,python - 在没有网络的情况下运行其 19 个测试。课程继续涵盖上下文压缩、记忆、子代理、危险操作的人工批准以及成本跟踪。对于真实模型,它读取 LLM_PROVIDER、LLM_MODEL、LLM_API_KEY,对于 OpenAI 兼容端点,读取 LLM_BASE_URL:从其 README 中获取确切的 LLM_PROVIDER 值。
当循环工作时,下一步是真实密钥和真实任务:文档有一分钟内的第一个请求,DeepSeek-V4-Flash是一个适合运行循环的好模型。


