IA pour débutantsGuide
Comment fonctionne un agent IA : la boucle, exécutée sans clé API
Un agent IA est une boucle : le modèle demande un outil, votre code l'exécute, le résultat revient. Exécutez une démo Python sans clé, puis pointez-la vers un vrai modèle.
Sur cette page
Vous demandez à un agent de codage de corriger une faute de frappe et vous regardez le journal défiler : lire un fichier, chercher, lire un autre fichier, modifier, lancer les tests. Une petite requête, une douzaine d'appels au modèle. D'où viennent-ils ?
Un agent IA est une boucle. Votre programme envoie la conversation au modèle ; le modèle répond ou demande un outil (« lis ce fichier ») ; votre programme exécute l'outil, ajoute le résultat à la conversation et rappelle le modèle. Cela se répète jusqu'à ce que le modèle réponde en texte brut. Les agents de codage comme Claude Code, Codex et le mode agent de Cursor sont construits autour de cette même boucle, avec plus d'outils et plus de soin. Ci-dessous, vous allez exécuter une version de 40 lignes sans aucune clé, puis la pointer vers un vrai modèle.
La boucle en une image#
Pensez à un manager qui ne peut rien toucher. Le manager écrit seulement des notes : « apporte-moi todo.txt, s'il te plaît ». Un assistant (votre programme) va à l'étagère, apporte le fichier et le pose sur le bureau. Le manager le lit et écrit la note suivante, ou la réponse finale.
C'est toute l'astuce. Le modèle n'ouvre jamais un fichier ni n'exécute une commande. Il écrit du texte qui indique quel outil appeler et avec quels arguments. Votre code fait le travail et rend compte. Si vous avez vu l'appel de fonction, c'est le même mécanisme, répété jusqu'à ce que la tâche soit terminée.
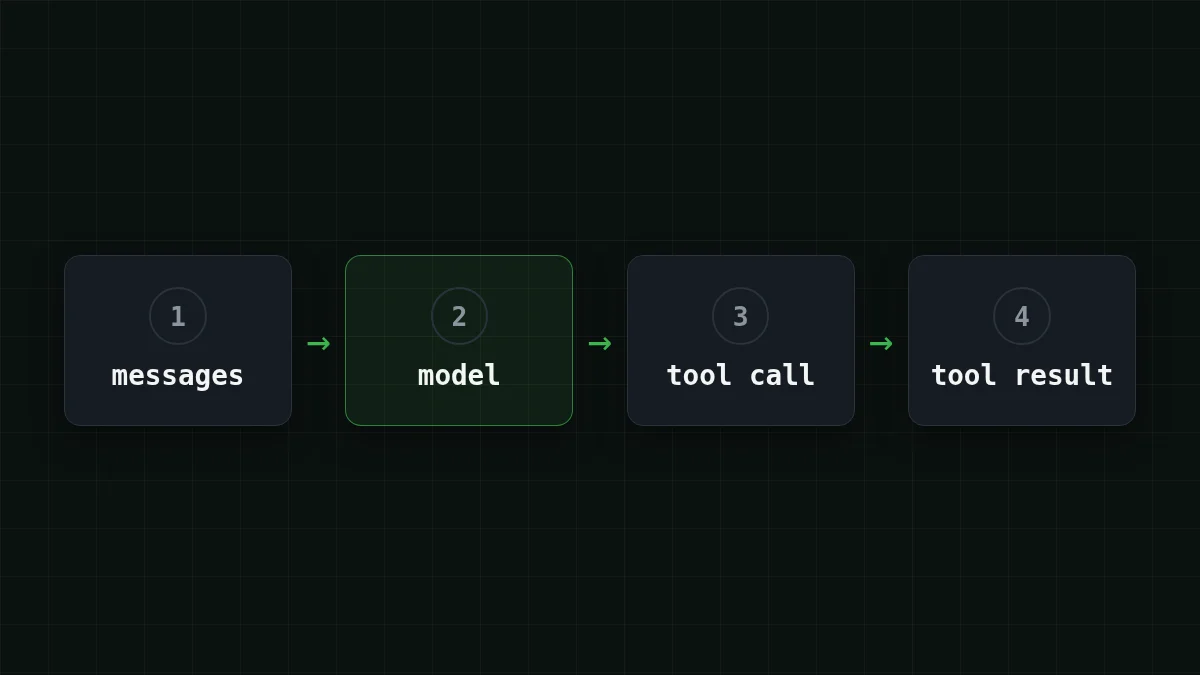
Pouvez-vous remettre un tour de boucle dans le bon ordre ?
Remettre en ordre
Remettre un tour de la boucle de l'agent dans l'ordre
Faites glisser les éléments ou utilisez les flèches
- Envoyer la tâche et la liste des outils au modèle
- Le modèle répond par un appel d'outil, pas par du texte
- Votre programme exécute lui-même cet outil
- Le résultat est ajouté aux messages sous forme de message « tool »
- Le modèle est rappelé avec le résultat, jusqu'à ce qu'il réponde en texte brut
Exécutez-le sans clé#
Disons que la tâche est : « Combien d'éléments y a-t-il dans todo.txt ? ». L'outil est une fonction read_file qui cherche dans un petit dictionnaire au lieu d'un disque. Et au lieu d'un vrai modèle, il y a un modèle scripté qui fait toujours les deux mêmes choses : demander le fichier, puis répondre. C'est suffisant pour voir chaque pièce mobile. Enregistrez ceci sous agent_loop.py (Python 3.10+, bibliothèque standard uniquement) :
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
Lancez python agent_. Sans LLM_API_KEY dans votre environnement, vous obtenez le modèle scripté, et l'écran affiche exactement deux tours :
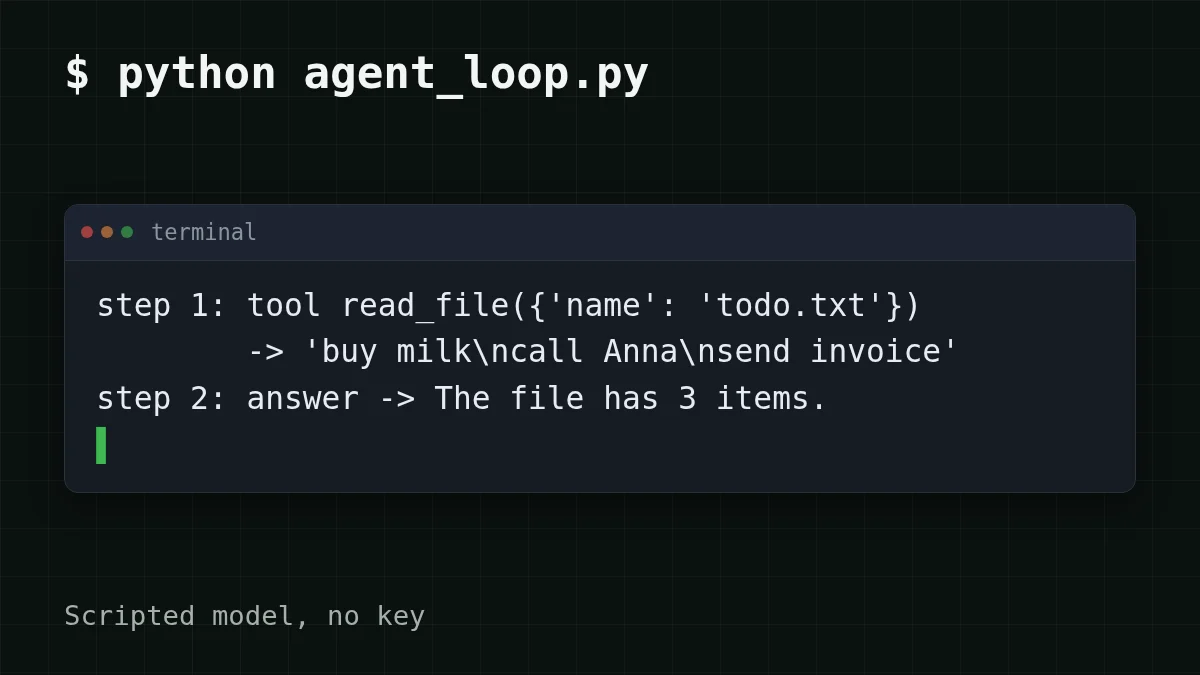
Regardez trois lignes, car elles contiennent toute l'idée :
messages.conserve le tour propre du modèle. Sautez-le, et l'appel suivant contient un résultat d'outil qui répond à une requête que l'API n'a jamais vue ; la plupart des API rejettent cela avec un 400.append(reply) argumentsarrive sous forme de chaîne JSON, donc il passe parjson.loadsavant que vous appeliez la fonction.max_stepsest le frein d'urgence. Un modèle peut demander des outils indéfiniment, donc chaque vrai agent a une limite de ce genre.
Pointez la même boucle vers un vrai modèle#
Une seule chose change : qui joue le modèle. Le script lit trois variables d'environnement, et si une clé est présente, il envoie le même messages à un point de terminaison compatible OpenAI. L'adresse CheapTokens est https:/ (compatible OpenAI Chat Completions et Anthropic Messages), et l'identifiant du modèle doit être le complet de la documentation : deepseek-.
Exécutez la boucle de trois façons
Sans clé
python agent_loop.pyLe modèle scripté joue les deux tours. Rien ne quitte votre machine.
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
Une fenêtre de contexte de 380K et jusqu'à 32 768 jetons de sortie par réponse : de la place pour une longue boucle.
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
Un modèle léger avec une fenêtre de contexte de 390K pour un premier essai de boucle multi-étapes.
Ce que vous devriez voir est la même forme qu'avant : step 1: tool read_, puis step 2: answer -, avec une ligne usage: sous chaque appel au modèle. La formulation de la réponse différera de celle du script, et un modèle bavard peut faire un tour supplémentaire. C'est normal : le modèle décide, la boucle obéit. Gardez la clé hors du script lui-même ; une variable d'environnement est l'endroit sûr (voici comment la stocker).
Les lignes usage: sont la partie utile. Ajoutez les nombres in d'une exécution plus longue et vous verrez où va l'argent.
Pourquoi chaque tour coûte plus que le précédent#
Le modèle ne se souvient de rien entre les appels. Chaque tour renvoie toute la liste messages : la tâche, chaque appel d'outil précédent, chaque résultat d'outil. (La même règle rend un long chat coûteux ; le chat multi-tours le montre sur une conversation simple.)
Le tour 1 envoie un message. Si la boucle continue, le tour 6 en envoie onze.
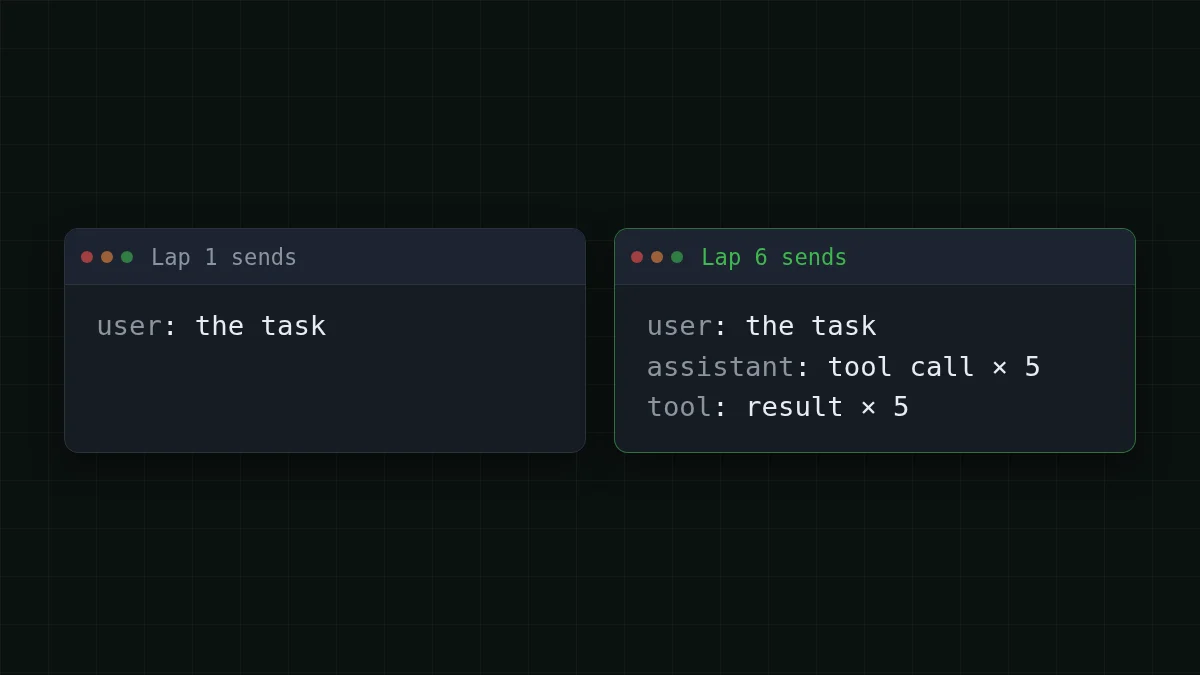
Disons qu'une vraie tâche prend 10 tours. Elle commence avec environ 2 000 jetons (instructions, liste d'outils, votre requête), chaque tour ajoute environ 1 500 (un résultat d'outil plus la note du modèle), et le modèle écrit environ 300 jetons par tour. Le tour 1 envoie 2 000, le tour 2 envoie 3 500, le tour 10 envoie 15 500. La somme de la première partie est 10 × 2 000 = 20 000 jetons ; la croissance ajoute 1 500 × 45 = 67 500 (45 vaut 0+1+…+9), donc l'entrée sur la tâche est de 20 000 + 67 500 = 87 500 jetons. La sortie est de 10 × 300 = 3 000 jetons.
Le texte de la tâche lui-même fait quelques phrases, pourtant le côté entrée est de 87 500 jetons. À $0.015 par million de jetons d'entrée, la tâche entière sur DeepSeek-V4-Flash revient à $0.0016. Voici la même charge sur les modèles, avec OpenRouter pour référence. Au total, entrée et sortie comprises, CheapTokens revient moins cher qu'OpenRouter sur cette charge :
| Modèle | Entrée $/1M | Sortie $/1M | Coût | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
87 500 tokens d'entrée et 3 000 tokens de sortie au total. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Un prix unique à toute heure de la journée aide aussi ici : un agent qui tourne la nuit coûte le même prix qu'à midi, et vous pouvez voir tous les prix sur la page de tarification. Pour une journée de telles tâches, déplacez les curseurs :
Calculateur de coût
Une journée : 20 tâches de 10 tours chacune
Tokens d'entrée par requête: 8 750 · Tokens de sortie par requête: 300 · Requêtes par jour: 200
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
Les champs sont par appel au modèle : 8 750 est l'entrée moyenne d'un tour de l'exemple ci-dessus (87 500 ÷ 10), et 200 appels correspondent à 20 tâches × 10 tours. C'est pourquoi les factures d'agent concernent l'historique, pas la question. L'exemple en 20 étapes approfondit le même effet.
Vérification rapide
Le tour 3 d'une boucle d'agent coûte plus cher que le tour 1, bien que vous n'ayez rien demandé de nouveau. Pourquoi ?
Afficher la réponse
Réponse: La liste des messages contient maintenant deux appels d'outil et deux résultats, et tout cela est renvoyé
L'API est sans état. Chaque appel transporte l'historique complet, donc les jetons d'entrée augmentent à chaque tour tandis que la sortie reste à peu près la même.
Où aller à partir de 40 lignes#
Le script ci-dessus est une esquisse pour apprendre. Si vous voulez la version longue, il y a un cours ouvert sur GitHub, justxor/agent-harness-course (README en russe, vérifié le 31 octobre 2026). C'est du Python 3.10+ simple sans dépendances, le code est sous licence MIT, le texte sous CC BY 4.0. Après le clonage, python examples/ exécute la boucle hors ligne avec un modèle scripté, et python - exécute ses 19 tests sans réseau. Le cours continue avec la compaction du contexte, la mémoire, les sous-agents, l'approbation humaine des actions risquées et le suivi des coûts. Pour un vrai modèle, il lit LLM_PROVIDER, LLM_MODEL, LLM_API_KEY et, pour les points de terminaison compatibles OpenAI, LLM_BASE_URL : prenez la valeur exacte de LLM_PROVIDER dans son README.
Quand la boucle fonctionne, l'étape suivante est une vraie clé et une vraie tâche : la documentation propose une première requête en une minute, et DeepSeek-V4-Flash est un bon modèle pour exécuter la boucle.


