AI dla początkującychPrzewodnik
Jak działa agent AI: pętla uruchamiana bez klucza API
Agent AI to pętla: model prosi o narzędzie, twój kod je uruchamia, wynik wraca. Uruchom demo w Pythonie bez klucza, a potem skieruj je na prawdziwy model.
Na tej stronie
Prosisz agenta kodującego o poprawienie literówki i patrzysz, jak log przewija się: odczyt pliku, wyszukiwanie, odczyt kolejnego pliku, edycja, uruchomienie testów. Jedna mała prośba, kilkanaście wywołań modelu. Skąd się biorą?
Agent AI to pętla. Twój program wysyła rozmowę do modelu; model albo odpowiada, albo prosi o narzędzie („przeczytaj ten plik”); twój program uruchamia narzędzie, dodaje wynik do rozmowy i ponownie wywołuje model. Powtarza się to, aż model odpowie zwykłym tekstem. Agenci kodujący, tacy jak Claude Code, Codex i tryb agenta w Cursorze, są zbudowani wokół tej samej pętli, z większą liczbą narzędzi i większą starannością. Poniżej uruchomisz 40-liniową wersję całkowicie bez klucza, a potem skierujesz ją na prawdziwy model.
Pętla na jednym obrazku#
Wyobraź sobie menedżera, który nie może niczego dotknąć. Menedżer tylko pisze notatki: „proszę przynieść mi todo.txt”. Asystent (twój program) idzie do półki, przynosi plik i kładzie go na biurku. Menedżer czyta go i pisze kolejną notatkę albo ostateczną odpowiedź.
Na tym polega cały trik. Model nigdy nie otwiera pliku ani nie uruchamia polecenia. Pisze tekst, który mówi, które narzędzie wywołać i z jakimi argumentami. Twój kod wykonuje pracę i raportuje z powrotem. Jeśli widziałeś function calling, to ten sam mechanizm, powtarzany aż do wykonania zadania.
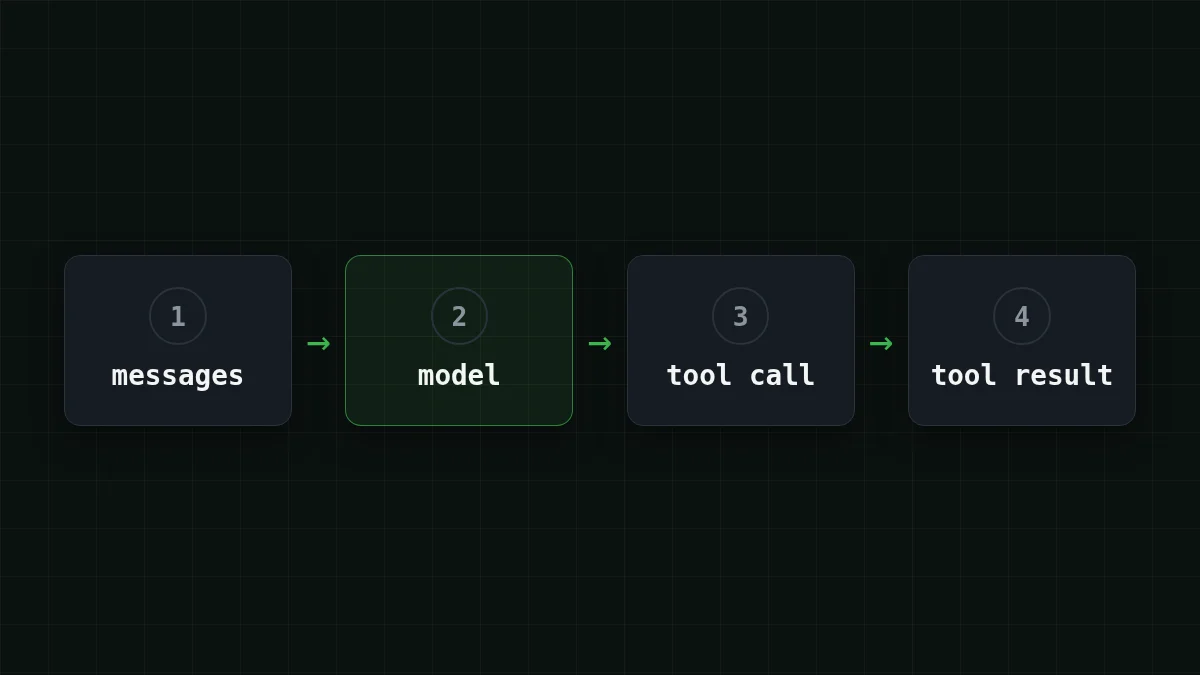
Czy potrafisz ułożyć jeden obieg pętli we właściwej kolejności?
Ustaw w kolejności
Ułóż jeden obieg pętli agenta w kolejności
Przeciągnij elementy lub użyj strzałek
- Wyślij zadanie i listę narzędzi do modelu
- Model odpowiada wywołaniem narzędzia, a nie tekstem
- Twój program sam uruchamia to narzędzie
- Wynik trafia do wiadomości jako wiadomość „tool”
- Model jest wywoływany ponownie z wynikiem, aż odpowie zwykłym tekstem
Uruchom to bez klucza#
Powiedzmy, że zadanie brzmi: „Ile pozycji jest w todo.txt?”. Narzędziem jest funkcja read_file, która zagląda do małego słownika zamiast na dysk. A zamiast prawdziwego modelu jest model skryptowy, który zawsze robi to samo: prosi o plik, a potem odpowiada. To wystarczy, żeby zobaczyć każdy ruchomy element. Zapisz to jako agent_loop.py (Python 3.10+, tylko biblioteka standardowa):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
Uruchom python agent_. Bez LLM_API_KEY w środowisku dostajesz model skryptowy, a ekran pokazuje dokładnie dwa obiegi:
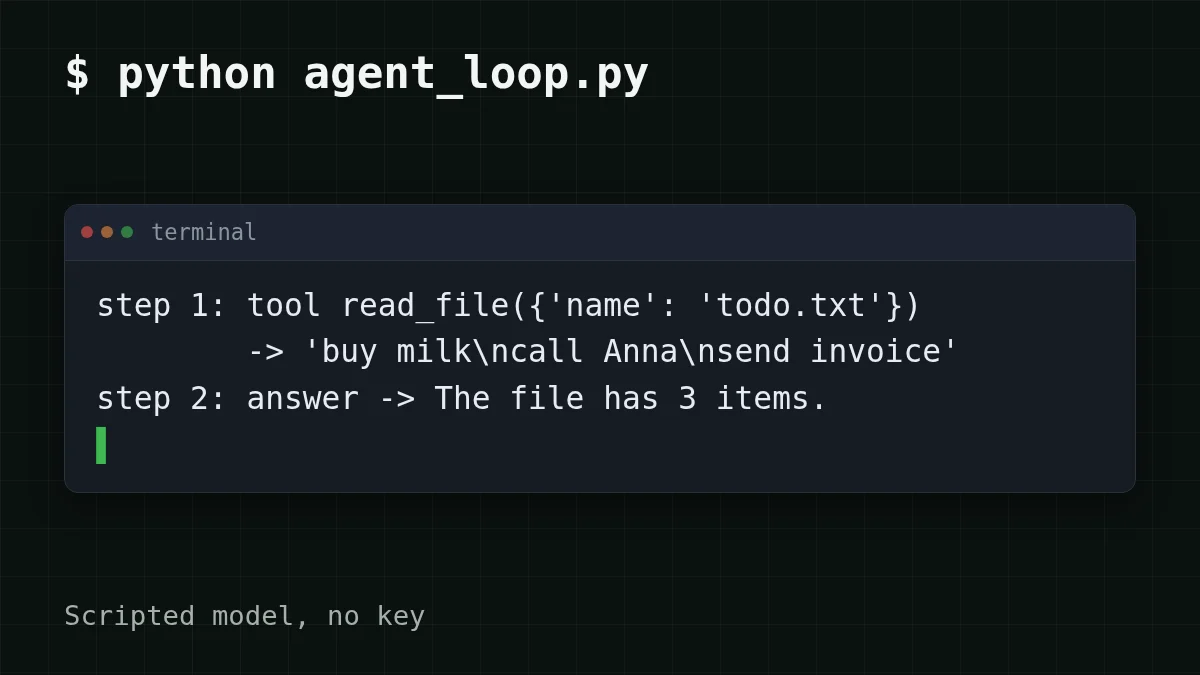
Spójrz na trzy linie, bo zawierają cały pomysł:
messages.zachowuje własną turę modelu. Pomiń ją, a następne wywołanie będzie zawierać wynik narzędzia odpowiadający żądaniu, którego API nigdy nie widziało; większość API odrzuci to błędem 400.append(reply) argumentsprzychodzi jako string JSON, więc przechodzi przezjson.loads, zanim wywołasz funkcję.max_stepsto hamulec awaryjny. Model może w nieskończoność prosić o narzędzia, więc każdy prawdziwy agent ma taki limit.
Skieruj tę samą pętlę na prawdziwy model#
Zmienia się tylko jedna rzecz: kto gra model. Skrypt czyta trzy zmienne środowiskowe i jeśli klucz jest obecny, wysyła te same messages do endpointu zgodnego z OpenAI. Adres CheapTokens to https:/ (zgodny z OpenAI Chat Completions i Anthropic Messages), a identyfikator modelu musi być pełny z dokumentacji: deepseek-.
Uruchom pętlę na trzy sposoby
Bez klucza
python agent_loop.pyModel skryptowy odgrywa oba obiegi. Nic nie opuszcza twojej maszyny.
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
Okno kontekstu 380K i do 32 768 tokenów wyjściowych na odpowiedź: miejsce na długą pętlę.
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
Lekki model z oknem kontekstu 390K na pierwsze uruchomienie wieloetapowej pętli.
Powinieneś zobaczyć ten sam kształt co wcześniej: step 1: tool read_, potem step 2: answer -, z linią usage: pod każdym wywołaniem modelu. Sformułowanie odpowiedzi będzie inne niż w wersji skryptowej, a gadatliwy model może wykonać dodatkowy obieg. To normalne: model decyduje, pętla tylko wykonuje polecenia. Trzymaj klucz poza samym skryptem; zmienna środowiskowa to bezpieczne miejsce (tutaj jest jak go przechowywać).
Linie usage: to użyteczna część. Dodaj liczby in z dłuższego uruchomienia i zobaczysz, gdzie idą pieniądze.
Dlaczego każdy obieg kosztuje więcej niż poprzedni#
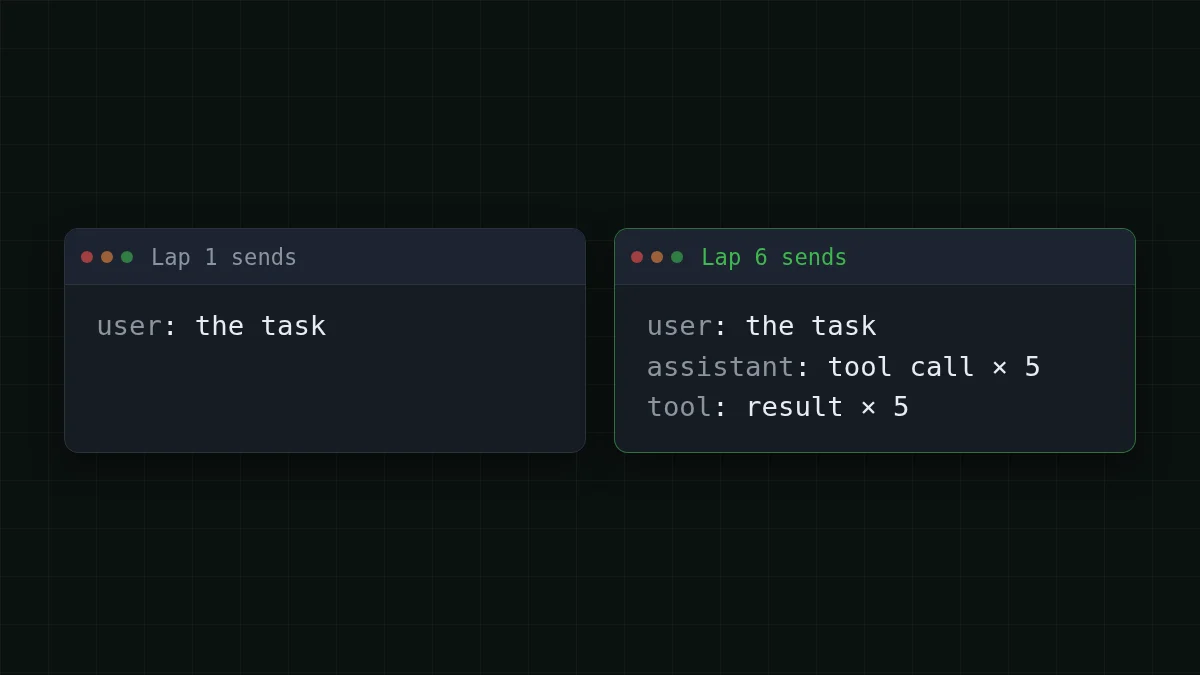
Model nic nie pamięta między wywołaniami. Każdy obieg wysyła ponownie całą listę messages: zadanie, każde wcześniejsze wywołanie narzędzia, każdy wynik narzędzia. (Ta sama zasada sprawia, że długi czat jest drogi; czat wieloturnowy pokazuje to na zwykłej rozmowie.)
Obieg 1 wysyła jedną wiadomość. Jeśli pętla trwa, obieg 6 wysyła jedenaście.
Powiedzmy, że prawdziwe zadanie zajmuje 10 obiegów. Zaczyna się od około 2000 tokenów (instrukcje, lista narzędzi, twoje żądanie), każdy obieg dodaje około 1500 (wynik narzędzia plus notatka modelu), a model pisze około 300 tokenów na obieg. Obieg 1 wysyła 2000, obieg 2 wysyła 3500, obieg 10 wysyła 15 500. Suma pierwszej części to 10 × 2000 = 20 000 tokenów; wzrost dodaje 1500 × 45 = 67 500 (45 to 0+1+…+9), więc wejście na zadanie to 20 000 + 67 500 = 87 500 tokenów. Wyjście to 10 × 300 = 3000 tokenów.
Sam tekst zadania to kilka zdań, a jednak strona wejściowa to 87 500 tokenów. Przy $0.015 za 1M tokenów wejściowych całe zadanie na DeepSeek-V4-Flash kosztuje $0.0016. Oto to samo obciążenie na poszczególnych modelach, z OpenRouter dla porównania. Łącznie, licząc wejście i wyjście razem, CheapTokens wypada taniej niż OpenRouter przy tym obciążeniu:
| Model | Wejście $/1M | Wyjście $/1M | Koszt | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
87 500 tokenów wejściowych i 3000 tokenów wyjściowych łącznie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Jedna cena o każdej porze dnia też tu pomaga: agent uruchamiany nocą kosztuje tyle samo co w południe, a wszystkie ceny zobaczysz na stronie cennika. Dla dnia takich zadań przesuń suwaki:
Kalkulator kosztów
Jeden dzień: 20 zadań po 10 obiegów każde
Tokeny wejściowe na żądanie: 8750 · Tokeny wyjściowe na żądanie: 300 · Żądania dziennie: 200
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
Pola są na wywołanie modelu: 8750 to średnie wejście obiegu z powyższego przykładu (87 500 ÷ 10), a 200 wywołań to 20 zadań × 10 obiegów. Dlatego rachunki za agenta dotyczą głównie historii, a nie pytania. Przykład 20 kroków zagłębia się w ten sam efekt.
Szybkie sprawdzenie
Obieg 3 pętli agenta kosztuje więcej niż obieg 1, choć nie zapytałeś o nic nowego. Dlaczego?
Pokaż odpowiedź
Odpowiedź: Lista wiadomości zawiera teraz dwa wywołania narzędzi i dwa wyniki, a to wszystko jest wysyłane ponownie
API jest bezstanowe. Każde wywołanie niesie pełną historię, więc tokeny wejściowe rosną z każdym obiegiem, podczas gdy wyjście pozostaje mniej więcej takie samo.
Dokąd iść od 40 linii#
Powyższy skrypt to szkic do nauki. Jeśli chcesz długą wersję, na GitHubie jest otwarty kurs, justxor/agent-harness-course (README po rosyjsku, sprawdzony 31 października 2026). To czysty Python 3.10+ bez zależności, kod na licencji MIT, tekst na CC BY 4.0. Po sklonowaniu python examples/ uruchamia pętlę offline z modelem skryptowym, a python - uruchamia jego 19 testów bez sieci. Kurs kontynuuje z kompakcją kontekstu, pamięcią, podagentami, zatwierdzaniem ryzykownych działań przez człowieka i śledzeniem kosztów. Dla prawdziwego modelu czyta LLM_PROVIDER, LLM_MODEL, LLM_API_KEY, a dla endpointów zgodnych z OpenAI LLM_BASE_URL: weź dokładną wartość LLM_PROVIDER z jego README.
Gdy pętla działa, następnym krokiem jest prawdziwy klucz i prawdziwe zadanie: dokumentacja ma pierwsze żądanie w minutę, a DeepSeek-V4-Flash to dobry model do uruchomienia pętli.


