الذكاء الاصطناعي للمبتدئيندليل
كيف يعمل الوكيل الذكي: الحلقة، مشغّلة بدون مفتاح API
الوكيل الذكي هو حلقة: يطلب النموذج أداة، يشغّلها كودك، تعود النتيجة. شغّل عرضًا توضيحيًا بلغة Python بدون مفتاح، ثم وجّهه إلى نموذج حقيقي.
في هذه الصفحة
تطلب من وكيل برمجي إصلاح خطأ مطبعي واحد وتراقب السجل يتدحرج: اقرأ ملفًا، ابحث، اقرأ ملفًا آخر، عدّل، شغّل الاختبارات. طلب صغير واحد، دستة من استدعاءات النموذج. من أين تأتي؟
الوكيل الذكي هو حلقة. يرسل برنامجك المحادثة إلى النموذج؛ إما أن يجيب النموذج أو يطلب أداة ("اقرأ هذا الملف")؛ يشغّل برنامجك الأداة، يضيف النتيجة إلى المحادثة ويستدعي النموذج مرة أخرى. يتكرر ذلك حتى يجيب النموذج بنص عادي. وكلاء البرمجة مثل Claude Code وCodex ووضع الوكيل في Cursor مبنية حول هذه الحلقة نفسها، مع المزيد من الأدوات والمزيد من العناية. أدناه ستشغّل نسخة من 40 سطرًا بدون مفتاح على الإطلاق، ثم توجّهها إلى نموذج حقيقي.
الحلقة في صورة واحدة#
تخيّل مديرًا لا يستطيع لمس أي شيء. المدير يكتب ملاحظات فقط: "أحضر لي todo.txt من فضلك". مساعد (برنامجك) يذهب إلى الرف، يحضر الملف ويضعه على المكتب. يقرأه المدير ويكتب الملاحظة التالية، أو الإجابة النهائية.
هذه هي الحيلة بأكملها. النموذج لا يفتح ملفًا ولا يشغّل أمرًا أبدًا. يكتب نصًا يقول أي أداة يستدعي وبأي وسائط. كودك يقوم بالعمل ويبلّغ بالنتيجة. إذا رأيت function calling، فهذه هي الآلية نفسها، مكررة حتى إنجاز المهمة.
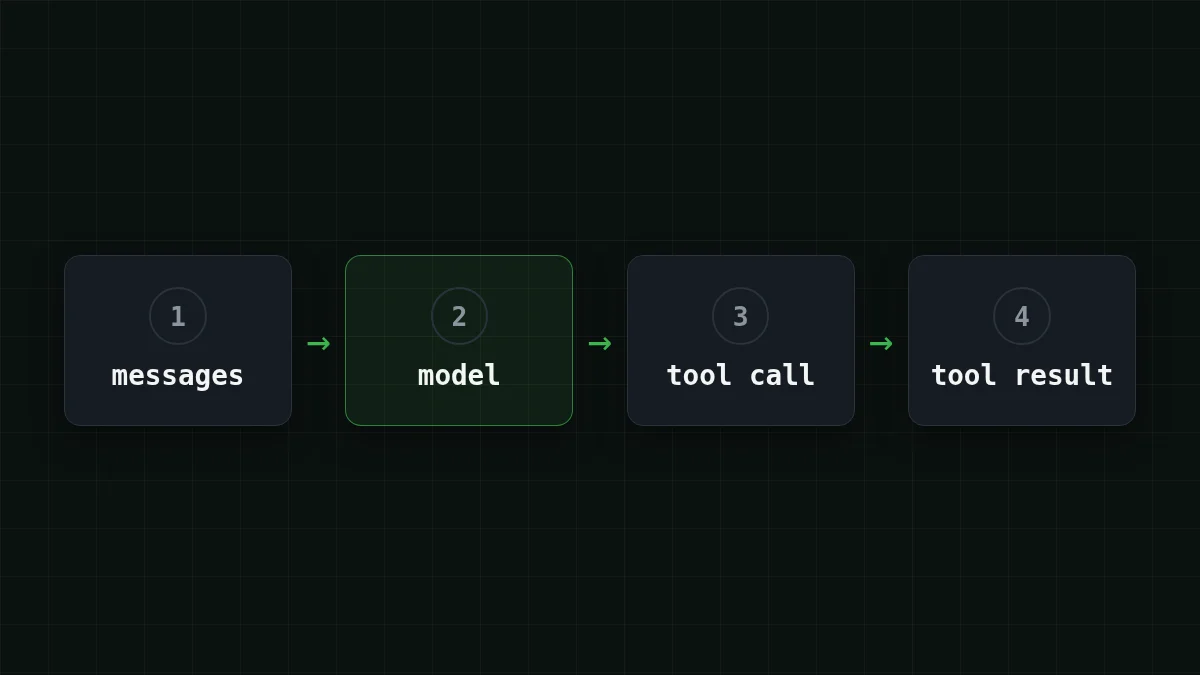
هل يمكنك ترتيب دورة واحدة من الحلقة بالترتيب الصحيح؟
رتّب بالترتيب
رتّب دورة واحدة من حلقة الوكيل
اسحب العناصر أو استخدم الأسهم
- أرسل المهمة وقائمة الأدوات إلى النموذج
- يجيب النموذج باستدعاء أداة، لا نص
- يشغّل برنامجك تلك الأداة بنفسه
- تدخل النتيجة في الرسائل كرسالة "tool"
- يُستدعى النموذج مجددًا مع النتيجة، حتى يرد بنص عادي
شغّلها بدون مفتاح#
لنفترض أن المهمة هي: "كم عدد العناصر في todo.txt؟". الأداة هي دالة read_file تبحث في قاموس صغير بدلاً من قرص. وبدلاً من نموذج حقيقي هناك نموذج مبرمج يفعل دائمًا الشيئين نفسيهما: يطلب الملف، ثم يجيب. هذا يكفي لرؤية كل جزء متحرك. احفظ هذا باسم agent_loop.py (Python 3.10+، المكتبة القياسية فقط):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
شغّل python agent_. بدون LLM_API_KEY في بيئتك تحصل على النموذج المبرمج، وتعرض الشاشة دورتين بالضبط:
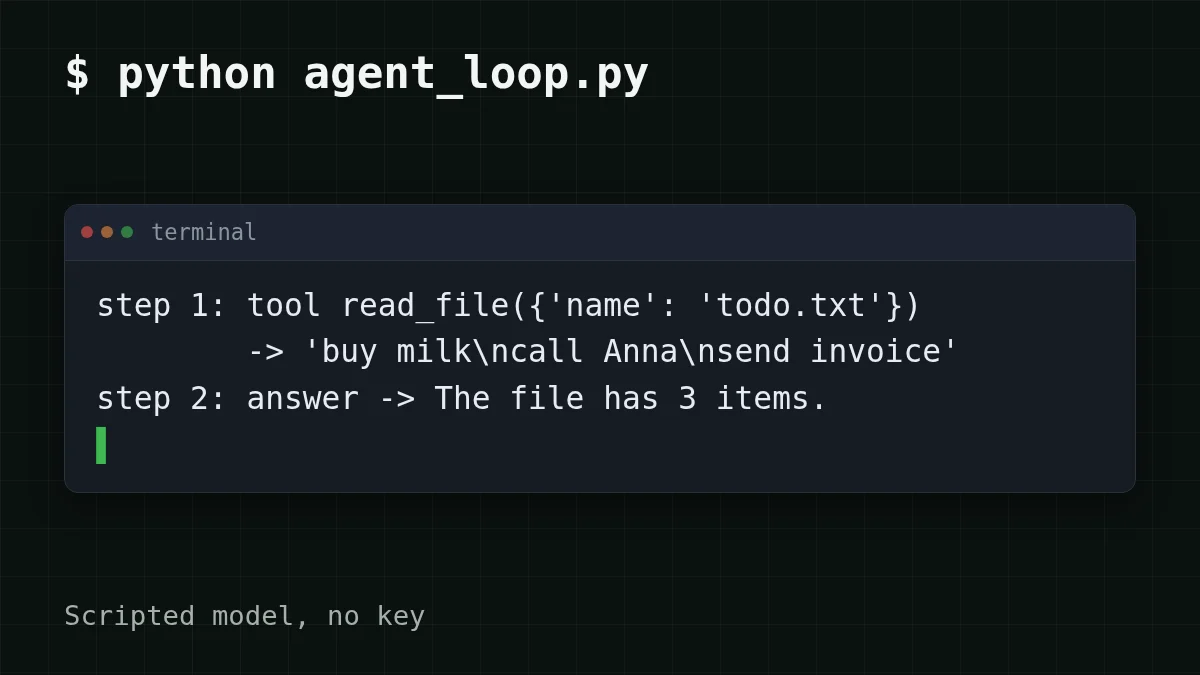
انظر إلى ثلاثة أسطر، لأنها تحمل الفكرة كلها:
messages.يحتفظ بدور النموذج نفسه. تجاهله، وسيحتوي الاستدعاء التالي على نتيجة أداة تجيب على طلب لم تره الـ API قط؛ معظم الـ APIs ترفض ذلك بخطأ 400.append(reply) argumentsيصل كـ سلسلة JSON، لذا يمر عبرjson.loadsقبل أن تستدعي الدالة.max_stepsهو المكابح الاحتياطية. يمكن للنموذج أن يظل يطلب أدوات إلى الأبد، لذا كل وكيل حقيقي لديه حد كهذا.
وجّه الحلقة نفسها إلى نموذج حقيقي#
يتغير شيء واحد فقط: من يلعب دور النموذج. يقرأ السكربت ثلاثة متغيرات بيئة، وإذا وُجد مفتاح يرسل نفس messages إلى نقطة نهاية متوافقة مع OpenAI. عنوان CheapTokens هو https:/ (متوافق مع OpenAI Chat Completions وAnthropic Messages)، ويجب أن يكون معرّف النموذج هو الكامل من التوثيق: deepseek-.
شغّل الحلقة بثلاث طرق
بدون مفتاح
python agent_loop.pyالنموذج المبرمج يلعب الدورتين. لا شيء يغادر جهازك.
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
نافذة سياق 380K وحتى 32,768 رمز إخراج لكل إجابة: مساحة لحلقة طويلة.
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
نموذج خفيف بنافذة سياق 390K لتشغيل أول لحلقة متعددة الخطوات.
ما يجب أن تراه هو الشكل نفسه كما في السابق: step 1: tool read_، ثم step 2: answer -، مع سطر usage: تحت كل استدعاء نموذج. ستختلف صياغة الإجابة عن المبرمجة، وقد يأخذ نموذج ثرثار دورة إضافية. هذا طبيعي: النموذج يقرر، والحلقة تطيع فقط. أبقِ المفتاح خارج السكربت نفسه؛ متغير البيئة هو المكان الآمن (إليك كيف تخزنه).
أسطر usage: هي الجزء المفيد. أضف أرقام in لتشغيل أطول وسترى أين تذهب التكلفة.
لماذا تكلف كل دورة أكثر من السابقة#
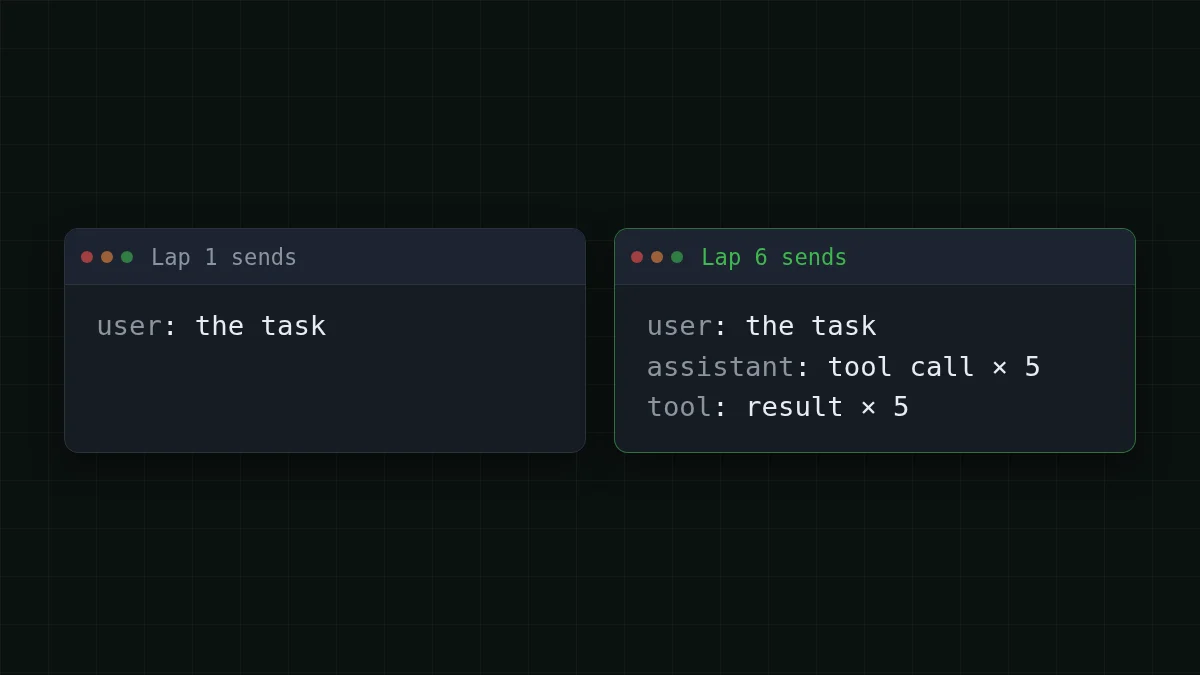
النموذج لا يتذكر شيئًا بين الاستدعاءات. كل دورة ترسل قائمة messages كاملة مرة أخرى: المهمة، كل استدعاء أداة سابق، كل نتيجة أداة. (القاعدة نفسها تجعل محادثة طويلة مكلفة؛ multi-turn chat يوضحها في محادثة عادية.)
الدورة 1 ترسل رسالة واحدة. إذا استمرت الحلقة، الدورة 6 ترسل إحدى عشرة.
لنفترض أن مهمة حقيقية تستغرق 10 دورات. تبدأ بحوالي 2,000 رمز (تعليمات، قائمة أدوات، طلبك)، كل دورة تضيف حوالي 1,500 (نتيجة أداة زائد ملاحظة النموذج)، ويكتب النموذج حوالي 300 رمز لكل دورة. الدورة 1 ترسل 2,000، الدورة 2 ترسل 3,500، الدورة 10 ترسل 15,500. مجموع الجزء الأول هو 10 × 2,000 = 20,000 رمز؛ النمو يضيف 1,500 × 45 = 67,500 (45 هي 0+1+…+9)، لذا الإدخال على المهمة هو 20,000 + 67,500 = 87,500 رمز. الإخراج هو 10 × 300 = 3,000 رمز.
نص المهمة نفسه بضع جمل، ومع ذلك جانب الإدخال 87,500 رمز. بسعر $0.015 لكل 1M رمز إدخال، تبلغ المهمة كاملة على DeepSeek-V4-Flash $0.0016. إليك نفس الحمل عبر النماذج، مع OpenRouter للمرجعية. في المجموع، مع احتساب الإدخال والإخراج معًا، يخرج CheapTokens أرخص من OpenRouter على هذا الحمل:
| النموذج | الإدخال $/1M | الإخراج $/1M | التكلفة | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
87,500 رمز إدخال و3,000 رمز إخراج إجمالًا. الأسعار لكل مليون رمز حالية وتتغير مع تعريفاتنا؛ يعرض عمود OpenRouter أسعارًا مرجعية لنفس حجم العمل.
سعر واحد في أي وقت من اليوم يساعد هنا أيضًا: وكيل يعمل طوال الليل يكلف نفس وكيل يعمل في الظهيرة، ويمكنك رؤية كل الأسعار على صفحة التسعير. ليوم من هذه المهام، حرّك المنزلقات:
حاسبة التكلفة
يوم واحد: 20 مهمة من 10 دورات لكل منها
رموز الإدخال لكل طلب: 8,750 · رموز الإخراج لكل طلب: 300 · الطلبات يوميًا: 200
| النموذج | يوميًا | شهريًا |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
الحقول لكل استدعاء نموذج: 8,750 هو متوسط إدخال دورة من المثال أعلاه (87,500 ÷ 10)، و200 استدعاء هو 20 مهمة × 10 دورات. هذا هو سبب أن فواتير الوكلاء تتعلق بـالتاريخ، لا بالسؤال. مثال 20 خطوة يتعمق في التأثير نفسه.
فحص سريع
الدورة 3 من حلقة وكيل تكلف أكثر من الدورة 1، رغم أنك لم تسأل شيئًا جديدًا. لماذا؟
إظهار الإجابة
الإجابة: قائمة الرسائل تحتوي الآن على استدعاءي أدوات ونتيجتين، وكل ذلك يُرسل مرة أخرى
الـ API عديم الحالة. كل استدعاء يحمل التاريخ الكامل، لذا تنمو رموز الإدخال مع كل دورة بينما يبقى الإخراج تقريبًا كما هو.
إلى أين تذهب من 40 سطرًا#
السكربت أعلاه رسم تخطيطي للتعلم. إذا أردت النسخة الطويلة، هناك دورة مفتوحة على GitHub، justxor/agent-harness-course (README بالروسية، تم التحقق منه في 31 أكتوبر 2026). إنها Python 3.10+ عادية بدون تبعيات، الكود مرخص MIT، النص CC BY 4.0. بعد الاستنساخ، python examples/ يشغّل الحلقة دون اتصال بنموذج مبرمج، وpython - يشغّل اختباراته الـ19 بدون شبكة. تستمر الدورة بضغط السياق، الذاكرة، الوكلاء الفرعيين، الموافقة البشرية على الإجراءات الخطرة، وتتبع التكلفة. لنموذج حقيقي تقرأ LLM_PROVIDER، LLM_MODEL، LLM_API_KEY ولنقاط النهاية المتوافقة مع OpenAI، LLM_BASE_URL: خذ قيمة LLM_PROVIDER الدقيقة من README الخاص بها.
عندما تعمل الحلقة، الخطوة التالية هي مفتاح حقيقي ومهمة حقيقية: التوثيق فيه طلب أول في دقيقة، وDeepSeek-V4-Flash نموذج جيد لتشغيل الحلقة عليه.


