AI एजेंट कैसे काम करता है: लूप, बिना API कुंजी के चलाएँ
AI एजेंट एक लूप है: मॉडल एक टूल माँगता है, आपका कोड उसे चलाता है, परिणाम वापस जाता है। बिना कुंजी वाला Python डेमो चलाएँ, फिर इसे असली मॉडल पर इंगित करें।
इस पृष्ठ पर
आप एक कोडिंग एजेंट से एक टाइपो ठीक करने को कहते हैं और लॉग स्क्रॉल होता देखते हैं: एक फ़ाइल पढ़ो, खोजो, दूसरी फ़ाइल पढ़ो, संपादित करो, टेस्ट चलाओ। एक छोटा अनुरोध, दर्जन भर मॉडल कॉल। ये कहाँ से आते हैं?
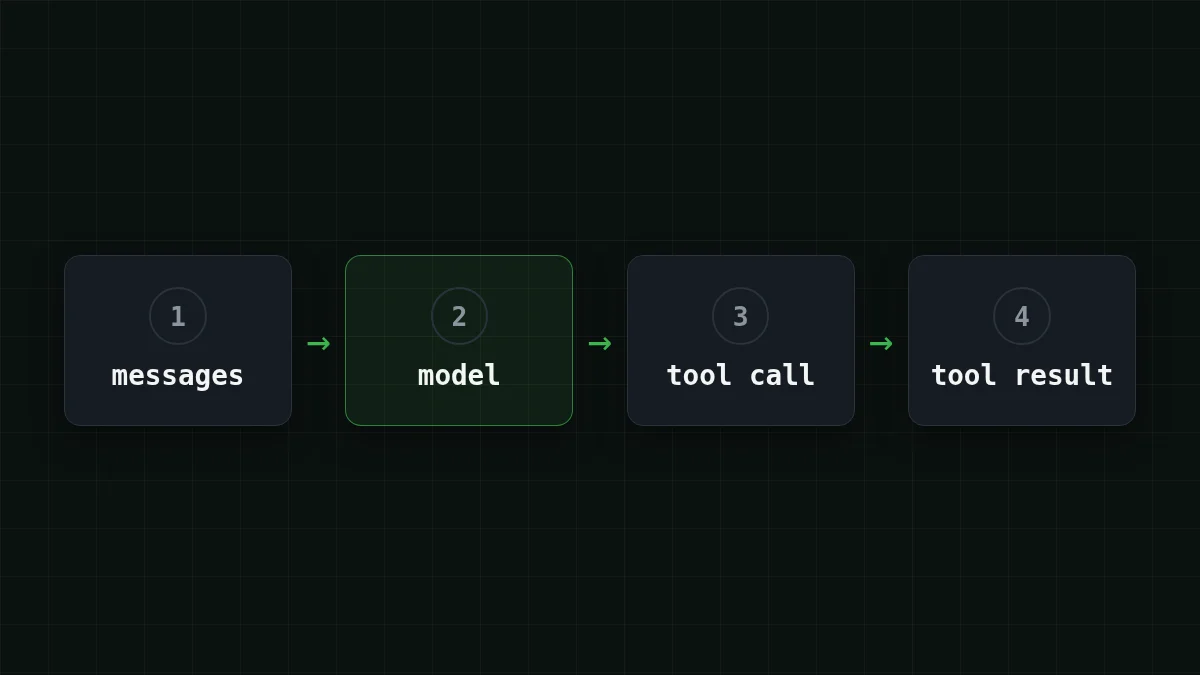
एक AI एजेंट एक लूप है। आपका प्रोग्राम बातचीत को मॉडल को भेजता है; मॉडल या तो जवाब देता है या एक टूल माँगता है ("यह फ़ाइल पढ़ो"); आपका प्रोग्राम टूल चलाता है, परिणाम को बातचीत में जोड़ता है और मॉडल को फिर से कॉल करता है। यह तब तक दोहराता है जब तक मॉडल सादे टेक्स्ट में जवाब न दे। Claude Code, Codex और Cursor के एजेंट मोड जैसे कोडिंग एजेंट इसी लूप के आसपास बने हैं, बस अधिक टूल और अधिक सावधानी के साथ। नीचे आप बिना किसी कुंजी के 40 पंक्तियों का संस्करण चलाएँगे, फिर इसे एक असली मॉडल पर इंगित करेंगे।
एक चित्र में लूप#
एक ऐसे प्रबंधक की सोचें जो कुछ भी नहीं छू सकता। प्रबंधक केवल नोट लिखता है: "कृपया मुझे todo.txt लाओ"। एक सहायक (आपका प्रोग्राम) शेल्फ पर जाता है, फ़ाइल लाता है और डेस्क पर रखता है। प्रबंधक उसे पढ़ता है और अगला नोट, या अंतिम उत्तर लिखता है।
यही पूरी तरकीब है। मॉडल कभी फ़ाइल नहीं खोलता या कमांड नहीं चलाता। वह टेक्स्ट लिखता है जो बताता है कौन सा टूल कॉल करना है और किन आर्ग्युमेंट्स के साथ। आपका कोड काम करता है और रिपोर्ट करता है। यदि आपने function calling देखा है, तो यह वही तंत्र है, जो काम पूरा होने तक दोहराया जाता है।
क्या आप लूप का एक चक्कर सही क्रम में रख सकते हैं?
क्रम में लगाएँ
एजेंट लूप का एक चक्कर क्रम में रखें
आइटम खींचें या तीरों का उपयोग करें
- कार्य और टूल सूची मॉडल को भेजें
- मॉडल टेक्स्ट के बजाय टूल कॉल के साथ जवाब देता है
- आपका प्रोग्राम वह टूल स्वयं चलाता है
- परिणाम संदेशों में "tool" संदेश के रूप में जाता है
- मॉडल को परिणाम के साथ फिर से कॉल किया जाता है, जब तक वह सादे टेक्स्ट में जवाब न दे
इसे बिना कुंजी के चलाएँ#
मान लें कार्य है: "todo.txt में कितने आइटम हैं?"। टूल एक फ़ंक्शन read_file है जो डिस्क के बजाय एक छोटे डिक्शनरी में देखता है। और असली मॉडल के बजाय एक स्क्रिप्टेड मॉडल है जो हमेशा वही दो काम करता है: फ़ाइल माँगो, फिर जवाब दो। हर चलते हुए हिस्से को देखने के लिए यह काफी है। इसे agent_loop.py के रूप में सहेजें (Python 3.10+, केवल मानक लाइब्रेरी):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
python agent_ चलाएँ। आपके वातावरण में LLM_API_KEY न होने पर आपको स्क्रिप्टेड मॉडल मिलता है, और स्क्रीन ठीक दो चक्कर दिखाती है:
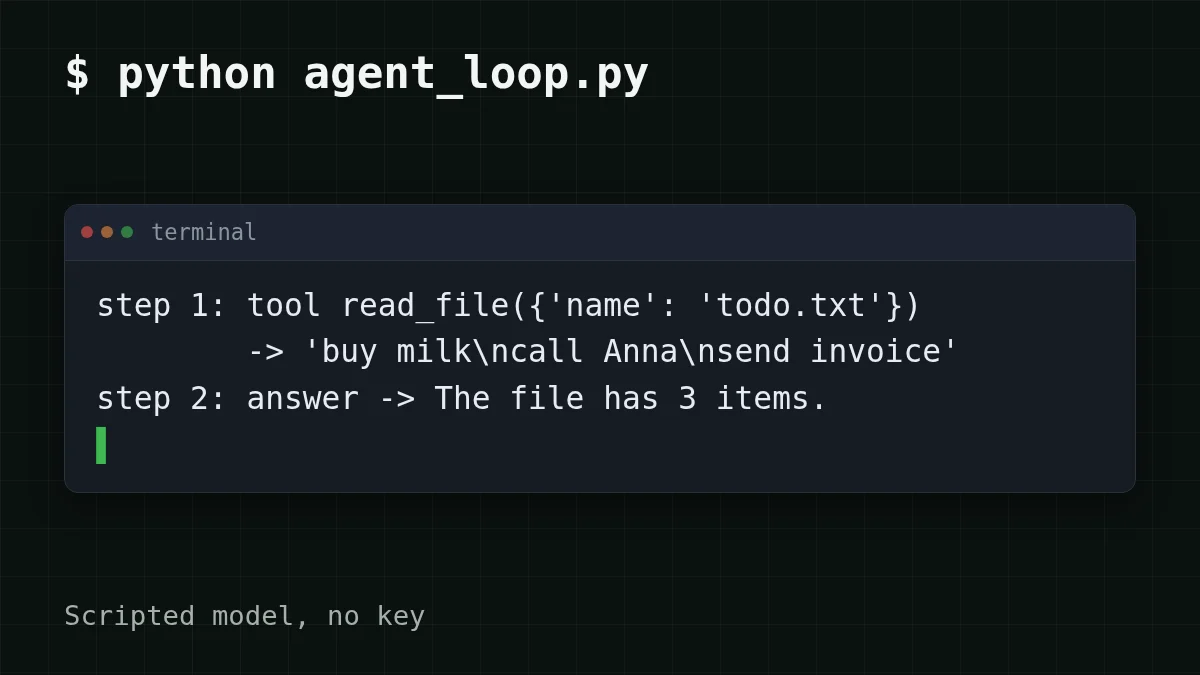
तीन पंक्तियों को देखें, क्योंकि उनमें पूरा विचार है:
messages.मॉडल की अपनी बारी रखता है। इसे छोड़ दें, और अगले कॉल में एक टूल परिणाम होगा जो उस अनुरोध का जवाब देता है जिसे API ने कभी नहीं देखा; अधिकांश API इसे 400 के साथ अस्वीकार करते हैं।append(reply) argumentsएक JSON स्ट्रिंग के रूप में आता है, इसलिए फ़ंक्शन कॉल करने से पहले यहjson.loadsसे गुज़रता है।max_stepsआपातकालीन ब्रेक है। एक मॉडल हमेशा टूल माँगता रह सकता है, इसलिए हर असली एजेंट में ऐसी सीमा होती है।
उसी लूप को असली मॉडल पर इंगित करें#
केवल एक चीज़ बदलती है: मॉडल कौन निभाता है। स्क्रिप्ट तीन पर्यावरण चर पढ़ती है, और यदि कुंजी मौजूद है तो वही messages OpenAI-संगत एंडपॉइंट पर भेजती है। CheapTokens का पता https:/ है (OpenAI Chat Completions और Anthropic Messages संगत), और मॉडल आईडी docs से पूरा होना चाहिए: deepseek-।
लूप को तीन तरीकों से चलाएँ
कोई कुंजी नहीं
python agent_loop.pyस्क्रिप्टेड मॉडल दोनों चक्कर निभाता है। आपकी मशीन से कुछ बाहर नहीं जाता।
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
380K कॉन्टेक्स्ट विंडो और प्रति उत्तर 32,768 आउटपुट टोकन तक: लंबे लूप के लिए जगह।
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
मल्टी-स्टेप लूप के पहले रन के लिए 390K कॉन्टेक्स्ट विंडो वाला हल्का मॉडल।
आपको पहले जैसा ही आकार दिखना चाहिए: step 1: tool read_, फिर step 2: answer -, प्रत्येक मॉडल कॉल के नीचे एक usage: पंक्ति के साथ। उत्तर का शब्दांकन स्क्रिप्टेड से भिन्न होगा, और एक बातूनी मॉडल एक अतिरिक्त चक्कर ले सकता है। यह सामान्य है: मॉडल तय करता है, लूप बस पालन करता है। कुंजी को स्क्रिप्ट में ही न रखें; पर्यावरण चर सुरक्षित जगह है (यहाँ इसे कैसे संग्रहीत करें)।
usage: पंक्तियाँ उपयोगी हिस्सा हैं। लंबे रन के in नंबर जोड़ें और आप देखेंगे कि पैसा कहाँ जाता है।
हर चक्कर पिछले से अधिक महंगा क्यों है#
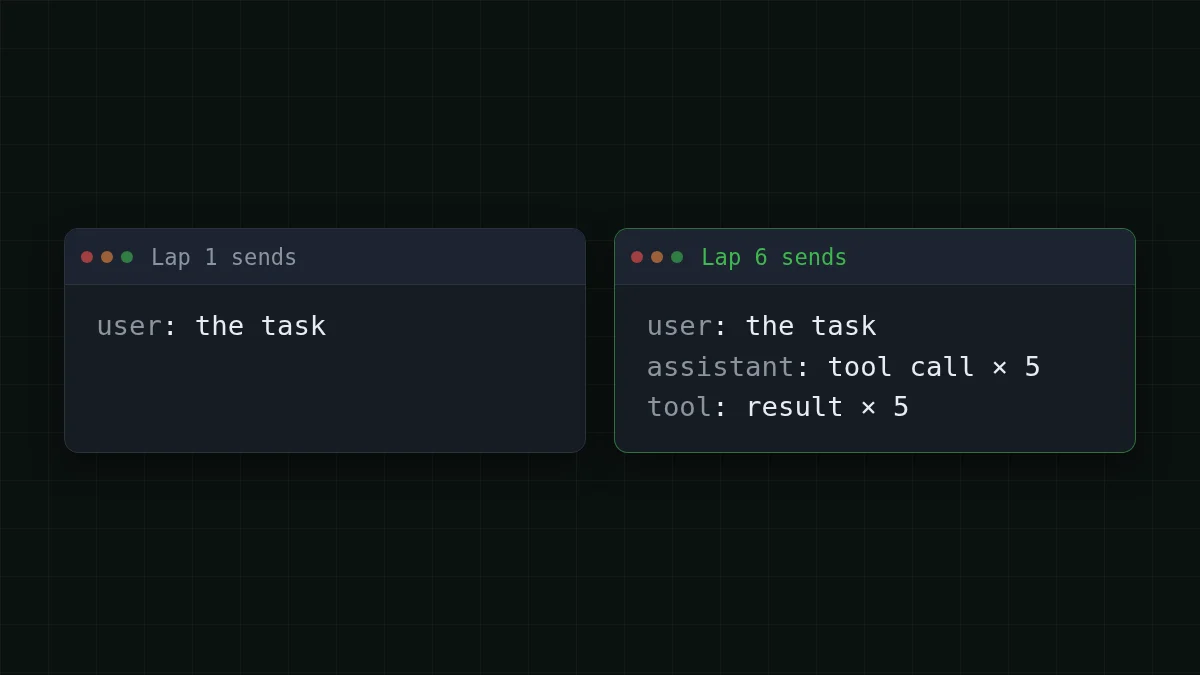
मॉडल कॉल के बीच कुछ याद नहीं रखता। प्रत्येक चक्कर पूरी messages सूची फिर से भेजता है: कार्य, हर पिछला टूल कॉल, हर टूल परिणाम। (यही नियम लंबी चैट को महंगा बनाता है; multi-turn chat इसे सादी बातचीत पर दिखाता है।)
चक्कर 1 एक संदेश भेजता है। यदि लूप चलता रहता है, तो चक्कर 6 ग्यारह भेजता है।
मान लें एक असली कार्य में 10 चक्कर लगते हैं। यह लगभग 2,000 टोकन से शुरू होता है (निर्देश, टूल सूची, आपका अनुरोध), प्रत्येक चक्कर लगभग 1,500 जोड़ता है (एक टूल परिणाम और मॉडल का नोट), और मॉडल प्रति चक्कर लगभग 300 टोकन लिखता है। चक्कर 1 2,000 भेजता है, चक्कर 2 3,500 भेजता है, चक्कर 10 15,500 भेजता है। पहले भाग का योग 10 × 2,000 = 20,000 टोकन है; वृद्धि 1,500 × 45 = 67,500 जोड़ती है (45 है 0+1+…+9), इसलिए कार्य पर इनपुट 20,000 + 67,500 = 87,500 टोकन है। आउटपुट 10 × 300 = 3,000 टोकन है।
कार्य पाठ स्वयं कुछ वाक्य हैं, फिर भी इनपुट पक्ष 87,500 टोकन है। $0.015 प्रति 1M इनपुट टोकन पर, DeepSeek-V4-Flash पर पूरा कार्य $0.0016 आता है। यहाँ संदर्भ के लिए OpenRouter के साथ, मॉडलों में वही लोड है। कुल मिलाकर, इनपुट और आउटपुट को एक साथ गिनते हुए, इस लोड पर CheapTokens OpenRouter से सस्ता निकलता है:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | लागत | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
कुल 87,500 इनपुट और 3,000 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
दिन के किसी भी समय एक ही मूल्य यहाँ भी मदद करता है: रात भर चलने वाले एजेंट की लागत दोपहर वाले के समान होती है, और आप सभी कीमतें pricing page पर देख सकते हैं। ऐसे कार्यों के एक दिन के लिए, स्लाइडर घुमाएँ:
लागत कैलकुलेटर
एक दिन: 10 चक्करों के 20 कार्य
प्रति अनुरोध इनपुट टोकन: 8,750 · प्रति अनुरोध आउटपुट टोकन: 300 · प्रति दिन अनुरोध: 200
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
फ़ील्ड प्रति मॉडल कॉल हैं: 8,750 ऊपर के उदाहरण से एक चक्कर का औसत इनपुट है (87,500 ÷ 10), और 200 कॉल 20 कार्य × 10 चक्कर हैं। यही कारण है कि एजेंट बिल इतिहास के बारे में होते हैं, प्रश्न के बारे में नहीं। 20-step example उसी प्रभाव में और गहराई से जाता है।
त्वरित जाँच
एजेंट लूप का चक्कर 3 चक्कर 1 से अधिक महंगा है, हालाँकि आपने कुछ नया नहीं पूछा। क्यों?
उत्तर दिखाएँ
उत्तर: संदेश सूची में अब दो टूल कॉल और दो परिणाम हैं, और यह सब फिर से भेजा जाता है
API स्टेटलेस है। प्रत्येक कॉल पूरा इतिहास ले जाता है, इसलिए इनपुट टोकन प्रत्येक चक्कर के साथ बढ़ते हैं जबकि आउटपुट लगभग समान रहता है।
40 पंक्तियों से आगे कहाँ जाएँ#
ऊपर की स्क्रिप्ट सीखने के लिए एक रेखाचित्र है। यदि आप लंबा संस्करण चाहते हैं, तो GitHub पर एक खुला कोर्स है, justxor/agent-harness-course (README रूसी में, 31 अक्टूबर 2026 को जाँचा गया)। यह सादा Python 3.10+ है बिना किसी निर्भरता के, कोड MIT-लाइसेंस प्राप्त है, पाठ CC BY 4.0 है। क्लोन करने के बाद, python examples/ लूप को स्क्रिप्टेड मॉडल के साथ ऑफ़लाइन चलाता है, और python - इसके 19 टेस्ट नेटवर्क के बिना चलाता है। कोर्स कॉन्टेक्स्ट कम्पैक्शन, मेमोरी, सबएजेंट, जोखिम भरे कार्यों की मानव स्वीकृति, और लागत ट्रैकिंग के साथ जारी रहता है। असली मॉडल के लिए यह LLM_PROVIDER, LLM_MODEL, LLM_API_KEY पढ़ता है और, OpenAI-संगत एंडपॉइंट के लिए, LLM_BASE_URL: इसके README से सटीक LLM_PROVIDER मान लें।
जब लूप काम करता है, तो अगला कदम एक असली कुंजी और एक असली कार्य है: docs में एक मिनट में पहला अनुरोध है, और DeepSeek-V4-Flash लूप चलाने के लिए एक अच्छा मॉडल है।


