AI per principiantiGuida
Come funziona un agente AI: il ciclo, eseguito senza chiave API
Un agente AI è un ciclo: il modello chiede un tool, il tuo codice lo esegue, il risultato torna indietro. Esegui una demo Python senza chiave, poi puntala a un modello reale.
In questa pagina
Chiedi a un agente di coding di correggere un refuso e guardi il log scorrere: leggi un file, cerca, leggi un altro file, modifica, esegui i test. Una piccola richiesta, una dozzina di chiamate al modello. Da dove vengono?
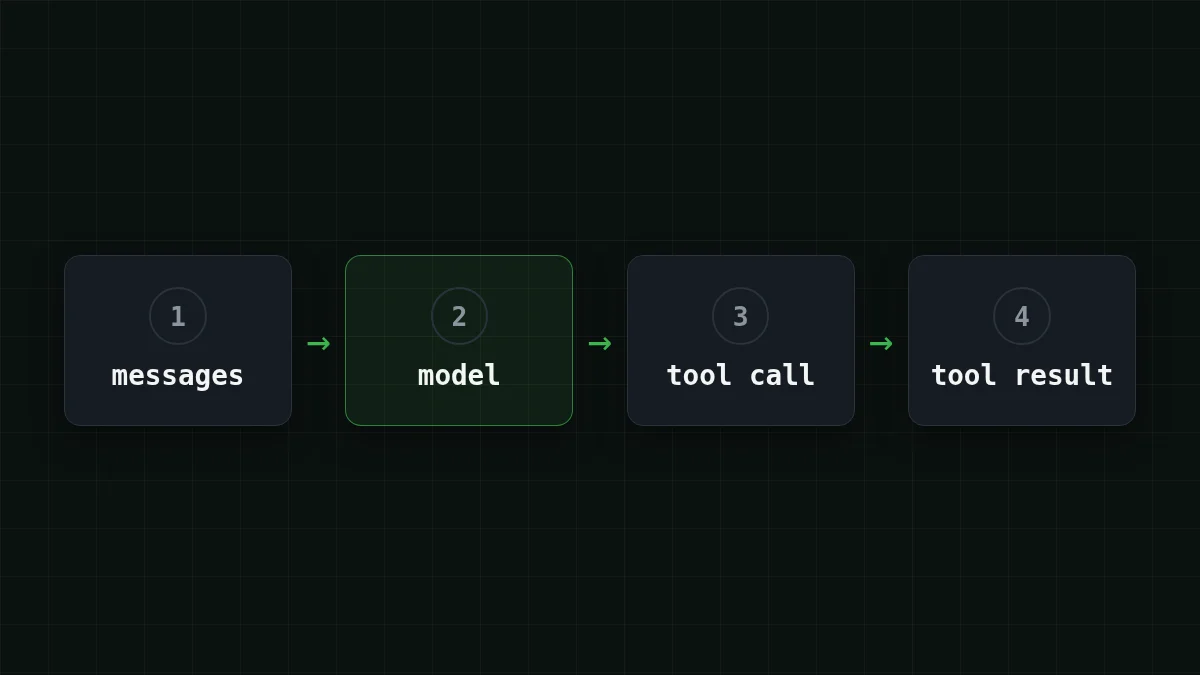
Un agente AI è un ciclo. Il tuo programma invia la conversazione al modello; il modello o risponde o chiede un tool ("leggi questo file"); il tuo programma esegue il tool, aggiunge il risultato alla conversazione e chiama di nuovo il modello. Si ripete finché il modello non risponde in testo semplice. Gli agenti di coding come Claude Code, Codex e la modalità agente di Cursor sono costruiti attorno a questo stesso ciclo, con più tool e più attenzione. Qui sotto eseguirai una versione di 40 righe senza alcuna chiave, poi la punterai a un modello reale.
Il ciclo in un'immagine#
Pensa a un manager che non può toccare nulla. Il manager scrive solo note: "per favore portami todo.txt". Un assistente (il tuo programma) va allo scaffale, prende il file e lo mette sulla scrivania. Il manager lo legge e scrive la nota successiva, o la risposta finale.
Questo è tutto il trucco. Il modello non apre mai un file né esegue un comando. Scrive testo che dice quale tool chiamare e con quali argomenti. Il tuo codice fa il lavoro e riporta indietro. Se hai visto function calling, è lo stesso meccanismo, ripetuto finché il lavoro non è finito.
Riesci a mettere un giro del ciclo nell'ordine giusto?
Metti in ordine
Metti in ordine un giro del ciclo dell'agente
Trascina gli elementi o usa le frecce
- Invia il compito e la lista dei tool al modello
- Il modello risponde con una chiamata a un tool, non con testo
- Il tuo programma esegue quel tool da solo
- Il risultato entra nei messaggi come messaggio "tool"
- Il modello viene chiamato di nuovo con il risultato, finché non risponde in testo semplice
Eseguilo senza chiave#
Supponiamo che il compito sia: "Quanti elementi ci sono in todo.txt?". Il tool è una funzione read_file che cerca in un piccolo dizionario invece che su disco. E invece di un modello reale c'è uno scriptato che fa sempre le stesse due cose: chiede il file, poi risponde. Basta per vedere ogni componente in movimento. Salvalo come agent_loop.py (Python 3.10+, solo libreria standard):
import json, os, urllib.request

NOTES = {"todo.txt": "buy milk\ncall Anna\nsend invoice"}

def read_file(name):
    return NOTES.get(name, "no such file")

TOOLS = {"read_file": read_file}
TOOL_SPECS = [{"type": "function", "function": {
    "name": "read_file", "description": "Read a note by file name",
    "parameters": {"type": "object",
                   "properties": {"name": {"type": "string"}},
                   "required": ["name"]}}}]

def scripted_model(messages):
    if messages[-1]["role"] == "user":      # first lap: ask for the file
        return {"role": "assistant", "content": None, "tool_calls": [{
            "id": "call_1", "type": "function",
            "function": {"name": "read_file",
                         "arguments": "{\"name\": \"todo.txt\"}"}}]}
    return {"role": "assistant", "content": "The file has 3 items."}

def real_model(messages):
    body = {"model": os.environ["LLM_MODEL"], "messages": messages,
            "tools": TOOL_SPECS}
    req = urllib.request.Request(
        os.environ["LLM_BASE_URL"] + "/chat/completions",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json",
                 "User-Agent": "agent-loop-demo/1.0",
                 "Authorization": "Bearer " + os.environ["LLM_API_KEY"]})
    with urllib.request.urlopen(req) as resp:
        data = json.load(resp)
    u = data["usage"]
    print("  usage: in", u["prompt_tokens"], "out", u["completion_tokens"])
    return data["choices"][0]["message"]

def run(task, model, max_steps=8):
    messages = [{"role": "user", "content": task}]
    for step in range(1, max_steps + 1):
        reply = model(messages)
        messages.append(reply)              # keep the model's turn in history
        calls = reply.get("tool_calls")
        if not calls:
            print(f"step {step}: answer -> {reply['content']}")
            return
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            result = TOOLS[name](**args)    # YOUR code does the work
            print(f"step {step}: tool {name}({args}) -> {result!r}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": result})
    print("stopped: max_steps reached")

model = real_model if os.environ.get("LLM_API_KEY") else scripted_model
run("How many items are in todo.txt?", model)
Esegui python agent_. Senza LLM_API_KEY nel tuo ambiente ottieni il modello scriptato, e lo schermo mostra esattamente due giri:
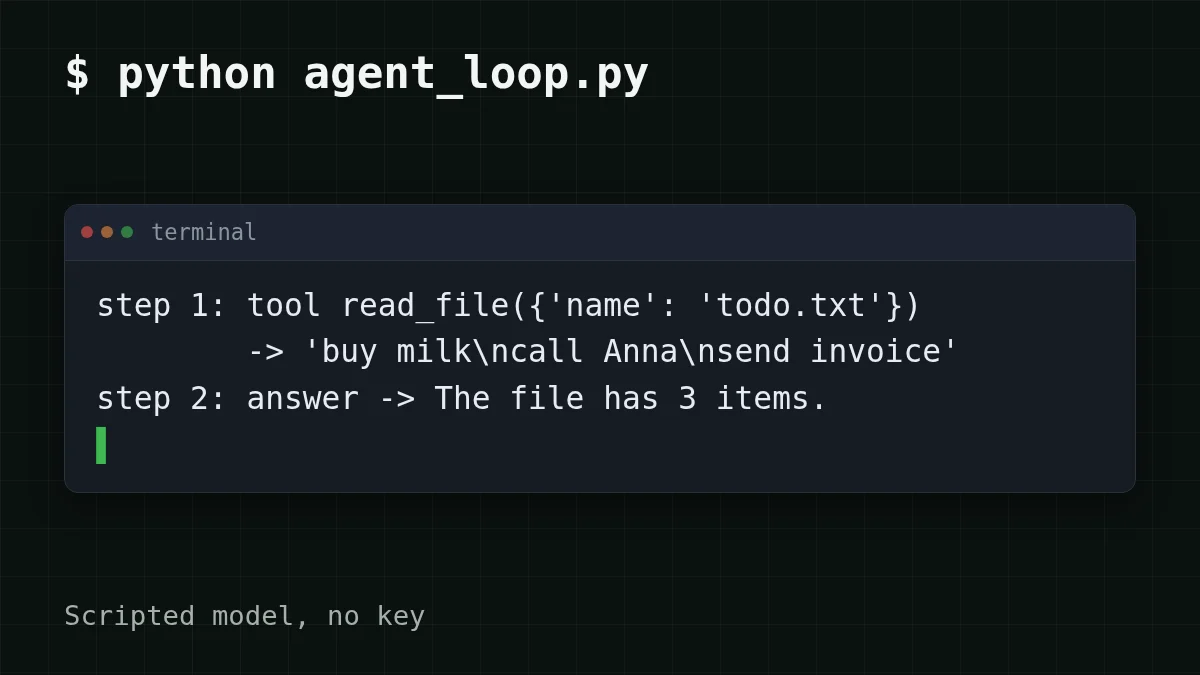
Guarda tre righe, perché contengono l'intera idea:
messages.conserva il turno del modello stesso. Saltalo, e la chiamata successiva contiene un risultato tool che risponde a una richiesta che l'API non ha mai visto; la maggior parte delle API lo rifiuta con un 400.append(reply) argumentsarriva come stringa JSON, quindi passa attraversojson.loadsprima di chiamare la funzione.max_stepsè il freno di emergenza. Un modello può continuare a chiedere tool all'infinito, quindi ogni agente reale ha un limite come questo.
Punta lo stesso ciclo a un modello reale#
Cambia solo una cosa: chi interpreta il modello. Lo script legge tre variabili d'ambiente, e se è presente una chiave invia lo stesso messages a un endpoint compatibile OpenAI. L'indirizzo CheapTokens è https:/ (compatibile con OpenAI Chat Completions e Anthropic Messages), e l'id del modello deve essere quello completo dalla documentazione: deepseek-.
Esegui il ciclo in tre modi
Nessuna chiave
python agent_loop.pyIl modello scriptato recita entrambi i giri. Nulla esce dalla tua macchina.
DeepSeek-V4-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=deepseek-ai/DeepSeek-V4-Flash-0731
python agent_loop.py
Una finestra di contesto di 380K e fino a 32.768 token di output per risposta: spazio per un ciclo lungo.
GLM-5.3-Flash
export LLM_BASE_URL=https://api.cheaptokens.dev/v1
export LLM_API_KEY=<your key>
export LLM_MODEL=zai-org/GLM-5.3-Flash
python agent_loop.py
Un modello leggero con una finestra di contesto di 390K per una prima esecuzione di un ciclo multi-step.
Quello che dovresti vedere è la stessa forma di prima: step 1: tool read_, poi step 2: answer -, con una riga usage: sotto ogni chiamata al modello. La formulazione della risposta sarà diversa da quella scriptata, e un modello chiacchierone può fare un giro in più. È normale: il modello decide, il ciclo obbedisce. Tieni la chiave fuori dallo script stesso; una variabile d'ambiente è il posto sicuro (ecco come memorizzarla).
Le righe usage: sono la parte utile. Aggiungi i numeri in di un'esecuzione più lunga e vedrai dove vanno i soldi.
Perché ogni giro costa più del precedente#
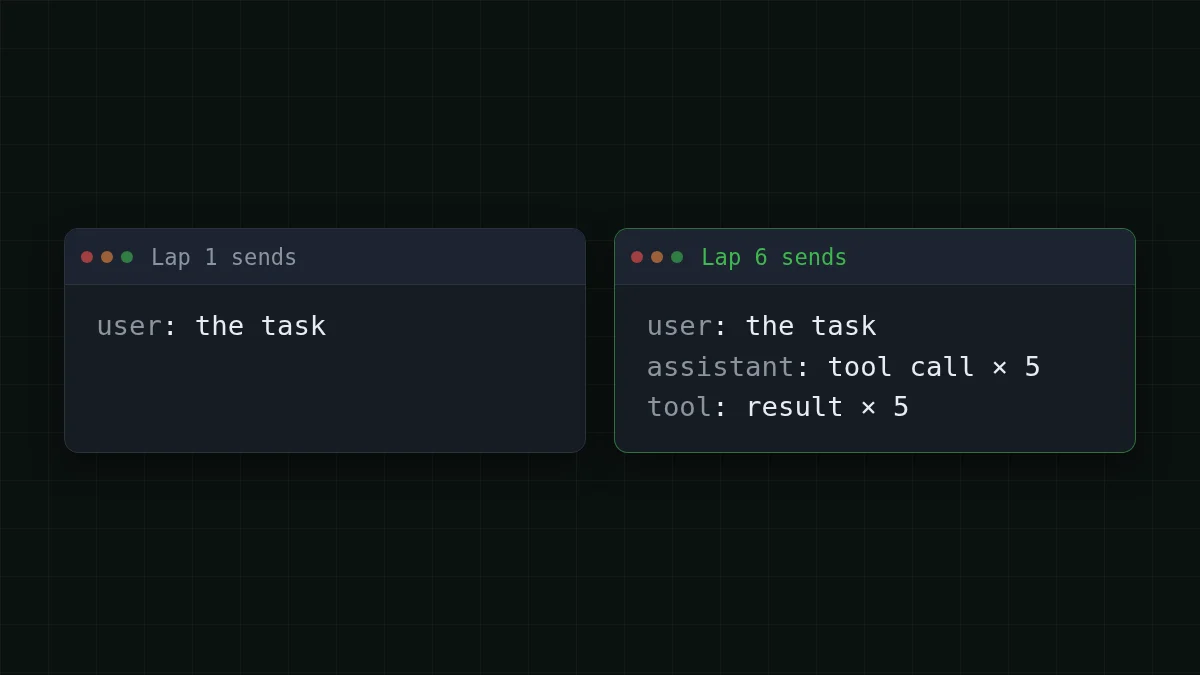
Il modello non ricorda nulla tra una chiamata e l'altra. Ogni giro invia di nuovo l'intera lista messages: il compito, ogni chiamata tool precedente, ogni risultato tool. (La stessa regola rende costosa una chat lunga; chat multi-turno lo mostra su una conversazione semplice.)
Il giro 1 invia un messaggio. Se il ciclo continua, il giro 6 ne invia undici.
Diciamo che un compito reale richieda 10 giri. Inizia con circa 2.000 token (istruzioni, lista dei tool, la tua richiesta), ogni giro aggiunge circa 1.500 (un risultato tool più la nota del modello), e il modello scrive circa 300 token per giro. Il giro 1 invia 2.000, il giro 2 invia 3.500, il giro 10 invia 15.500. La somma della prima parte è 10 × 2.000 = 20.000 token; la crescita aggiunge 1.500 × 45 = 67.500 (45 è 0+1+…+9), quindi l'input sul compito è 20.000 + 67.500 = 87.500 token. L'output è 10 × 300 = 3.000 token.
Il testo del compito è di poche frasi, eppure il lato input è di 87.500 token. A $0.015 per 1M token di input, l'intero compito su DeepSeek-V4-Flash arriva a $0.0016. Ecco lo stesso carico tra i modelli, con OpenRouter come riferimento. In totale, contando input e output insieme, CheapTokens risulta più economico di OpenRouter su questo carico:
| Modello | Input $/1M | Output $/1M | Costo | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0019 | $0.0038 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0016 | $0.0046 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0048 | $0.0299 |
87.500 token di input e 3000 token di output in totale. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Un prezzo unico a qualsiasi ora del giorno aiuta anche qui: un agente che gira di notte costa come uno a mezzogiorno, e puoi vedere tutti i prezzi sulla pagina dei prezzi. Per una giornata di tali compiti, muovi gli slider:
Calcolatore di costi
Una giornata: 20 compiti da 10 giri ciascuno
Token di input per richiesta: 8750 · Token di output per richiesta: 300 · Richieste al giorno: 200
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0374 | $1.12 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0323 | $0.968 |
| MiniMax-M2.7$0.05$0.15 | $0.0965 | $2.90 |
I campi sono per chiamata al modello: 8.750 è l'input medio di un giro dell'esempio sopra (87.500 ÷ 10), e 200 chiamate sono 20 compiti × 10 giri. Ecco perché le bollette degli agenti riguardano la cronologia, non la domanda. L'esempio a 20 passi approfondisce lo stesso effetto.
Verifica rapida
Il giro 3 di un ciclo dell'agente costa più del giro 1, anche se non hai chiesto nulla di nuovo. Perché?
Mostra risposta
Risposta: La lista dei messaggi ora contiene due chiamate tool e due risultati, e tutto viene inviato di nuovo
L'API è stateless. Ogni chiamata porta con sé la cronologia completa, quindi i token di input crescono a ogni giro mentre l'output resta più o meno lo stesso.
Da dove andare dalle 40 righe#
Lo script sopra è uno schizzo per imparare. Se vuoi la versione lunga, c'è un corso aperto su GitHub, justxor/agent-harness-course (README in russo, verificato il 31 ottobre 2026). È Python 3.10+ puro senza dipendenze, il codice è con licenza MIT, il testo è CC BY 4.0. Dopo il clone, python examples/ esegue il ciclo offline con un modello scriptato, e python - esegue i suoi 19 test senza rete. Il corso continua con la compattazione del contesto, la memoria, i subagenti, l'approvazione umana delle azioni rischiose e il monitoraggio dei costi. Per un modello reale legge LLM_PROVIDER, LLM_MODEL, LLM_API_KEY e, per gli endpoint compatibili OpenAI, LLM_BASE_URL: prendi il valore esatto di LLM_PROVIDER dal suo README.
Quando il ciclo funziona, il passo successivo è una chiave reale e un compito reale: la documentazione ha una prima richiesta in un minuto, e DeepSeek-V4-Flash è un buon modello su cui eseguire il ciclo.


