Pierwsze krokiPrzewodnik
Czat wieloturny z API: ponowne wysyłanie tablicy messages
Model nie pamięta niczego między żądaniami. Zbuduj pętlę czatu w Pythonie, która ponownie wysyła tablicę messages, i zobacz, jak rosną tokeny wejściowe.
Na tej stronie
Twoje drugie pytanie dostaje dziwną odpowiedź, bo API nigdy nie widziało pierwszego. Model nie zachowuje niczego między żądaniami, więc czat to coś, co ty budujesz: po każdej odpowiedzi dopisujesz ją do listy zwanej messages i wysyłasz całą listę ponownie. Na tym polega cała sztuczka, a poniżej znajduje się działająca pętla w Pythonie dla niej przeciwko API CheapTokens zgodnemu z OpenAI.
Dwie oficjalne dokumentacje opisują to samo. Dokumentacja Messages API Anthropic (sprawdzona 30 października 2026) nazywa API bezstanowym i wieloturnym: wcześniejsze tury podróżują w parametrze messages. Przewodnik OpenAI po generowaniu tekstu (sprawdzony 30 października 2026) mówi, aby zachować kontekst, wysyłając wcześniejsze tury jako wiadomości z tagami ról i dopisując każdą odpowiedź przed następnym żądaniem.
Dlaczego drugie pytanie dostaje pusty wzrok#
Załóżmy, że wpisujesz What is a token?, czytasz odpowiedź, a potem wpisujesz Explain it shorter. Dla ciebie "to" jest oczywiste. Dla API żądanie numer dwa to jednolinijkowa wiadomość od obcego: nie ma żadnego "to", nie ma czego skracać. Dostaniesz zgadywanie albo pytanie z powrotem, a nie krótsze wyjaśnienie.
Rozwiązaniem jest sprawienie, by żądanie drugie niosło wszystko, co miało żądanie pierwsze, plus odpowiedź, plus nowe pytanie. Porównaj oba payloady:
Porównaj
Żądanie 2, z historią i bez niej
Bez historii
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
Model nie ma pojęcia, czym jest "to".
Z historią
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
Teraz "to" wskazuje na pierwszą odpowiedź.
Trzy role robią całą robotę. system ustawia zasady raz (ton, długość, do czego służy bot). user to, co wpisała osoba. assistant to, co model powiedział wcześniej. Model czyta listę od góry do dołu i pisze następną wiadomość assistant.
Pętla czatu w kilku linijkach#
Zainstaluj SDK za pomocą pip install openai i trzymaj klucz w zmiennej środowiskowej, jak w jak bezpiecznie przechowywać klucz API. Bazowy URL i identyfikator modelu pochodzą z dokumentacji CheapTokens i GET /v1/models (więcej w wylistowanie modeli, aby znaleźć dokładny identyfikator). Do pętli uczącej GLM-5.3-Flash dobrze pasuje: kontekst 390K i do 8 192 tokenów wyjściowych na odpowiedź.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
Uruchom to, zapytaj What is a token?, potem Explain it shorter. Druga odpowiedź odnosi się teraz do pierwszej. Ostatnia linia wypisuje usage., stronę wejściową rachunku za tę turę; obserwuj, jak rośnie z każdym pytaniem.
Kolejność wewnątrz pętli ma znaczenie i to jest część, w której początkujący mylą się najczęściej:
Ustaw w kolejności
Ułóż jedną turę pętli w kolejności
Przeciągnij elementy lub użyj strzałek
- Dopisz pytanie użytkownika do messages
- Wyślij całą listę messages
- Odczytaj odpowiedź z response
- Dopisz odpowiedź jako wiadomość assistant
Pomiń krok 4, a model zapomni własnych odpowiedzi, więc "wyjaśnij to krócej" zadziała raz, a potem znowu się zepsuje przy trzecim pytaniu.
Jak wygląda lista po dwóch turach#
Po What is a token? i Explain it shorter lista, którą trzyma twój kod, ma pięć pozycji: regułę systemową, pierwsze pytanie, pierwszą odpowiedź, drugie pytanie, drugą odpowiedź. Następne żądanie wyśle wszystkie pięć plus trzecie pytanie.
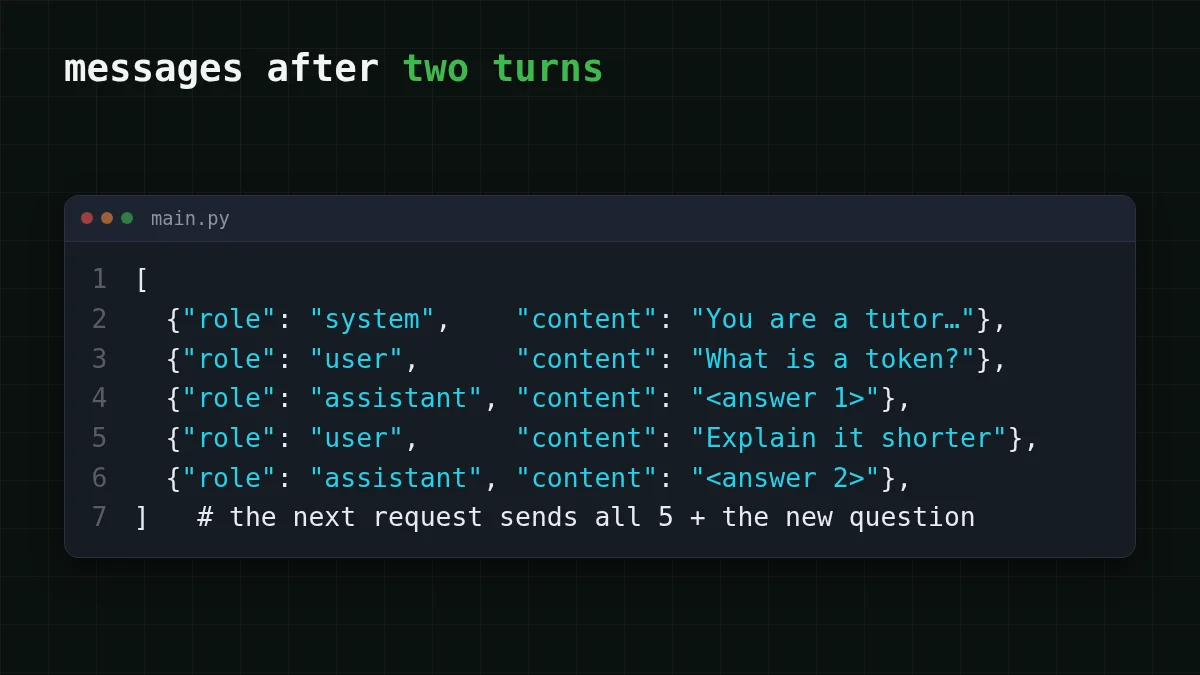
Wiadomość systemowa jest wysyłana za każdym razem. API nie "trzyma" jej po swojej stronie; to po prostu pierwsza pozycja listy. Przewodnik OpenAI (sprawdzony 30 października 2026) zauważa, że instrukcje dotyczą tylko bieżącego żądania, co jest tą samą ideą z drugiej strony. Jeśli chcesz dostroić tę pierwszą wiadomość, zobacz system prompt i temperatura wyjaśnione.
Co dzieje się z tokenami wejściowymi, gdy czat rośnie#
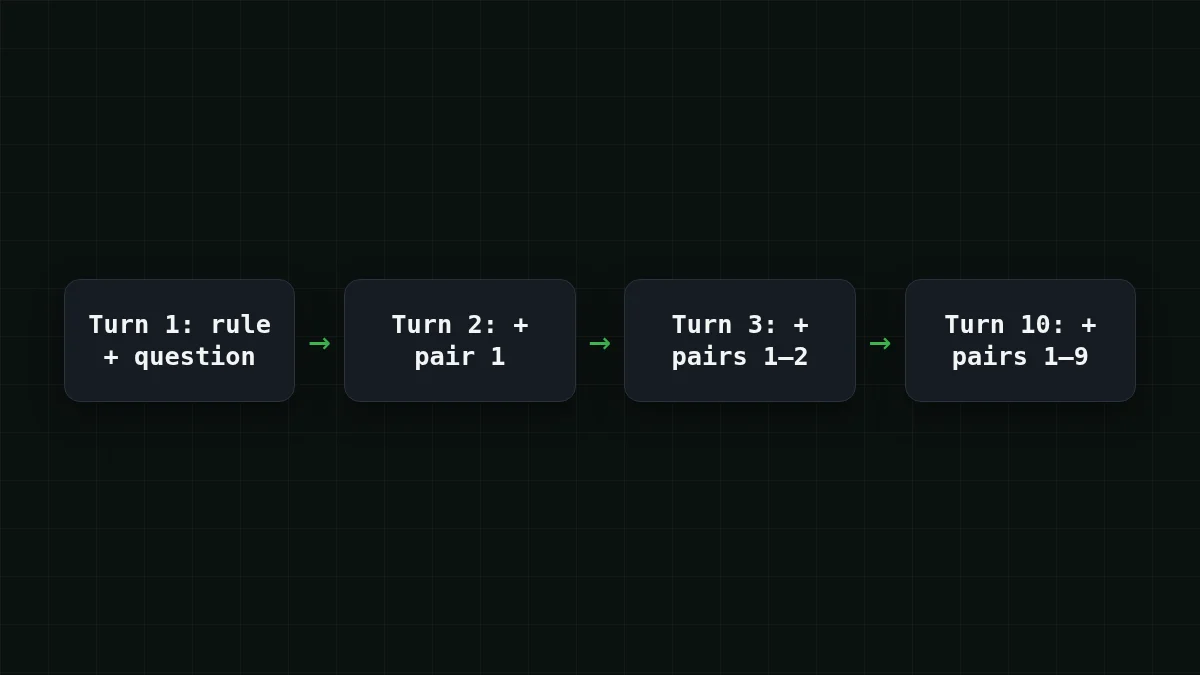
Każde żądanie płaci za całą listę ponownie jako wejście. Tura 1 wysyła regułę systemową i jedno pytanie; tura 10 wysyła regułę, dziewięć wcześniejszych par pytanie-odpowiedź i nowe pytanie. Więc wejście rośnie z każdą turą, nawet jeśli każda z twoich wiadomości jest krótka.
Załóżmy 10-turnowy czat z tymi założeniami: reguła systemowa to około 50 tokenów, każde pytanie około 150, każda odpowiedź około 250. Tura 1 wysyła 50 + 150 = 200 tokenów wejściowych. Każda późniejsza tura dodaje kolejną parę 400 tokenów (150 + 250 = 400), więc całkowite wejście przez dziesięć tur to 200 × 10 + 400 × 45 = 20 000 tokenów, gdzie 45 to 0 + 1 + … + 9. Wyjście to 250 × 10 = 2 500 tokenów. Dziesięć wiadomości od ciebie, a wejście jest osiem razy większe niż wyjście.
Oto cały ten czat wyceniony według aktualnych stawek, 20 000 tokenów wejściowych i 2 500 wyjściowych:
| Model | Wejście $/1M | Wyjście $/1M | Koszt | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
20 000 tokenów wejściowych i 2500 tokenów wyjściowych łącznie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
W sumie, licząc wejście i wyjście razem, GLM-5.3-Flash i DeepSeek-V4-Flash kosztują tutaj mniej niż w OpenRouter, a oba utrzymują jedną cenę o każdej porze. Jeśli chcesz odpowiedzi dłuższe niż 8 192 tokeny w tej samej pętli czatu, DeepSeek-V4-Flash pozwala na do 32 768 tokenów wyjściowych na odpowiedź przy kontekście 380K; zamień identyfikator modelu na deepseek- i nic więcej w pętli się nie zmienia.
Głębsza historia kosztów jest w dlaczego długi czat AI kosztuje więcej; tokeny wejściowe vs wyjściowe wyjaśnia, dlaczego obie strony są wyceniane osobno.
Szybkie sprawdzenie
Twój czat jest w turze 8. Co zawiera żądanie dla tury 8?
Pokaż odpowiedź
Odpowiedź: Wiadomość systemowa i każde wcześniejsze pytanie i odpowiedź, plus najnowsze pytanie
API nic nie pamięta, więc pełna lista wychodzi za każdym razem. To także dlatego tokeny wejściowe rosną tura po turze.
Utrzymanie długiego czatu pod kontrolą#
Lista nie może rosnąć w nieskończoność: musi zmieścić się w oknie kontekstu modelu (zobacz czym jest okno kontekstu), a każda dodatkowa tura kosztuje wejście. Dwa nawyki utrzymują ją w ryzach dla prototypu:
- Przytnij najstarsze tury. Zachowaj wiadomość systemową i kilka ostatnich par, na przykład
messages = messages[:1] + messages[-przed każdym żądaniem. Usuwaj pary razem, aby pytanie nigdy nie straciło swojej odpowiedzi.8:] - Zacznij świeżą listę dla nowego tematu. Nowe zadanie nie potrzebuje historii starego.
Bot wsparcia z długotrwałym zestawem reguł to ta sama pętla: wiadomość systemowa ustawia zasady raz, każda tura użytkownika i odpowiedź są dopisywane, a ty przycinasz, gdy lista staje się ciężka. Dla samego pierwszego żądania zobacz twoje pierwsze żądanie API z CheapTokens; lista modeli i ceny są na stronie cenowej.


