BaşlarkenKılavuz
Bir API ile çok turlu sohbet: messages dizisini yeniden gönderin
Model istekler arasında hiçbir şey hatırlamaz. messages dizisini yeniden gönderen bir Python sohbet döngüsü kurun ve giriş token'larının nasıl büyüdüğünü görün.
Bu sayfada
İkinci sorunuza garip bir yanıt alırsınız çünkü API ilk sorunuzu hiç görmedi. Model istekler arasında hiçbir şey tutmaz, yani sohbet sizin kurduğunuz bir şeydir: her yanıttan sonra onu messages adlı bir listeye eklersiniz ve tüm listeyi tekrar gönderirsiniz. Bütün hile bundan ibaret ve aşağıda CheapTokens'in OpenAI uyumlu API'sine karşı çalışan bir Python döngüsü var.
İki resmi doküman aynı şeyi anlatır. Anthropic'in Messages API referansı (30 Ekim 2026'da kontrol edildi) API'yi durumsuz ve çok turlu olarak adlandırır: önceki turlar messages parametresinde gider. OpenAI'nin metin üretimi kılavuzu (30 Ekim 2026'da kontrol edildi) bağlamı korumak için önceki turları rol etiketli mesajlar olarak göndermenizi ve her yanıtı bir sonraki istekten önce eklemenizi söyler.
İkinci soru neden boş bir bakışla karşılanır#
Diyelim ki What is a token? yazdınız, yanıtı okudunuz ve sonra Explain it shorter yazdınız. Size göre "o" apaçıktır. API'ye göre ikinci istek bir yabancının tek satırlık mesajıdır: ortada "o" yok, kısaltılacak bir şey yok. Kısa bir açıklama değil, bir tahmin ya da bir soru alırsınız.
Çözüm, ikinci isteğin birinci istekteki her şeyi, artı yanıtı, artı yeni soruyu taşımasını sağlamaktır. İki yükü karşılaştırın:
Karşılaştır
İstek 2, geçmişli ve geçmişsiz
Geçmişsiz
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
Modelin "o"nun ne olduğuna dair hiçbir fikri yoktur.
Geçmişli
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
Artık "o" ilk yanıta işaret eder.
Bütün işi üç rol yapar. system kuralları bir kez belirler (ton, uzunluk, botun ne için olduğu). user kişinin yazdığıdır. assistant modelin daha önce söylediğidir. Model listeyi baştan sona okur ve bir sonraki assistant mesajını yazar.
Birkaç satırda sohbet döngüsü#
SDK'yı pip install openai ile kurun ve anahtarınızı bir ortam değişkeninde tutun, tıpkı bir API anahtarı nasıl güvenle saklanır yazısındaki gibi. Temel URL ve model kimliği CheapTokens dokümanlarından ve GET /v1/models'ten gelir (daha fazlası tam kimliği bulmak için modelleri listeleme yazısında). Bir öğrenme döngüsü için GLM-5.3-Flash iyi bir seçimdir: 390K bağlam ve yanıt başına 8.192'ye kadar çıktı token'ı.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
Çalıştırın, What is a token? sorun, sonra Explain it shorter. İkinci yanıt artık birinciye atıfta bulunur. Son satır usage. yazdırır, yani o tur için faturanın giriş tarafını; her soruyla birlikte yükseldiğini izleyin.
Döngü içindeki sıra önemlidir ve yeni başlayanların en sık yanlış yaptığı kısım budur:
Sıraya koy
Döngünün bir turunu sıraya koyun
Öğeleri sürükle veya okları kullan
- Kullanıcının sorusunu messages'a ekle
- Tüm messages listesini gönder
- Yanıtı yanıttan oku
- Yanıtı bir assistant mesajı olarak ekle
4. adımı atlarsanız model kendi yanıtlarını unutur, böylece "daha kısa açıkla" bir kez çalışır ve üçüncü soruda yine bozulur.
Liste iki turdan sonra nasıl görünür#
What is a token? ve Explain it shorter sonrasında kodunuzun tuttuğu listede beş girdi vardır: sistem kuralı, ilk soru, ilk yanıt, ikinci soru, ikinci yanıt. Bir sonraki istek bu beşinin tamamını artı üçüncü soruyu gönderecektir.
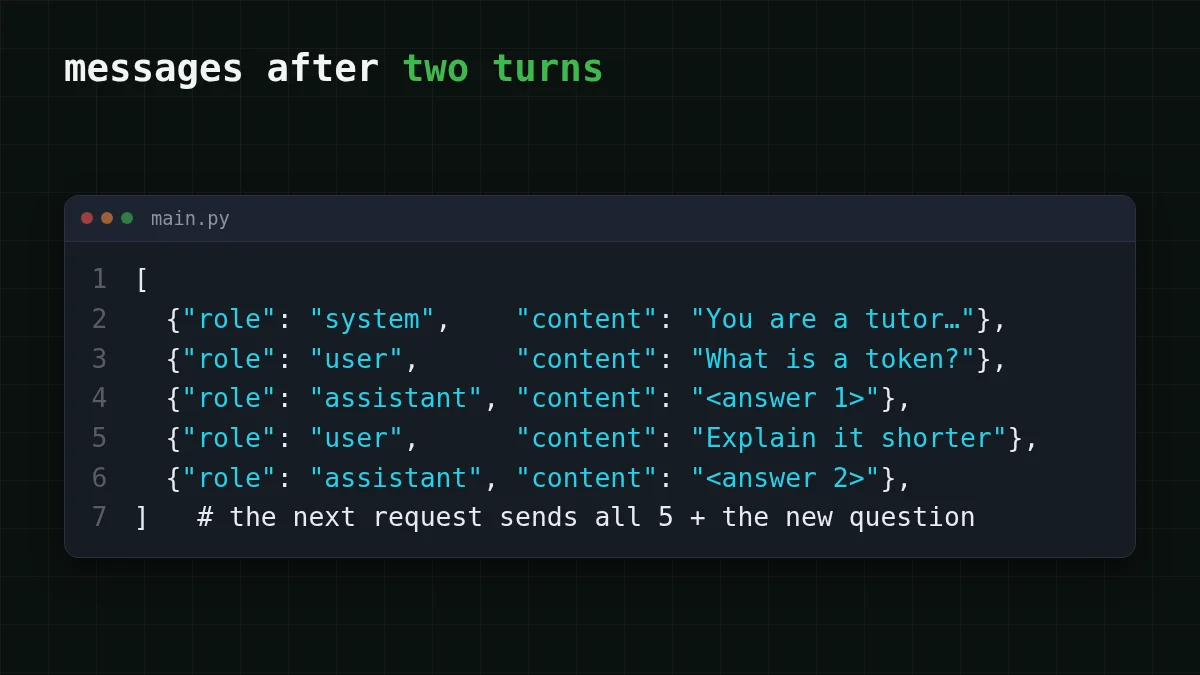
Sistem mesajı her seferinde gönderilir. API onu kendi tarafında "tutmaz"; o yalnızca listenin ilk öğesidir. OpenAI'nin kılavuzu (30 Ekim 2026'da kontrol edildi) talimatların yalnızca geçerli istek için geçerli olduğunu belirtir, bu da aynı fikrin diğer yönden ifadesidir. Bu ilk mesajı ayarlamak isterseniz system prompt ve temperature açıklaması yazısına bakın.
Sohbet büyüdükçe giriş token'larına ne olur#
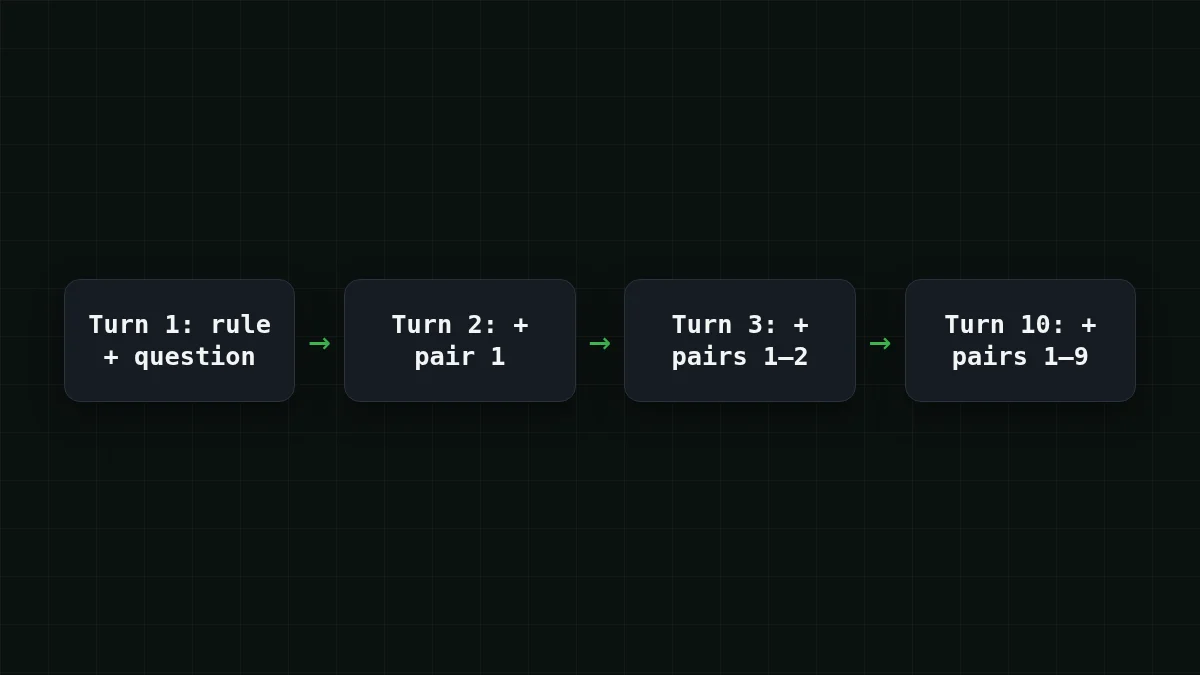
Her istek tüm liste için giriş olarak tekrar öder. 1. tur sistem kuralını ve bir soruyu gönderir; 10. tur kuralı, dokuz önceki soru-cevap çiftini ve yeni soruyu gönderir. Yani mesajlarınızın her biri kısa olsa bile giriş her turda büyür.
Bu varsayımlarla 10 turluk bir sohbet düşünün: sistem kuralı yaklaşık 50 token, her soru yaklaşık 150, her yanıt yaklaşık 250. 1. tur 50 + 150 = 200 giriş token'ı gönderir. Sonraki her tur bir 400 token'lık çift daha ekler (150 + 250 = 400), böylece on tur boyunca toplam giriş 200 × 10 + 400 × 45 = 20.000 token olur, burada 45 = 0 + 1 + … + 9'dur. Çıktı 250 × 10 = 2.500 token'dır. Sizden on mesaj ve giriş, çıktının sekiz katı.
İşte bu sohbetin tamamı canlı fiyatlarla, 20.000 token giriş ve 2.500 çıkış:
| Model | Giriş $/1M | Çıkış $/1M | Maliyet | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
Toplamda 20.000 giriş ve 2.500 çıkış token'ı. 1M token başına fiyatlar günceldir ve tarifelerimizle birlikte değişir; OpenRouter sütunu aynı iş yükü için referans fiyatları gösterir.
Giriş ve çıktı birlikte sayıldığında toplamda GLM-5.3-Flash ve DeepSeek-V4-Flash burada OpenRouter'dakinden daha ucuza gelir ve ikisi de her saatte tek fiyat korur. Aynı sohbet döngüsünde 8.192 token'dan uzun yanıtlar istiyorsanız DeepSeek-V4-Flash, 380K bağlamla yanıt başına 32.768'e kadar çıktı token'ına izin verir; model kimliğini deepseek- ile değiştirin, döngüde başka hiçbir şey değişmez.
Maliyetin daha derin hikâyesi uzun bir AI sohbeti neden daha pahalıdır yazısında; giriş ve çıktı token'ları iki tarafın neden ayrı fiyatlandırıldığını açıklar.
Hızlı kontrol
Sohbetiniz 8. turda. 8. tur için istek ne içerir?
Cevabı göster
Cevap: Sistem mesajı ve önceki tüm soru ve yanıtlar, artı en yeni soru
API hiçbir şey hatırlamaz, bu yüzden her seferinde tam liste gönderilir. Giriş token'larının turdan tura yükselmesinin nedeni de budur.
Uzun bir sohbeti kontrol altında tutmak#
Liste sonsuza kadar büyüyemez: modelin bağlam penceresine sığmalıdır (bağlam penceresi nedir yazısına bakın) ve her ek tur giriş maliyeti getirir. Bir prototip için iki alışkanlık bunu makul tutar:
- En eski turları kırpın. Sistem mesajını ve son birkaç çifti tutun, örneğin her istekten önce
messages = messages[:1] + messages[-. Çiftleri birlikte atın ki bir soru asla yanıtını kaybetmesin.8:] - Yeni bir konu için yeni bir liste başlatın. Yeni bir görev, eskisinin geçmişine ihtiyaç duymaz.
Uzun ömürlü bir kural setine sahip bir destek botu da aynı döngüdür: sistem mesajı kuralları bir kez belirler, her kullanıcı turu ve yanıtı eklenir ve liste ağırlaştığında kırpma yaparsınız. İlk isteğin kendisi için CheapTokens ile ilk API isteğiniz yazısına bakın; model listesi ve fiyatlar fiyatlandırma sayfasında.


